01
粘贴一条 header,或载入边界示例
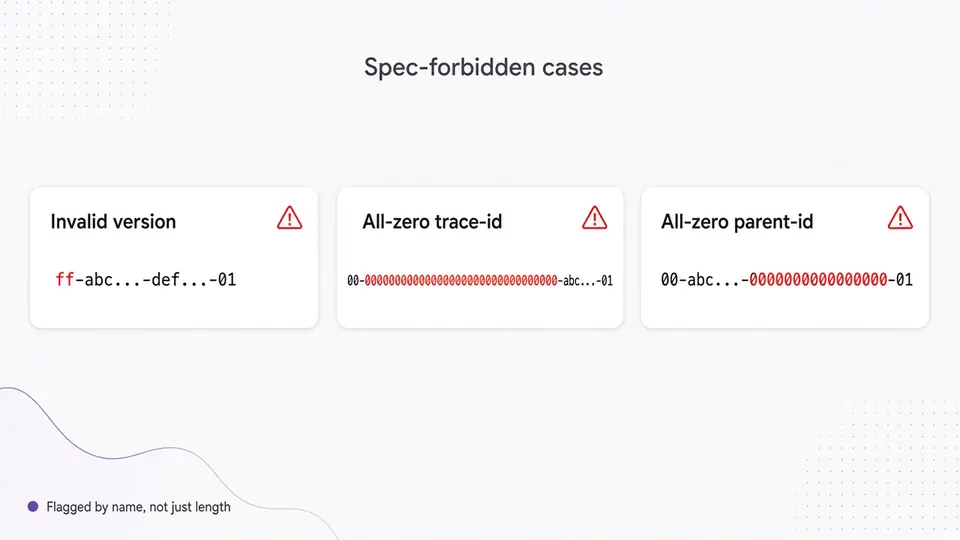
停止输入 300ms 后会自动解析,不用点按钮,除非把自动解析关掉。三个示例按钮不是随便选的:分别载入一条有效 header、一条 version 为 ff 的 header、一条 trace-id 全零的 header——正是规范里明确点名的三种边界情形。
- Ctrl/Cmd+Enter 可以跳过防抖立即解析
日志 / 可观测性
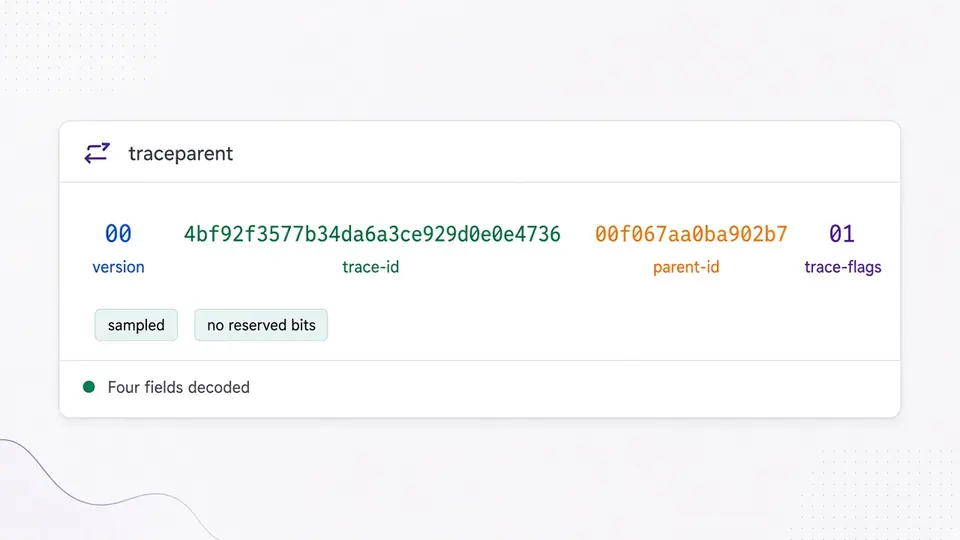
粘贴一条 traceparent header,逐字段查看 version、trace-id、parent-id 和 flags;也可以切到批量模式一次校验多条,或切到生成模式造一条测试用的。
解析与生成均在浏览器本地完成,不会上传,也不会发给任何追踪后端。
一条 traceparent header 看起来很简单——四段用「-」分开的字段——但某个服务打出的日志里 trace-id 全是 0,或者中间的代理悄悄把 version 改成了规范明确禁止的值,光靠肉眼扫一遍很难发现。这个 Traceparent 解析工具按 W3C Trace Context 的真实语法逐字段校验,能分清「格式合法只是长得陌生」和「这条 header 本来就是坏的」。
链路在两个服务之间断掉、需要确认 header 本身有没有问题时用它;手动接入 header 透传、需要一条测试用 header 时用它;翻日志时要一次看懂一整批 traceparent 时也用它——不用一条条数字符对不对。
为定位真实的 header 问题而做,不是为了给一条本来就合法的 header 好看地排排版。
从生产日志里粘一条 header 之前,值得先知道的三件事。
停止输入 300ms 后会自动解析,不用点按钮,除非把自动解析关掉。三个示例按钮不是随便选的:分别载入一条有效 header、一条 version 为 ff 的 header、一条 trace-id 全零的 header——正是规范里明确点名的三种边界情形。
tracestate 输入框默认收起,因为不是每条 header 都带这个字段——打开后会按规范的 32 条上限和 256 字符上限校验每一对 vendor=value。如果要检查的是一整份日志而不是单条 header,切到批量模式,一行粘一条。
version 00 的 header 会被完整校验;更高版本会照常解析四段字段,但多出来的尾部数据只原样展示,不做解读。只要一改输入,复制和下载就会立刻禁用,永远不会不小心导出一份过期结果。
真的按 W3C Trace Context 校验,不是一条只会看「-」位置对不对的正则表达式。
version、trace-id、parent-id 和 trace-flags 各自单独解析并标注,还包含对采样位的人话解读。
拒绝 version 为 ff、trace-id 全零、parent-id 全零、字段长度不对,以及大写十六进制——这些恰恰是一条宽松正则通常会放过的情形。
把整段日志里的 traceparent 值粘进去,就能拿到有效 / 无效 / 空行的统计,以及每一条出错行具体是哪个字段的问题。
按规范校验 key=value 成员的字符集、tenant@vendor 形式、256 字符的 value 上限、32 条成员上限,以及重复 key 的限制。
生成一条 version 00 的 traceparent,trace-id 和 parent-id 用密码学安全随机数生成且保证非全零,不会不小心拿一条非法占位值去测试。
在把「校验通过」当成「链路健康」之前,先看看这几条。
调试 W3C Trace Context header 时真实会遇到的问题。
trace-flags 是一个字节,写成两位十六进制,第 0 位就是 sampled 标志。01 表示调用方建议这条追踪被后端记录,00 表示不建议——这只是沿着调用链传递的一个建议,不代表任何系统真的采集了这条追踪。
trace-id 是整条分布式追踪链路唯一的标识,全链路所有服务共用同一个;span-id(W3C 规范里叫 parent-id)标识链路中当前这一段调用,每经过一个服务通常都会换一个新的 span-id,但它们共用同一个 trace-id。
traceparent 携带四个必需字段——version、trace-id、parent-id 和 trace-flags,任何遵循 W3C 规范的系统都必须能理解它。tracestate 是可选的、由具体追踪厂商自定义的 key=value 数据,某个系统可以附加自己的信息,而不要求其他系统也看得懂。
W3C Trace Context 规范把 ff 保留下来,专门用来避免和未来版本号混淆——不管 header 其余部分格式多规范,ff 都会被明确禁止。这个工具会直接点名指出是 version 为 ff 的问题,而不是当成普通的两位十六进制随便放行。
全零的 trace-id 没法标识任何东西,所以规范直接禁止它,尽管「32 个 0」表面上完全符合十六进制格式检查。parent-id(span-id)全零同理,也是无效的。
先粘进这个工具看清楚具体是哪个字段出的问题、原因是什么。现实中大多数损坏都来自某个代理或日志管道把 header 截断了、混进了大写十六进制,或者不小心透传了一个全零之类的模板值,而不是真正生成出来的 ID。
发现某条 header 解析得不对?
粘贴一条 traceparent header、批量校验一整批,或者生成一条测试用的新 header——全部在浏览器本地完成,不会上传任何内容。
下次链路在两个服务之间莫名断掉时,收藏它备用。
属于 HeyUtils 的开发与运维分类。