日志 / 可观测性

AWS 日志解析同时覆盖 CloudFront 与 ALB 访问日志

粘贴 CloudFront 标准访问日志或 ALB 访问日志,格式默认自动识别(也可手动选择),点击「解析日志」得到一张可筛选的表格。

AWS 日志解析

示例:
日志类型
筛选

访问日志

全部处理都在浏览器本地完成,日志内容不会被上传,也不需要 AWS 账号。

解析结果

解析日志后这里会显示表格。

粘贴 CloudFront 或 ALB 日志,或载入示例,然后点击「解析日志」。

CloudFront 和 ALB 是 AWS 上最常见的两种访问日志,但都不适合直接用肉眼读:CloudFront 的字段取决于你开启日志时勾选了哪些列,版本不同字段数也不一样;ALB 一行塞进 30 多个空格分隔的值,其中好几个还带引号。不管你把它叫 ALB 访问日志分析、负载均衡日志解析,还是 AWS 访问日志分析工具,这款 AWS 日志解析工具就是为了应付这种场景:手头有一段从工单、S3 下载或 CloudWatch 导出里复制来的日志片段,需要知道是哪个边缘节点响应的请求、哪个目标返回了 502、哪个客户端 IP 在高频访问某个路径,但又不想为此专门配一套 Athena 查询。

适合处理几百到几千行的一次性排查,不是给常驻的分析管道用的。全部处理都在浏览器标签页里完成,日志内容不会被上传,也不需要任何 AWS 账号或 S3 权限。

为什么用这个 AWS 日志解析工具

围绕这两种 AWS 格式各自声明字段的真实方式设计。

CloudFront 的字段表来自日志自己的头信息

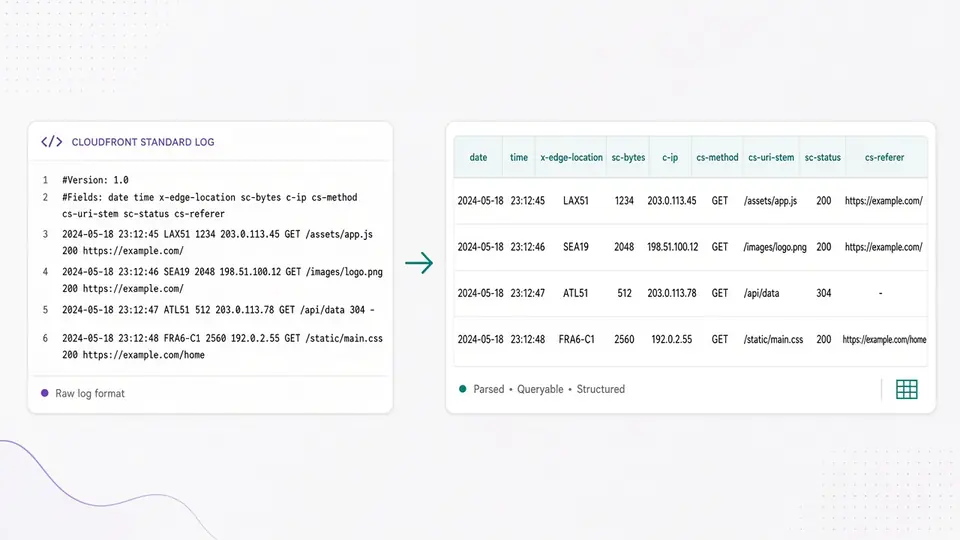
CloudFront 标准日志开头就有 #Version 和 #Fields 两行,按顺序写出了每一列的字段名。这个工具直接读这两行,而不是假设一套固定列表——AWS 未来给日志加字段,表格会跟着自动变长,不需要等这个工具更新,也不用你从版本列表里挑一个。

CloudFront #Fields 头信息行被直接映射成表格列名

按格式给出统计,不是笼统的访问日志摘要

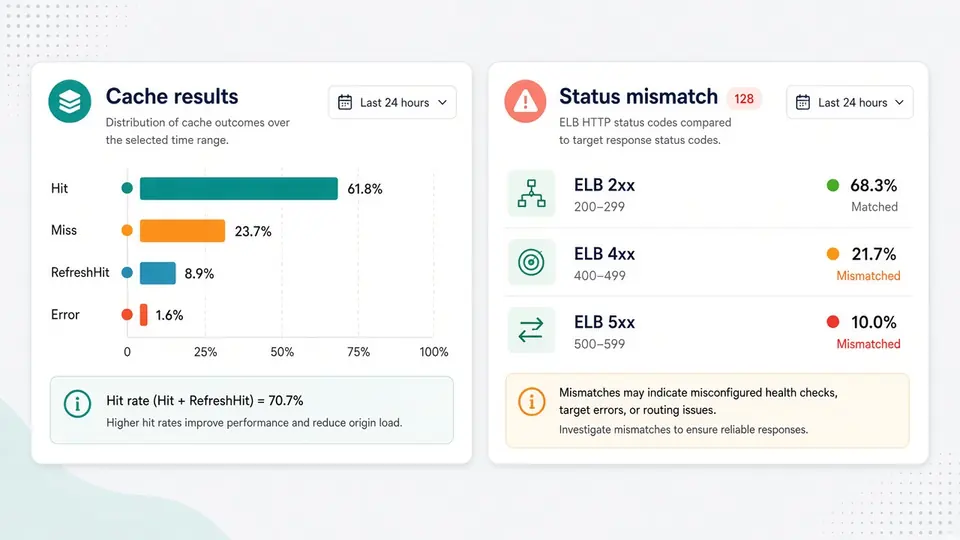
CloudFront 会给出缓存命中分布(Hit / Miss / RefreshHit / Error)和 Top edge location——这正是 CDN 表现异常时真正要查的两件事。ALB 会给出执行动作分布,以及负载均衡器状态码和目标状态码不一致的请求数,这通常是后端出问题的第一个信号。

分别展示缓存命中统计和 ELB/目标状态码不一致统计的两个面板

从原始 AWS 日志到可筛选的表格

三步完成解析、筛选和导出。

01

粘贴日志,交给自动识别

粘贴 CloudFront 标准日志或 ALB 访问日志。自动识别只看第一条非空行:以 #Version: 开头判定为 CloudFront,第一个词是 http/https/h2/grpcs/ws/wss 之一判定为 ALB。两者都不命中(比如只粘贴了数据行、没有头信息)时,从下拉手动选择日志类型,而不是靠猜。

  • 手动选 CloudFront 但日志没有 #Version/#Fields 头不会报错——会自动退回使用内置的默认字段表,覆盖当前 AWS 的字段集
  • 两组内置示例分别预选好了对应的日志类型,且各自混入了一行故意不匹配的坏行,方便你看清不匹配时是什么提示
02

点击「解析日志」(或按 Ctrl/Cmd+Enter)

解析不会随打字自动触发——这类日志常常有成千上万行,单行字段数还可能超过 30 个,每敲一个字符就重新匹配一遍并不划算。点一次「解析日志」,或用快捷键,表格就会填充出来。

  • 之后再改日志类型不会自动重新解析;旧表格仍然可见,只是变淡,直到你再次点击「解析日志」
03

筛选并导出

状态码、路径、客户端 IP,以及(CloudFront 下的)edge location 四个筛选条件都是对已解析出的行即时生效,不需要重新点「解析日志」。表格下方的统计面板会随筛选条件一起更新,包括缓存命中/执行动作分布,以及当前结果的总字节数、平均延迟、最大延迟。可以把当前显示的行导出成 CSV、JSON 或纯文本。

  • edge location 筛选框只在日志类型是 CloudFront 或自动识别时出现——ALB 日志没有对应字段,这个输入框是直接不渲染,而不是渲染出来但禁用
跳到解析器

这张表格比原始文本多给你什么

字段映射、四个筛选维度,以及为排查真实 AWS 访问日志设计的分格式统计。

CloudFront 的字段映射是自描述的

列名直接来自日志自带的 #Fields 行,所以表格永远和你粘贴的那份日志的实际版本对齐,包括你开启日志时自定义勾选的字段子集。

ALB 用固定且只增不改的字段表

ALB 日志没有头信息行,但 AWS 官方文档写得很明确:新字段只会加在末尾。这个工具按已知的完整字段列表逐位置映射每一行的 token,并报告实际匹配上了几个已知字段——较早版本的日志字段更少也能正常解析,不会报错。

四个筛选维度:状态码、路径、客户端 IP、edge location

可以按状态码区间或精确值、路径子串或正则、客户端 IP 子串,以及(仅 CloudFront)edge location 子串缩小表格范围,全部不需要重新解析日志。

缓存命中/执行动作分布,外加状态码不一致计数

CloudFront 的行按 x-edge-result-type 统计(Hit、Miss、RefreshHit、Error 等);ALB 的行按逗号分隔的 actions_executed 统计,外加一项 ELB 状态码与目标状态码不一致的请求计数。

坏行给出具体行号

列数与检测到的格式对不上的行,会连同 1 基行号和原始文本一起列出来,几行异常数据不会悄悄从计数里消失。

支持 CSV、JSON、纯文本导出

导出的正是当前筛选条件下显示的那些行,列结构和表格一致,可以直接丢进表格软件或别的工具。

这个解析器读什么,不读什么

字段识别、坏行判定和范围边界的具体行为,短期内不会变。

CloudFront 要求列数完全匹配,ALB 至少要有 13 个 token
CloudFront 数据行只有在按 Tab 分隔的列数与当前字段表(来自 #Fields,或内置默认表)完全一致时才会被接受。ALB 行至少要有 13 个空格分隔的 token——够到带引号的 request 字段为止,否则会被列为坏行,而不是被硬猜着解析。
超出已知 34 个字段的 ALB 尾随字段不会被映射
如果未来 AWS 发布在已知字段之后又加了新字段,这些多出来的值不会显示成额外的列——字段覆盖提示仍会照实显示「已匹配 N / 已知总数」,方便你判断这份日志是不是比这个工具认识的字段表更新。
解析的是经典文本格式,不是 CloudFront Standard Logging v2 的 JSON 或 Parquet 输出
CloudFront Standard Logging v2 也能投递 JSON 或 Parquet 文件。Parquet 是二进制列式格式,粘贴成文本对浏览器解析没有意义,所以这个工具只处理经典的 W3C 风格文本日志(legacy 格式,以及 v2 里对应的 w3c 输出选项)。
不连 S3、不要 AWS 凭证、不处理实时/流式日志
这个工具从不要求填写存储桶名或访问密钥,也不发起任何网络请求——你粘贴的是已经拿到手的文本。它也不读取 CloudFront 实时日志,那是通过 Kinesis Data Streams 推送的,不是可以粘贴的文件。
单次粘贴上限是 300,000 字符、20,000 行
这个上限让浏览器标签页里的解析保持够快、够可预期。日志导出更大的话,拆成几批分别粘贴解析。

AWS 日志解析常见问题

在线解析 CloudFront 或 ALB 访问日志之前,大家最常问的几个问题。

CloudFront 访问日志的字段都是什么意思?

这取决于你的分发(distribution)的日志配置和开启时间——这正是这个工具直接读日志自带的 #Fields 行、而不是假设一套固定字段列表的原因。粘贴你的日志,表格的列名就是你这份日志实际版本对应的真实字段名,从 date、c-ip 到 fle-status、sc-range-start 这类不常见的字段都会照实显示。

ALB 访问日志要怎么分析、怎么解析各个字段?

选择 ALB(或者让自动识别根据第一个词,比如 https 或 http,来判断),粘贴日志,点击「解析日志」。ALB 没有头信息行,这个工具会按 AWS 官方文档给出的字段顺序——type、time、elb、client:port 一路到 classification、ip_address 这类较新的字段——把每一行按空格分隔的 token 逐个对应上。

CloudFront 日志格式的 version 字段是什么意思,有哪几种?

它就是 CloudFront 标准日志开头 #Version: 那一行的值,经典文本格式目前是 1.0。这个工具原样读取并显示这个值,它只是信息展示,不是你要选择的选项;如果粘贴的日志没有这一行,工具会照常用内置的默认字段表解析。

怎么把 CloudFront 和 ALB 日志关联到同一个请求上?

这个工具不会自动把两份日志拼接起来,它只是各自独立解析。它能提供的是手动比对需要的字段:CloudFront 的 x-edge-request-id 和 x-forwarded-for,以及 ALB 的 trace_id——AWS 文档里写的正是用这个字段在两跳之间做关联。

把 AWS 访问日志粘贴到在线工具里安全吗?会不会被上传?

粘贴的内容不会被发送到任何地方。解析、筛选、导出全部由浏览器标签页里的 JavaScript 本地完成,没有服务端上传、存储或记录,整个过程也不会要求提供 AWS 账号或 S3 访问权限。

ALB 日志里新增的 conn_trace_id、classification 这些字段是干什么的?

自 2016 年以来 AWS 已经多次在 ALB 日志末尾追加字段——用于 desync 缓解的 classification 和 classification_reason、conn_trace_id,以及更晚近的 transformed_host、ip_address。这个工具会按已知的 34 个字段尽量匹配某一行实际拥有的字段数并报告匹配情况,所以不管日志是较早还是较新的版本都能正常使用,你不需要记住哪个字段是哪次发布加的。

支持 CloudFront Standard Logging v2 的 JSON 或 Parquet 格式吗?

不支持——这个工具只读经典的、Tab 分隔的文本日志格式(legacy 格式,以及 Standard Logging v2 下对应的 w3c 输出选项)。Parquet 是二进制列式文件,没法有意义地粘贴成文本,所以这个输出选项不在一个基于浏览器的文本解析工具的范围内。

发现某一行真实日志被解析错了?

现在就解析你的 CloudFront 或 ALB 日志

粘贴一段 CloudFront 标准日志或 ALB 访问日志,几秒内得到一张可筛选、可导出的表格——不连 S3,不要 AWS 凭证,也不上传。

下次要查缓存命中率、找出是谁在高频访问某个路径,或者排查目标组为什么返回了错误状态码时,收藏这个 AWS 日志解析工具。

全部解析都在你的浏览器本地完成。