01
按来源选择输入表示
字节输入接受连续十六位十六进制,或空格分隔的八组两位字节。高低位输入顺序固定为 high,low,和 C 结构先声明低位的顺序不同;字段值不是内存字节,不需要再次倒序。
日期与时间
选择数值表示与 LDAP 属性,查看精确到七位小数的 UTC 日期、高低位和字节排列。
输入仅在当前浏览器中处理,不会发送到服务器。
Windows 纪元:1601-01-01 UTC;一个 tick = 100 ns。
每行一个值。高低位:high,low,可用十进制或带 0x 的分段,允许有符号十进制分段。字节:连续十六位十六进制或八组字节。日期:YYYY-MM-DDTHH:mm:ss[.1–7 位小数]Z 或 ±HH:mm;扩展年份用 +YYYYYY。
字节序只影响字节输入。请按实际 AD 字段选语境;零不总是永不过期。只有 pwdLastSet 的十进制模式接受 -1 写入控制值。
UTC 日期保留七位小数。Unix 秒和毫秒向下取整,余数以 100 ns 的 tick 表示。
最多 1,000 个物理行和 100,000 个 UTF-16 代码单元。去除行首尾空白;空行报错。
输入内容或载入示例以开始。
查看 AD 导出或 NTFS 记录时,FILETIME 转换能把长整数还原为可核对的日期。应保留原始文本,避免电子表格的科学记数法或毫秒级查看器掩盖末尾几位。
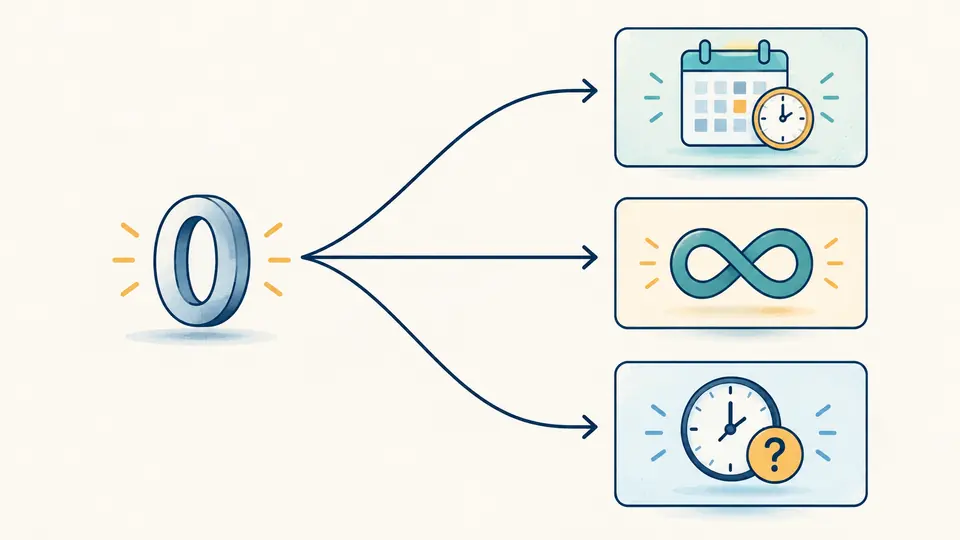
同样一个零值,可能表示 Windows 纪元起点,也可能是账户永不过期或登录时间未知。先确认字段名称,再用相应预设解释,才能知道这条记录是否真的包含日期。
FILETIME 转换同时给出十进制、完整十六进制、两个 DWORD 和两种字节排列。整值十六进制不受字节序选项影响,只有从内存提取的八字节输入才需要按大端或小端解码。
通用模式把零显示为 1601 年起点;accountExpires 预设显示永不过期,lastLogon 预设显示未知。特殊状态不附加虚构的日期,也不会继续生成看似正常的 Unix 时间戳。
字节输入接受连续十六位十六进制,或空格分隔的八组两位字节。高低位输入顺序固定为 high,low,和 C 结构先声明低位的顺序不同;字段值不是内存字节,不需要再次倒序。
日期反向换算需要 Z 或明确的 ±HH:mm 偏移,即使电脑使用 UTC 也不能省略。示例会随方向和数值表示变化,先显示待替换文本与数量,应用后才覆盖输入。
自动换算在停止编辑 350 ms 后执行,关闭后可按 Ctrl/Cmd+Enter。所有行都是有效日期时才能反向使用结果;改动输入或参数会立即禁用导出,撤销可同时恢复输入与报告。
116444736000000001 对应 1970-01-01T00:00:00.0000001Z。数值使用整数运算,报告用字符串保存大整数,不经过浮点数或毫秒舍入;反向换算仍能得到最后那一个 tick。
高低位可使用无符号 DWORD,也可使用 32 位范围内的有符号十进制 LONG。负数按补码解释,报告同时给出有符号和无符号值,便于核对 ADSI 导出;整值 FILETIME 不沿用此规则。
LDAP 时间戳转换器先减去 116444736000000000,再换算秒或毫秒。结果向下取整,并保留非负 tick 余数;1970 年前不足一毫秒的时间不会错误地被截断为零。
每批最多处理 1,000 行,一行无效不会挡住其他行。结果先展示 50 行,可继续展开;复制和下载始终包含完整 JSON 报告、原输入及逐行错误,方便回到源文件定位。
如果原值是十进制 FILETIME,选择对应表示即可读取 UTC 日期;如果来自二进制转储,还需确认字节顺序。不要把 Unix 毫秒或 .NET ticks 当作同一种数值,它们的纪元或单位不同。
只能当作线索,不能作为判断依据。常见的现代 FILETIME 有十八位,但零和短整数也在表示范围内;Unix 秒、毫秒以及其他纪元的值可能碰巧长得相似。请以字段文档为准。
夏令时规则或把 UTC 当成本地时间都可能造成偏差。本工具固定输出 UTC,反向输入必须明确偏移,不采用电脑当前时区。若源数据来自 FAT,还应确认提取时如何把本地文件时刻换成 UTC。
可以,每行输入一个日期或数值,同一批共用方向、表示和属性设置。最多 1,000 个物理行,空行也计数并报错。若源文件混合多种编码,需要先按编码分组。
行级错误会保留原值和行号,其他行仍可转换。超出整批限制则停止本次处理。报告可导出逐行诊断,但只要存在错误或非日期状态,就不能反向生成一列日期。
结果与预期不同?