01
Die Basis bewusst angeben
Relative Verweise benötigen eine gültige Basis. Ein leerer Verweis mit Basis ist erlaubt; eine ungültige angegebene Basis scheitert auch bei einer absoluten Eingabe.
URL / URI Tools
Verstehen, wie der Browser eine Adresse liest
Die Eingabe wird in diesem Browser verarbeitet und nicht an einen Server gesendet.
Relative Verweise brauchen eine gültige Basis. Mit Basis ist auch ein leerer Verweis erlaubt.
Die Ausgabe folgt WHATWG. Originaleingabe und Basistext werden nicht exportiert.
Authority-Zugangsdaten sind immer verdeckt und fehlen in href. Keine Suche nach Geheimnissen in Pfad, Query oder Fragment.
Eingabe und Basis je 100.000 UTF-16-Einheiten; maximal 1.000 Parameter und 4.000.000 Ausgabeeinheiten.
Adresse oder Basis eingeben oder Beispiel wählen.
Der URL-Parser zeigt, weshalb ein Link anders interpretiert wird, als seine Schreibweise vermuten lässt. So lässt sich eine URL analysieren, wenn Port, Host oder Pfad im Ergebnis überraschen.
Eine URL zerlegen heißt hier: Bestandteile nach Browserregeln lesen und Query-Parameter in ihrer Reihenfolge erhalten. Zum URL dekodieren wird nicht die gesamte Adresse in einen unstrukturierten Text verwandelt.
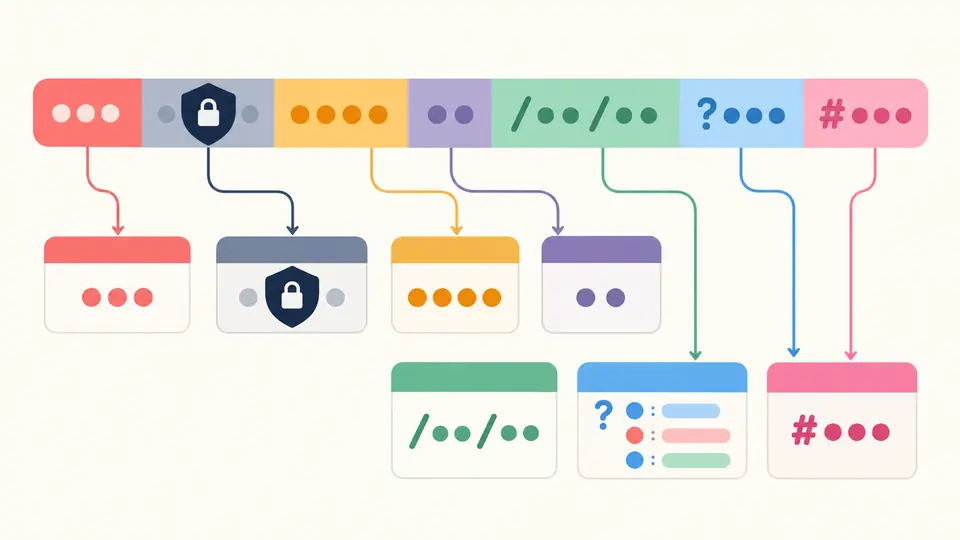
Der URL-Parser trennt hostname, host und origin. Text vor @ kann ein Benutzername sein. Zugangsdaten erscheinen nur als feste Platzhalter und werden aus href vollständig entfernt.
Bei einer Basis mit /docs/guide/ führt ../assets/logo.svg nach /docs/assets/. Das Ergebnis erklärt den Verzeichniswechsel, ohne den eingegebenen Text zu ersetzen.
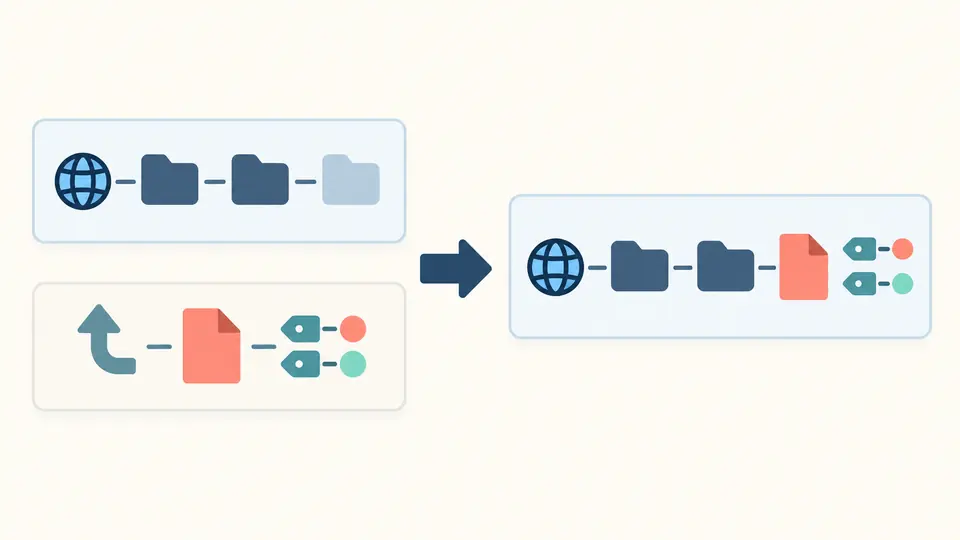
Relative Verweise benötigen eine gültige Basis. Ein leerer Verweis mit Basis ist erlaubt; eine ungültige angegebene Basis scheitert auch bei einer absoluten Eingabe.
Standardports verschwinden, Domainbuchstaben werden kleingeschrieben und .. wird aufgelöst. Im Query bedeutet + ein Leerzeichen, %2B dagegen ein Pluszeichen.
Automatik wartet 350 ms. Ohne Automatik starten die Schaltfläche oder Strg/Cmd+Enter die Analyse. Änderungen sperren alte Exporte. Beispiel und Leeren werden vorab angezeigt und lassen sich nach dem Anwenden einmal rückgängig machen.
host enthält einen abweichenden Port, hostname nicht. IPv6-Klammern bleiben erhalten. Bei normalen Webadressen enthält origin zusätzlich das Schema.
Doppelte Namen sowie leere Namen und Werte bleiben bestehen. flag und flag= ergeben beide einen leeren Wert; die ursprüngliche Schreibweise geht dabei verloren.
Wählen Sie Komponenten-JSON oder href ohne Zugangsdaten. Der Bericht hält nur fest, ob eine Basis angegeben wurde, und exportiert weder Basistext noch Originaleingabe.
mailto:, data:, blob: und file: folgen den nativen Regeln. Ein leerer Host oder origin mit dem Wert "null" muss kein Fehler sein.
Bei https://example.com:8443/a ist host gleich example.com:8443, origin gleich https://example.com:8443 und hostname gleich example.com. Standardports werden zuvor entfernt.
Die URL-API interpretiert Punktsegmente nach dem Standard. Aus /a/../b wird bei HTTPS /b. Das Ergebnis beschreibt die aufgelöste Adresse und nicht deren ursprüngliche Schreibweise.
Der Analysevorgang läuft im Browser. Er sendet die eingegebene Adresse weder an einen Analyseserver noch öffnet er das Ziel.
In https://trusted.example@other.example/ ist trusted.example der Benutzername. Der Host lautet other.example. Deshalb sollten Sie hostname lesen, statt den Namen vor @ als Ziel anzusehen.
Es kennzeichnet eine Punycode-Darstellung eines internationalisierten Domainlabels. Die native ASCII-Schreibweise ist keine Auskunft über Eigentümer oder Vertrauenswürdigkeit.
Stimmt etwas nicht?
Nutzen Sie den URL-Parser, um Basis, aufgelösten Pfad und doppelte Parameter zu vergleichen, bevor Sie den Bericht exportieren.