URL / URI Tools

URL-Normalisierer

Adresse normalisieren, relative Referenz auflösen oder einen Pfad anhängen.

URL-Normalisierer

Eingabe

Ergebnis

Berechnung im Browser. Die eingegebene Adresse wird weder geöffnet noch abgerufen.

Optionen

Nur HTTP(S). Host, Schema, Standardports und Punktsegmente folgen dem Browser. Reservierte Zeichen bleiben kodiert; keine Canonical-Garantie.

Eingabe und aktive Basis: je 100.000 UTF-16-Einheiten. Ausgabe: 1.000.000.

Bereit · 59 Einheiten · Query-Parameter: 3

Ein URL-Normalisierer hilft beim Prüfen kopierter API-Adressen mit wechselnder Hostschreibung, Standardport oder überflüssigen Punktsegmenten. Das Beispiel zeigt die Änderungen, bevor Sie eigene Daten einsetzen.

Beim Aufbau eines Endpunkts entscheidet die Bedeutung der Basis: Ist /api/v1 eine Seitenadresse oder das Verzeichnis, an das users angehängt werden soll? Die beiden Vorgänge erhalten eigene Modi, damit diese Entscheidung sichtbar bleibt.

Warum diesen URL-Normalisierer verwenden?

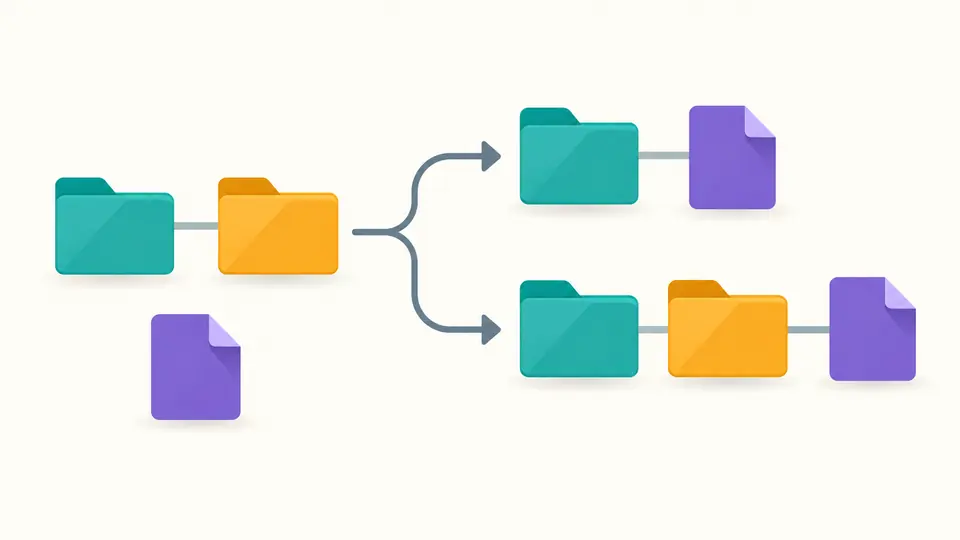
Ersetzen und Anhängen vergleichen

Der URL-Normalisierer zeigt den Unterschied direkt: Mit https://example.com/api/v1 als Basis ergibt die relative Auflösung von users den Pfad /api/users. Beim Verbinden entsteht /api/v1/users. Damit lässt sich ein unerwartet verschwundener letzter Abschnitt gezielt prüfen.

Ein Basispfad verzweigt in das Ersetzen des letzten Ordners durch eine Datei und das Anhängen derselben Datei hinter beiden Ordnern.

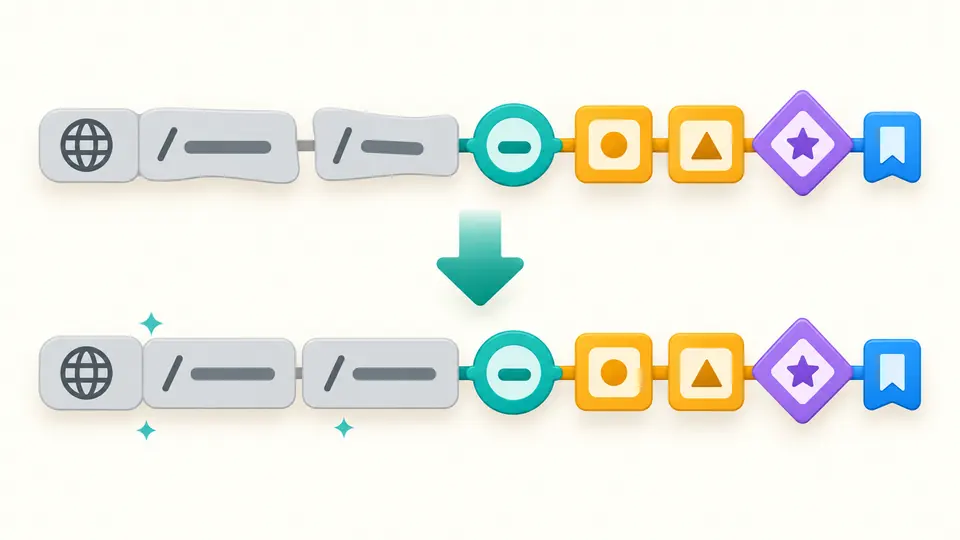
Mehrfachwerte behalten ihre Reihenfolge

Wiederholte tag-Schlüssel bleiben in derselben Folge. flag unterscheidet sich weiterhin von flag=, und + wird nicht in %20 umgeschrieben. Die Kodierungsoption sortiert keine Parameter und entfernt keine vermeintlich unnötigen Werte.

Farbige Query-Einträge behalten ihre Reihenfolge und ein doppeltes Paar bei einer Kodierungsänderung.

Die Basis passend zur Aufgabe wählen

01

Mit einer vollständigen Adresse beginnen

Zum Normalisieren ist eine absolute HTTP(S)-Adresse nötig. Eine relative URL benötigt den Modus Auflösen und eine gültige Basis. Im Normalisierungsmodus wird das Basisfeld nicht ausgewertet; ein fehlendes Protokoll wird nicht geraten.

02

Den letzten Schrägstrich beachten

Auflösen behandelt den letzten Abschnitt ohne abschließenden / als Dateiposition. Verbinden hängt an den gesamten Basispfad an und übernimmt dessen Query und Fragment. Der anzuhängende Pfad darf Unterordner, aber weder ? noch # enthalten.

03

Ergebnis vor dem Schreiben prüfen

Automatik wartet nach Änderungen 350 ms. Ohne Automatik startet Strg/Cmd + Enter die Berechnung. Veraltete Ergebnisse lassen sich nicht exportieren. Beim Anwenden wird auf Normalisieren gewechselt und die Basis geleert; Rückgängig stellt Eingabe, Einstellungen und Ergebnis wieder her.

Struktur und Kodierung getrennt steuern

URLs normalisieren nach Browserregeln

Schema und Host werden kleingeschrieben; der Parser kann Standardports entfernen: 80 bei HTTP, 443 bei HTTPS. Andere Ports bleiben. Punktsegmente werden aufgelöst, internationale Domainnamen als ASCII/Punycode und Unicode-Pfade in kodierter Form ausgegeben.

Drei Regeln für Prozentkodierung

Sie können die geparste Schreibweise behalten, Hexadezimalbuchstaben großschreiben oder ausschließlich unreservierte ASCII-Zeichen dekodieren: Buchstaben, Ziffern und -._~. Reservierte Zeichen wie %2F, %3F und %23 bleiben kodiert. %252F wird nicht wiederholt dekodiert.

Auflösen oder am gesamten Pfad anhängen

Relative Referenzen dürfen zum übergeordneten Verzeichnis, zur Wurzel, zu einer Query oder einem Fragment führen. Verbinden bereinigt nur die Verbindungsstelle und erhält interne //. Query und Fragment stammen dabei aus der Basis; zwei Query-Strings werden nicht zusammengeführt.

Grenzen der Adressumformung

Keine automatische Canonical-Entscheidung
Seiteninhalt, Weiterleitungen und Serverregeln werden nicht untersucht. HTTPS, www, Pfadschreibung und abschließende Schrägstriche werden nicht nach einer SEO-Vorgabe geändert. Der Browser normalisiert weiterhin nach seinen eigenen Regeln. Gleiche Ressourcen lassen sich aus dem Text allein nicht nachweisen.
Behalten bedeutet nicht bytegleich
Keine Sortierung, Deduplizierung, UTM-Filterung oder Entfernung leerer Werte. Der Browser und die Prozentoption können dennoch die Schreibweise verändern. Entfernen löscht die gesamte Query und meldet auch ein leeres ? separat. Signierte Links müssen mit den Regeln der Anwendung geprüft werden.
Strikte Eingaben für HTTP(S)
Zugangsdaten in der Authority, Steuerzeichen, Rückwärtsschrägstriche, ungültige %-Sequenzen und einzelne Surrogate werden abgelehnt. Äußerer Leerraum wird entfernt. Gültig geschriebene kodierte Bytes werden nicht auf UTF-8 geprüft. Auflösen und Verbinden verlangen stets eine absolute Basis.
Kein Schutz vor übergeordneten Pfaden
Beim Verbinden sind Schema, anfängliches //, ? und # verboten. Ein einzelner führender / bildet die Verbindungsstelle. .. kann trotzdem nach oben führen; dies ist keine Zugriffskontrolle. Ein leerer Pfad behält zunächst die Basis, bevor die gewählten Richtlinien greifen.
Einzeladresse mit festen Grenzen
Eingabe und aktive Basis: jeweils 100.000 UTF-16-Codeeinheiten; Ergebnis: 1.000.000. Überschreitungen führen zum Fehler, nicht zum Abschneiden. Die Anzeige wächst in Schritten von 20.000 Einheiten, Kopie und TXT enthalten das vollständige aktuelle Ergebnis. Stapeldateien sind nicht vorgesehen.

Fragen zum URL-Normalisierer

Wie lassen sich absolute und relative URLs verbinden?

Nutzen Sie Auflösen mit der absoluten Seitenadresse als Basis. Die relative Referenz folgt den Verzeichnis-, Eltern- und Wurzelregeln des Browsers. Soll sie hinter allen Abschnitten der Basis stehen, ist Verbinden die passende Operation.

Warum wird beim Auflösen eines relativen Pfads das letzte Segment der Basis-URL ersetzt?

Bei /a/b ist /a/ das aktuelle Verzeichnis. Die Referenz c ergibt deshalb /a/c. Mit /a/b/ als Basis entsteht /a/b/c. Der Verbindungsmodus hängt auch ohne abschließenden Schrägstrich hinter dem gesamten Basispfad an.

Ist die Groß- und Kleinschreibung bei der Prozentkodierung einer URL relevant?

Innerhalb einer Prozentsequenz bezeichnen %7e und %7E dasselbe Byte. Das gilt nicht für die gesamte Adresse: Die Pfade File und file können unterschiedliche Ressourcen benennen. Ihre Groß- und Kleinschreibung wird deshalb beibehalten.

Sind ein Schrägstrich und %2F im Pfad einer HTTP-URL gleichwertig?

Das sollte nicht vorausgesetzt werden. / trennt Pfadabschnitte; %2F ist ein kodiertes reserviertes Zeichen. Server und Router können beide Formen unterschiedlich behandeln. Auch beim Dekodieren unreservierter Zeichen bleibt %2F daher erhalten.

Beeinflusst die Reihenfolge der Query-Parameter doppelte Inhalte bei SEO?

Die Reihenfolge allein beweist keine identischen Seiten und legt keine Suchmaschinen-Canonical fest. Sie kann außerdem Signaturen und Anwendungslogik beeinflussen. Das Werkzeug erhält die Reihenfolge; die passende Indexierungsstrategie benötigt die tatsächlichen Inhalte und Serverregeln.

Stimmt etwas nicht?

Den vorgesehenen Pfad überprüfen

Vergleichen Sie mit dem URL-Normalisierer Quelle und Ergebnis. Kontrollieren Sie Modus und Löschzahlen, bevor Sie die Adresse kopieren oder nach einer Vorschau anwenden.