01
完整地址直接整理
规范化模式要求显式 http:// 或 https:// 地址,不会给裸域名猜协议,基址也不参与计算。要做相对路径转绝对路径,请选择相对解析,并填写链接所在页面的完整地址。
URL / URI
先选规范化、相对解析或路径拼接,再核对地址变化。
在浏览器本地计算,不打开或请求输入的地址。
仅 HTTP(S)。主机名、协议、默认端口和点段遵循浏览器规则;保留字符不解码,不保证搜索引擎 canonical。
输入与有效基址各限 100,000 个 UTF-16 单元,输出限 1,000,000 个。
已完成 · 59 个单元 · 3 个查询参数
URL 规范化适合排查复制来的接口地址:主机名大小写混用、路径里有上级目录引用,或同一个转义字节出现不同写法。示例把这些情况放在一起,便于先观察默认处理,再换成实际链接。
拼接接口路径时,最容易忽略的是基址最后一段。/api/v1 可以是页面位置,也可以是需要继续追加的目录;两种理解会产生不同结果。选择模式后再调整编码与保留策略,能把每次变化的原因分清楚。
URL 规范化把两种路径行为分成独立模式。基址为 https://example.com/api/v1、输入为 users 时,相对解析得到 /api/users,路径拼接得到 /api/v1/users。先确认接口约定,避免把字符串连接的预期套在浏览器链接上。
同名 tag 参数仍按原顺序出现,flag 与 flag= 的区别保留,+ 不会自动换成 %20。百分号选项只控制转义表示,不顺带排序、去重或清理追踪参数,方便核对现有地址的结构。
规范化模式要求显式 http:// 或 https:// 地址,不会给裸域名猜协议,基址也不参与计算。要做相对路径转绝对路径,请选择相对解析,并填写链接所在页面的完整地址。
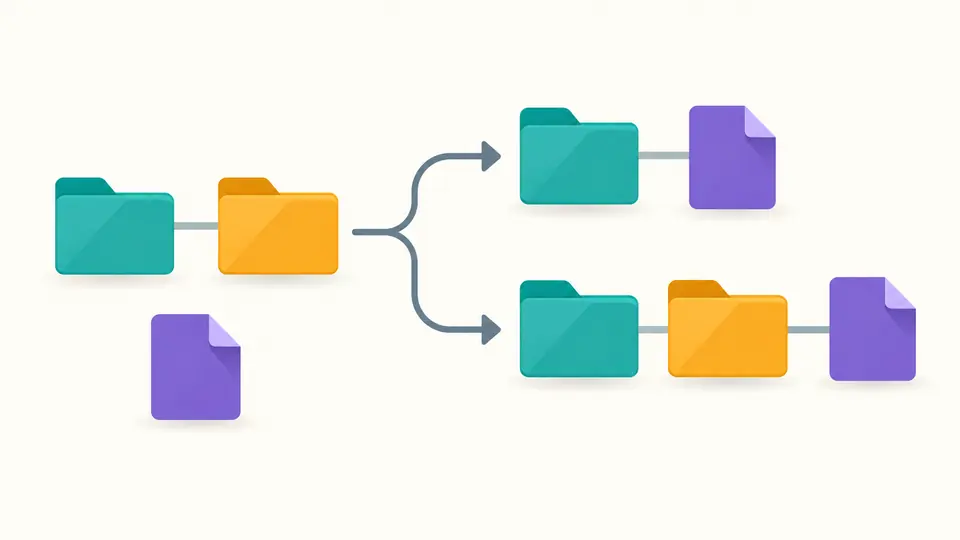
相对解析会将没有尾斜杠的基址末段当作文件位置;路径拼接则在整个基址路径后追加。拼接保留基址的查询串和片段,输入应是一段可含多级目录的路径;包含 ? 或 # 的引用应使用相对解析。
默认停顿 350 毫秒后更新结果,关闭自动转换可用 Ctrl/Cmd + Enter 执行。输入或选项改变会立即禁用旧结果的导出。预览会显示替换长度及删除数量;应用后切回规范化并清空基址,撤销可恢复此前的输入、选项和结果。
URL 标准化使用浏览器原生解析器:协议与主机名转小写,HTTP 的 80 端口和 HTTPS 的 443 端口省略,其他端口保留。路径中的点段被解析,国际化域名转为 ASCII/Punycode,中文路径按地址规则编码。
保留解析后的转义写法、将十六进制字母大写,或解码 ASCII 非保留字符,包括字母、数字及 -._~。解码模式会把其余转义统一为大写,但不会将 %2F、%3F、%23 变成结构分隔符,也不递归解码 %252F。
URL 拼接会修整两段相接处的斜杠,路径内部的 // 保持不变。相对解析则支持上级目录、站点根路径、仅查询串及仅片段引用,查询串是否继承遵循浏览器规则,不会把两串参数暗中合并。
把完整页面地址放入基址,相对引用放入输入,并选择相对解析。浏览器会处理当前目录、上级目录和站点根路径。如果目的是在基址的每一段之后继续追加,请使用路径拼接,并确保输入不携带查询串或片段。
基址 /a/b 没有尾斜杠时,当前目录是 /a/,所以解析 c 得到 /a/c。把基址改成 /a/b/,或者选择路径拼接,才会得到 /a/b/c。这里是引用解析规则,不是路径字符意外丢失。
转义中的十六进制字母不区分大小写,%7e 与 %7E 表示同一个字节。但这不意味着整个地址都不区分大小写;路径中的 File 和 file 可能指向不同资源,因此不会整体转小写。
不能一概视为等价。字面斜杠划分路径层级,%2F 是经过编码的保留字符,服务器或路由器可能采用不同处理方式。即使选择解码非保留字符,也会继续保留 %2F,避免引入新的路径层级。
要看服务器与站点的实际约定。查询串可以决定筛选、分页或签名,尾斜杠也可能对应不同路由。工具默认保留它们,只在显式选择时删除整段查询串;不会通过猜测生成所谓正确的规范网址。
发现问题?