01
完全なURLか参照かを選ぶ
正規化にはhttp://またはhttps://から始まる絶対URLを使います。相対URLには参照解決を選び、リンク元ページの絶対アドレスを基底欄へ入力します。正規化モードでは基底欄の値を使用しません。
URL / URI Tools
完全なアドレスの整理、相対参照の解決、パスの追加を選択。
ブラウザー内で計算し、入力先のアドレスを開いたり取得したりしません。
HTTP(S)のみ。ホスト、スキーム、既定ポートと点セグメントはブラウザーに従います。予約文字は復号せず、canonicalは保証しません。
入力と使用中の基底は各100,000 UTF-16単位、結果は1,000,000単位まで。
完了 · 59単位 · 3個のパラメーター
URL正規化は、コピーしたエンドポイントの表記を確認したいときに役立ちます。大文字のホスト名や既定ポート、点セグメントを含む例を用意しました。まず変化する部分を見てから、自分のアドレスで試せます。
リンク元のページと追加先のディレクトリは、同じ基底URLでも意味が異なります。/api/v1の後ろにusersを付けたいのか、そこから見た相対リンクを解決したいのか、操作を分けて指定してください。
URL正規化では参照解決と結合を別の操作として扱います。基底がhttps://example.com/api/v1なら、usersの相対解決は/api/users、結合は/api/v1/usersです。ライブラリへ渡す前に、想定した階層になるか確認できます。
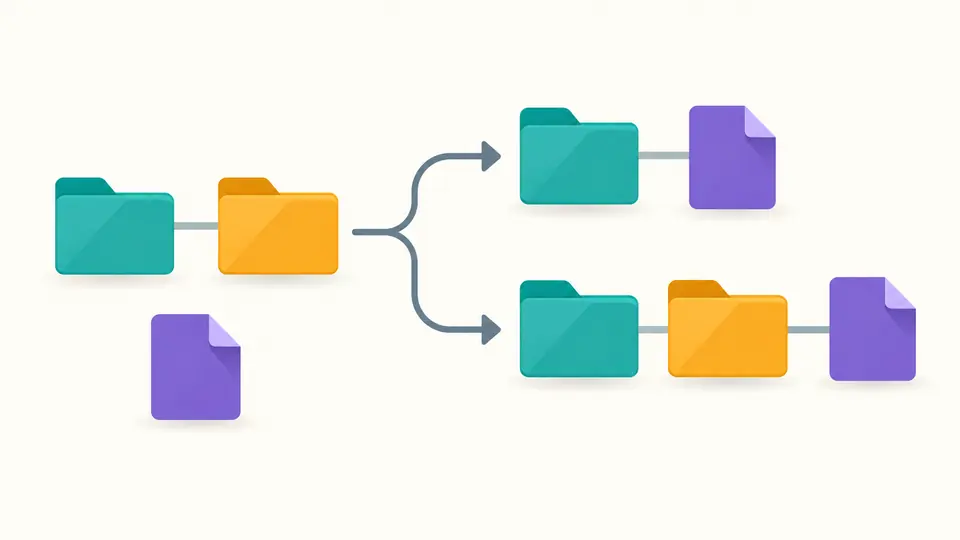
同じキーが繰り返されても元の順番を保持します。flagとflag=、+と%20も区別したままです。パーセント表記の整理とパラメーター削除を別々に選べるため、重複値を勝手にまとめずに確認できます。
正規化にはhttp://またはhttps://から始まる絶対URLを使います。相対URLには参照解決を選び、リンク元ページの絶対アドレスを基底欄へ入力します。正規化モードでは基底欄の値を使用しません。
参照解決では、末尾にスラッシュがない基底の最後の部分はファイル位置として扱われます。URL結合は基底の全パスに追加します。結合の入力は一つのパスで、?や#を含む参照には解決モードを使います。
自動変換は編集後350ミリ秒待って実行します。オフならCtrl/Cmd + Enterで実行できます。入力や設定を変更すると古い結果は書き出せません。反映時は正規化へ切り替えて基底を空にし、取り消すと元の設定と結果も復元します。
スキームとホスト名の小文字化、HTTPの80番とHTTPSの443番ポートの省略、点セグメントの解決はブラウザーのURL解析に従います。それ以外のポートは残り、国際化ドメインはASCII/Punycodeで出力されます。
解析後の表記を保持する、十六進数の英字を大文字にする、非予約文字だけ復号する、の三方式です。非予約文字はASCIIの英数字と-._~。%2Fや%3Fは復号せず、%252Fを繰り返し復号することもありません。
参照解決は親ディレクトリ、ルートからのパス、クエリだけ、フラグメントだけの参照に対応します。結合は接続箇所のスラッシュだけを調整し、内部の//を保持。基底のクエリとフラグメントを引き継ぎます。
相対参照を入力し、リンク元の絶対URLを基底に指定して参照解決を使います。親やルートからの参照もブラウザーと同じ規則で処理します。基底の最後の部分も含めて後ろに追加したい場合は、パス結合を選びます。
/a/bの現在ディレクトリは/a/なので、cを解決すると/a/cになります。/a/b/のように末尾へスラッシュを付けると/a/b/cになります。パス結合なら末尾スラッシュがなくても全パスの後ろへ追加します。
%7eと%7Eは同じバイトを表します。この規則はパーセント表記の十六進数に対するもので、URL全体が大文字小文字を区別しないという意味ではありません。Fileとfileというパスは別のリソースになる場合があります。
同じと決めつけられません。/はパスの区切りで、%2Fは符号化された予約文字です。サーバーやルーターによって扱いが異なるため、非予約文字の復号を選んでも%2Fは保持して、新しい階層を作らないようにします。
クエリ順序だけで重複ページや検索エンジンの正規URLを判定できません。順番が署名やアプリの処理に関わることもあります。このツールは順番を保持し、サイト固有の正規化方針は実際のルーティングと内容に基づいて決める必要があります。
問題がありますか?