URL / URI Tools

Normalizador de URL

Normaliza una dirección, resuelve una referencia o añade una ruta.

normalizador de URL

Entrada

Resultados

Cálculo en este navegador. La dirección introducida no se abre ni se consulta.

Opciones

Solo HTTP(S). Host, esquema, puertos y segmentos de punto siguen al navegador. Los caracteres reservados siguen codificados; no se garantiza una URL canónica.

Entrada y base activa: 100.000 unidades UTF-16 cada una. Salida: 1.000.000.

Listo · 59 unidades · Parámetros: 3

Un normalizador de URL permite revisar direcciones de API copiadas con mayúsculas en el host, puertos predeterminados o segmentos de retroceso. El ejemplo muestra qué cambia antes de trabajar con tu propio enlace.

Si la base termina en /api/v1, añadir users puede significar resolver un enlace desde esa página o agregar un directorio al final. Aquí eliges la operación para que esa diferencia no quede oculta en una concatenación.

Por qué usar este normalizador de URL

Comparar sustitución y unión

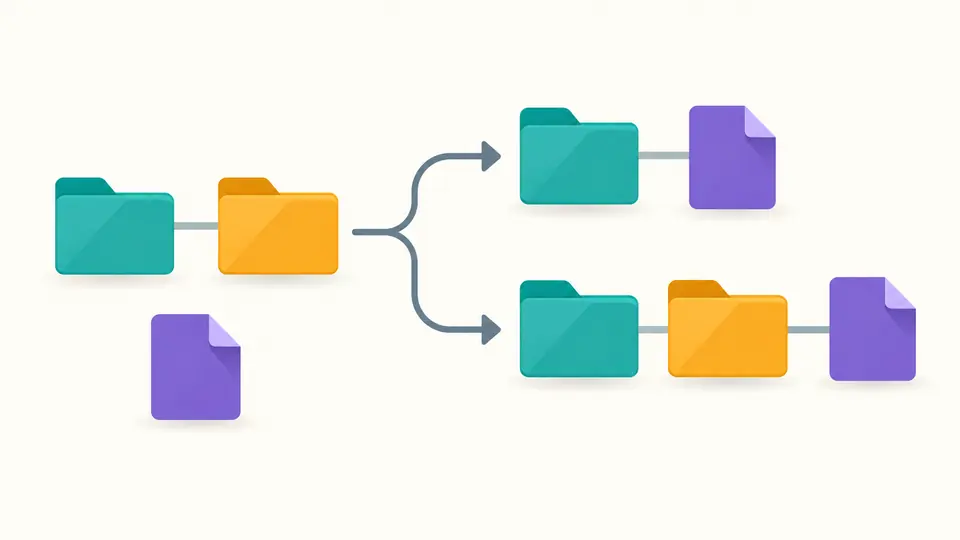
El normalizador de URL separa dos resultados posibles. Con https://example.com/api/v1 como base, resolver users produce /api/users; unir la ruta produce /api/v1/users. Comprueba así dónde espera tu aplicación el nuevo segmento.

Dos ramas sustituyen la última carpeta por un archivo o añaden el mismo archivo después de ambas carpetas.

Mantener el significado de los parámetros

Las claves tag repetidas conservan su orden. flag sigue siendo distinto de flag=, y + no se convierte en %20. La política de codificación no ordena la consulta ni elimina valores por su cuenta.

Etiquetas de consulta de colores mantienen su orden y el par repetido durante un ajuste de codificación.

Determina qué representa la dirección base

01

Distingue una dirección de una referencia

Para normalizar URL se requiere http:// o https:// explícito. Una URL relativa necesita Resolver y la dirección completa de la página de origen. Normalizar no utiliza el campo base ni inventa un protocolo para un dominio sin esquema.

02

Comprueba la barra final

Resolver trata el último segmento de una base sin / final como posición de archivo. Unir añade a toda la ruta y conserva la consulta y el fragmento de la base. La entrada de unión admite varios directorios, pero no ? ni #; esas referencias se procesan con Resolver.

03

Revisa antes de escribir sobre la entrada

La conversión automática espera 350 ms tras una edición. Si la desactivas, usa Ctrl/Cmd + Intro. Los resultados antiguos no se pueden exportar. Aplicar cambia a Normalizar y vacía la base; Deshacer recupera entrada, opciones y resultado anteriores.

Ajusta estructura y codificación por separado

Reglas del navegador para la estructura

El esquema y el host pasan a minúsculas. Se omiten los puertos 80 de HTTP y 443 de HTTPS; los demás permanecen. El navegador resuelve segmentos de punto, convierte dominios internacionales a ASCII/Punycode y codifica los caracteres Unicode de la ruta.

Tres políticas de codificación porcentual

Conserva la escritura analizada, convierte letras hexadecimales a mayúsculas o decodifica solo caracteres ASCII no reservados: letras, cifras y -._~. %2F, %3F y %23 siguen codificados. Tampoco se decodifica %252F de forma recursiva.

Ruta absoluta desde una referencia o una unión

Resolver entiende referencias al directorio superior, a la raíz, a una consulta o a un fragmento. Unir ajusta únicamente las barras del punto de conexión y conserva los // internos. Hereda la consulta de la base sin mezclar dos listas de parámetros.

Alcance y límites del resultado

No decide la URL canónica de un sitio
No examina páginas, redirecciones ni configuración del servidor. No fuerza HTTPS, modifica www, cambia mayúsculas de rutas, fusiona // internos ni ajusta la barra final. La serialización del navegador sigue activa. El texto por sí solo no demuestra que dos recursos sean equivalentes.
Conservar no garantiza los mismos bytes
No hay ordenación, eliminación de duplicados, filtros UTM ni limpieza de valores vacíos. El navegador y la política de escapes pueden alterar la escritura. Eliminar borra toda la consulta e informa por separado de un ? vacío. Verifica los enlaces firmados con las reglas de su aplicación.
Entradas estrictas de tipo HTTP(S)
Resolver y Unir siempre exigen una base absoluta válida. Se rechazan credenciales, controles, barras inversas, escapes % incorrectos y sustitutos Unicode sin pareja. Se recortan espacios externos; no se valida como UTF-8 cada secuencia de bytes correctamente escapada.
Unir no limita el acceso a directorios
La entrada no puede empezar por un esquema o // ni incluir ? o #. Una / inicial aislada se usa como unión. .. puede subir niveles, por lo que esto no es un control de acceso. Una ruta vacía conserva primero la base y después aplica las políticas.
Una dirección con límites de longitud
Entrada y base activa: 100.000 unidades UTF-16 cada una. Salida: 1.000.000. Superar el límite genera un error sin recortar el contenido. La vista crece en bloques de 20.000 unidades; copia y TXT incluyen todo el resultado vigente. No se admiten archivos por lotes.

Preguntas sobre el normalizador de URL

¿Cómo unir una URL absoluta y una URL relativa?

Coloca la dirección absoluta de la página en la base y la referencia relativa en la entrada; elige Resolver. Se aplican las reglas del navegador para directorios, padres y raíz. Para añadir detrás de todos los segmentos de la base, elige Unir ruta.

¿Por qué se sustituye el último segmento de la URL base al resolver una ruta relativa?

La base /a/b tiene /a/ como directorio actual, así que c se resuelve como /a/c. Con /a/b/ se obtiene /a/b/c. Unir ruta añade detrás del camino completo incluso sin barra final. No se trata de una pérdida aleatoria de texto.

¿La codificación porcentual de una URL distingue entre mayúsculas y minúsculas?

Dentro de un escape, %7e y %7E representan el mismo byte. Eso no vuelve insensible a mayúsculas toda la dirección: File y file pueden identificar recursos diferentes. Por eso el contenido de la ruta conserva su escritura.

¿Una barra y %2F son equivalentes en la ruta de una URL HTTP?

No se puede asumir. / delimita segmentos, mientras que %2F es un carácter reservado codificado. Servidores y enrutadores pueden tratarlos de forma distinta. Incluso la opción de decodificar caracteres no reservados mantiene %2F para no crear otro nivel de ruta.

¿El orden de los parámetros de una URL afecta al contenido duplicado en SEO?

La consulta por sí sola no permite determinar contenido duplicado ni la selección canónica del buscador. El orden también puede intervenir en firmas y lógica de la aplicación. Se conserva por defecto; la política del sitio debe basarse en el contenido y el comportamiento real del servidor.

¿Hay algún problema?

Comprueba el destino que esperas

Compara origen y resultado con el normalizador de URL. Confirma el modo y los elementos eliminados antes de copiar o aplicar la dirección a la entrada.