01
Das umgebende Zeichen wählen
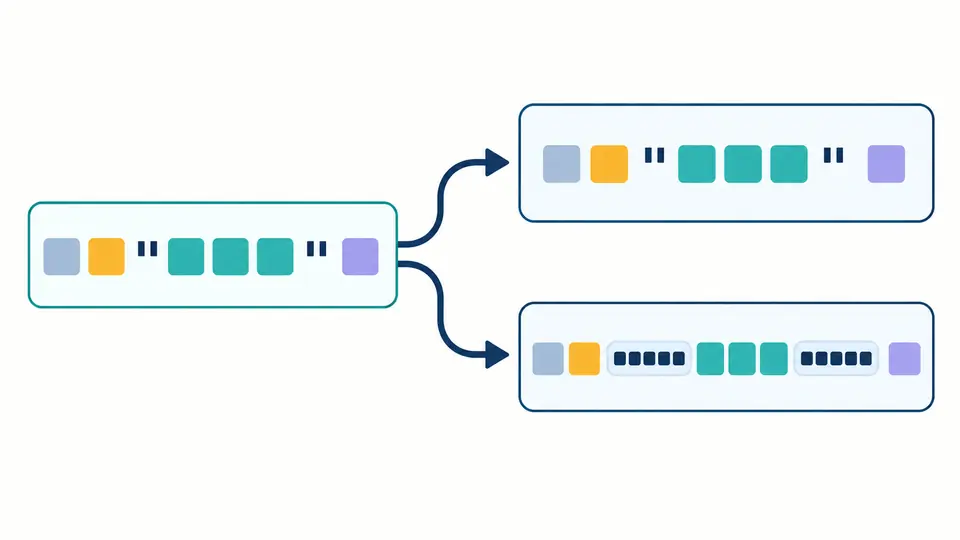
Textmodus lässt Anführungszeichen stehen. Im Attributmodus wählen Sie das tatsächlich umgebende einfache oder doppelte Anführungszeichen. Das Werkzeug ergänzt weder diese äußeren Zeichen noch Tags.
Werkzeuge für XML
Wählen Sie Textinhalt oder Attributwert als Ziel der Maskierung.
Die Verarbeitung erfolgt in diesem Browser; der Text wird nicht hochgeladen.
Der Kontext betrifft nur die Kodierung. Trennzeichen bleiben stehen; dekodierte Zeilenumbrüche gehören zum Wert. Der JSON-Bericht erhält die Datensatzgrenzen.
Eingabe ≤ 1.048.576, Ausgabe ≤ 6.291.456, Bericht ≤ 16.777.216 UTF-16-Einheiten; Stapel ≤ 10.000 Datensätze.
38 → 48 Einheiten · 3 Ersetzungen · 1 Datensätze
XML maskieren hilft, wenn ein kaufmännisches Und im Produktnamen einen Feed beschädigt oder Anführungszeichen in einen Attributwert sollen. Entscheidend ist, wo die Zeichenfolge später steht: Text und Attribute folgen unterschiedlichen Regeln.
XML dekodieren stellt genau eine Referenzschicht wieder her. Das Werkzeug liest keine Tags oder DTDs und bestätigt nicht die Gültigkeit eines vollständigen Dokuments.
Mit XML maskieren wird CR zur numerischen Referenz. Bei Attributen kommen TAB, LF und das gewählte Anführungszeichen hinzu. Das erhält den Wert in gewöhnlichen Attributen vom Typ CDATA.
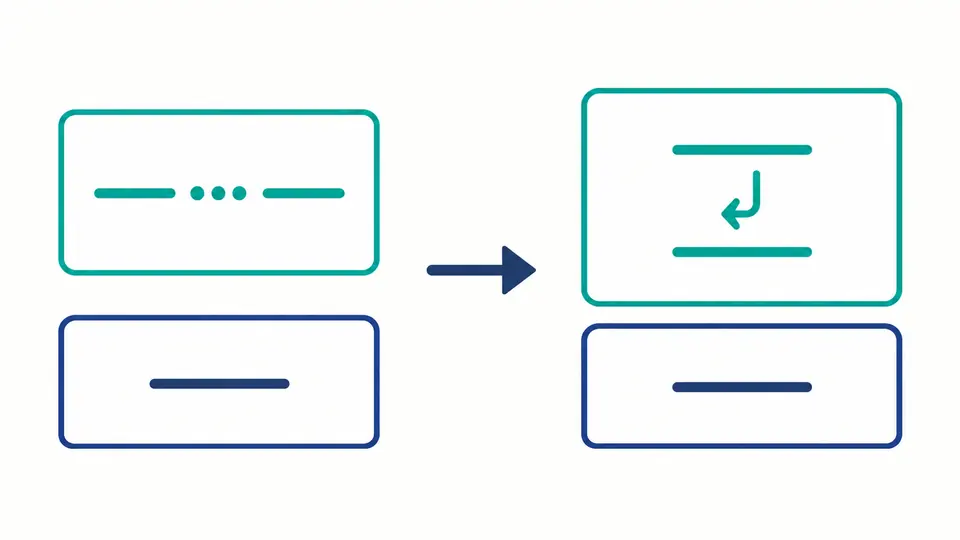
Eine dekodierte Zeilenumbruchreferenz kann innerhalb eines Werts eine neue Zeile erzeugen. Der JSON-Bericht speichert Eingabe, Ausgabe und ursprüngliches Trennzeichen für jeden Datensatz getrennt.
Textmodus lässt Anführungszeichen stehen. Im Attributmodus wählen Sie das tatsächlich umgebende einfache oder doppelte Anführungszeichen. Das Werkzeug ergänzt weder diese äußeren Zeichen noch Tags.
Nach einer Änderung vergehen 350 ms bis zur Umwandlung. Ohne Automatik erscheint die Schaltfläche; Ctrl/Cmd+Enter funktioniert ebenfalls. Jede Änderung sperrt den Export des alten Ergebnisses sofort.
Beispiel und Leeren zeigen eine Vorschau mit Zeichenanzahl. Erst Anwenden ersetzt die Eingabe. Ein Rückgängig stellt Eingabe und Ergebnis gemeinsam wieder her. Die Ausgabevorschau wächst um jeweils 20.000 Einheiten.
XML maskieren unterscheidet XML Entitäten von HTML-Namen. Der Decoder akzeptiert amp, lt, gt, quot und apos unter Beachtung der Großschreibung und mit abschließendem Semikolon.
A und A ergeben beide A. Das x im Präfix muss klein sein; die hexadezimalen Ziffern A–F dürfen groß oder klein sein. Umlaute und Emoji bleiben lesbar, ohne erzwungene ASCII-Ausgabe.
XML Sonderzeichen lassen sich maskieren. Verbotene XML-1.0-Zeichen werden dagegen auch als Zahlenreferenz nicht gültig. Die erste Fehlerstelle erscheint als ursprüngliche Zeile und UTF-16-Spalte; es gibt kein Teilergebnis.
XML besitzt nur fünf vordefinierte Namen. Viele HTML-Entitäten funktionieren daher nicht ohne zusätzliche Definition. Mit XML maskieren können Sie stattdessen gültige Zeichen oder numerische Referenzen wie   verwenden.
Eine numerische Referenz ist eine mögliche Schreibweise für gültige Zeichen ohne vordefinierten Namen. Sie ist nicht für jeden Umlaut erforderlich. Das Werkzeug verwendet sie außerdem für CR und für TAB/LF in Attributwerten.
Die Datenschutzhinweise stehen direkt unter dem Eingabebereich. Das Versenden von Feedback ist ein gesonderter Schritt; übernehmen Sie dort nur Inhalte, die Sie tatsächlich teilen möchten.
CDATA kann Text mit vielen Winkelklammern übersichtlicher machen. Es ist innerhalb eines Attributs nicht erlaubt und darf den Abschluss ]]> nicht enthalten. Dieses Werkzeug erzeugt keine CDATA-Blöcke.
Ein XML-Parser meldet ungültige oder nicht deklarierte Referenzen. Dieser Decoder stoppt ebenfalls bei Referenzfehlern; sein Erfolg ersetzt jedoch keine Prüfung des gesamten XML-Dokuments.
Etwas unklar?
Mit XML maskieren vergleichen Sie einen Wert mit &, Anführungszeichen und Zeilenumbruch in beiden Kontexten.