01
Dem Standardnamensraum einen Alias geben
Bei xmlns="urn:books" tragen Sie {"b":"urn:books"} ein und suchen mit //b:book. //book trifft nur Elemente ohne Namensraum.
XML-Werkzeuge
Mit der Schaltfläche oder Ctrl/Cmd+Enter auswerten. Nach Änderungen an Eingaben und Ansicht erneut starten.
XML und Abfragen werden in diesem Browser verarbeitet; das Dokument wird nicht an einen Server gesendet.
ASCII-Präfix verwenden, etwa {"b":"urn:books"}; im Original darf der Präfix anders lauten.
XPath 1.0; manuell mit Ctrl/Cmd+Enter. Skalare JSON-Werte sind Zeichenketten, damit NaN und Infinity erhalten bleiben.
Ergebnis veraltet. Für den Export erneut auswerten.
Ein XPath-Tester hilft, wenn eine Abfrage im Beispiel funktioniert, im echten XML aber nichts findet. Oft unterscheiden sich der Standardnamensraum, eine Attributbedingung oder die Tiefe eines Elements.
Sie können XPath testen, ohne das Dokument vorher zu formatieren. XPath-Ausdrücke laufen auf dem unveränderten Text; XML und seine Namensräume bleiben damit eine nachvollziehbare Grundlage für den Vergleich.
Der XPath-Tester zeigt dieselben Titel als XML-Fragmente, Textwerte oder absolute Pfade. So wird sichtbar, ob Sie ein Element ausgewählt haben oder nur seinen Text benötigen.
Binden Sie b an urn:books und verwenden Sie //b:book. Der Präfix im Dokument darf anders heißen. Gleichnamige Elemente mit einer anderen URI bleiben getrennt.
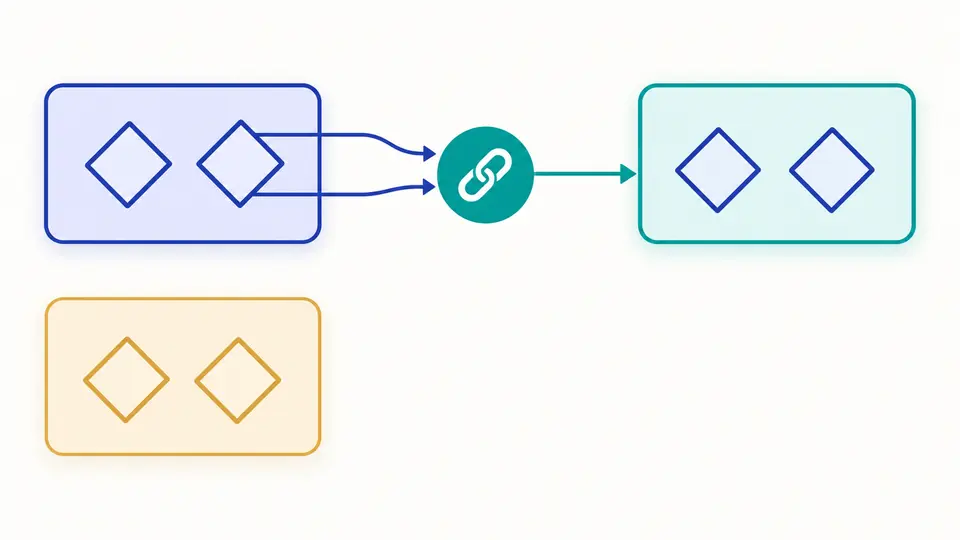
Bei xmlns="urn:books" tragen Sie {"b":"urn:books"} ein und suchen mit //b:book. //book trifft nur Elemente ohne Namensraum.
Die Textansicht liefert den vollständigen XPath-Zeichenkettenwert jedes Treffers einschließlich Nachfahren. //title/text() wählt dagegen direkte Textknoten aus; bei gemischtem Inhalt kann das Ergebnis abweichen.
Änderungen an XML, Ausdruck, Zuordnung oder Ansicht sperren den Export sofort. Nach erfolgreicher Auswertung zeigt die Vorschau jeweils 50 weitere Treffer. Kopie und Download enthalten alle erfolgreichen Ergebnisse.
Neben Knotenmengen sind string(//title), count(//book) und boolean(//missing) möglich. JSON enthält den Typ; Werte werden als Zeichenketten gespeichert, damit NaN und Infinity nicht unbemerkt zu null werden.
//book[@id="b1"] filtert Elemente, //@id liest Attribute und //book[price>15]/title prüft einen Zahlenvergleich. Kein Treffer ist ein gültiges Ergebnis mit count 0 und einem leeren values-Array.
Positionen unterscheiden gleichnamige Geschwister. Bei Namensräumen verwenden die Pfade local-name() und namespace-uri(), unabhängig von Ihrer Präfixzuordnung. Eine spätere Änderung der Dokumentstruktur kann Positionen verschieben.
Nein. Die tatsächliche Engine ist XPath 1.0 im Browser. Funktionen wie matches() benötigen eine andere Engine. Ein abgewiesener Ausdruck bedeutet nicht automatisch, dass das XML falsch ist.
//book[@id="b1"] wählt ein Element über sein Attribut aus. //book/@id liefert den Attributwert. Groß- und Kleinschreibung zählt; Attribute ohne Präfix erben keinen Standardnamensraum.
/ führt zum direkten nächsten Schritt. // sucht Nachfahren ab dieser Stelle: /library/book beginnt an der Wurzel, //book findet auch tiefer verschachtelte Elemente.
Ja: string(//title), count(//book) und boolean(//book). Der Export speichert Typ und Zeichenkettenwert. false, eine leere Zeichenkette und NaN sind erfolgreiche Ergebnisse.
Der Standardnamensraum gilt für unpräfigierte XML-Elemente, aber nicht für unpräfigierte Namen in XPath 1.0. Binden Sie einen Alias an die URI und verwenden Sie ihn im Ausdruck.
Etwas unklar?
Der XPath-Tester macht Typ und Namensraumzuordnung sichtbar. Bewahren Sie eine erfolgreiche Abfrage zusammen mit dem XML-Beispiel auf, um spätere Abweichungen reproduzieren zu können.