01
Nommer l’espace par défaut
Avec xmlns="urn:books", saisissez {"b":"urn:books"} et utilisez //b:book. Sans préfixe, //book ne sélectionne que les éléments sans espace de noms.
Outils XML
Évaluez avec le bouton ou Ctrl/Cmd+Enter. Relancez après toute modification des entrées, des associations ou de la vue.
Le XML et les requêtes sont traités dans ce navigateur ; aucun document n’est envoyé au serveur.
Utilisez un préfixe ASCII, par exemple {"b":"urn:books"} ; il peut différer du préfixe source.
XPath 1.0 ; exécution manuelle avec Ctrl/Cmd+Enter. Les scalaires JSON sont des chaînes pour conserver NaN et Infinity.
Résultat périmé : réévaluez avant d’exporter.
Un testeur XPath est utile lorsqu’une requête fonctionne sur un exemple mais ne trouve rien dans le vrai flux XML. L’espace de noms par défaut, une condition sur un attribut ou la profondeur d’un élément expliquent souvent cet écart.
Vous pouvez évaluer XPath sans reformater le document. Chaque expression XPath utilise le texte d’origine, ce qui permet de comparer les valeurs et les espaces de noms XML sans perdre les blancs significatifs.
Ce testeur XPath présente les mêmes titres comme fragments XML, valeurs textuelles ou chemins absolus. On distingue ainsi la sélection d’un élément de l’extraction de son contenu, sans réécrire la source.
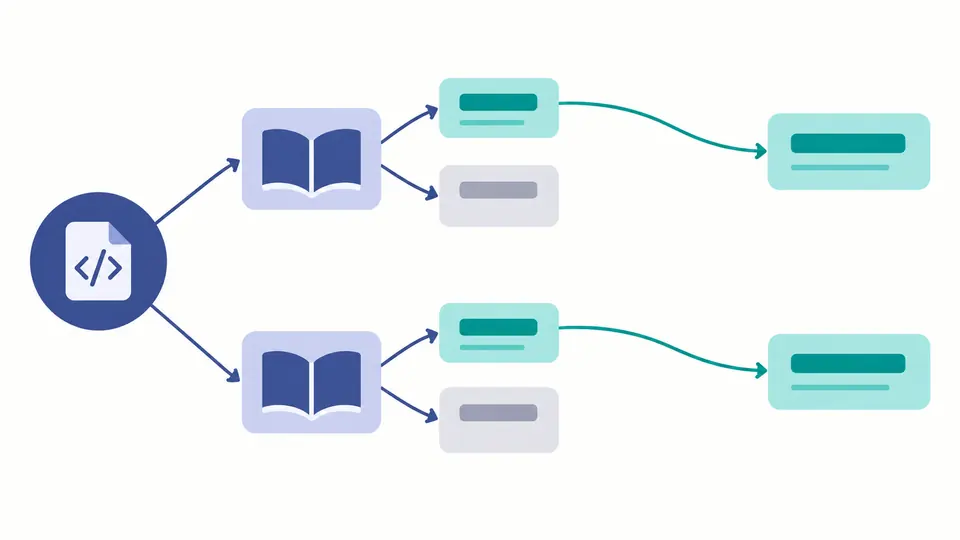
Associez b à urn:books et utilisez //b:book, même si le document emploie un autre préfixe. Les éléments portant le même nom local dans un autre espace restent distincts.
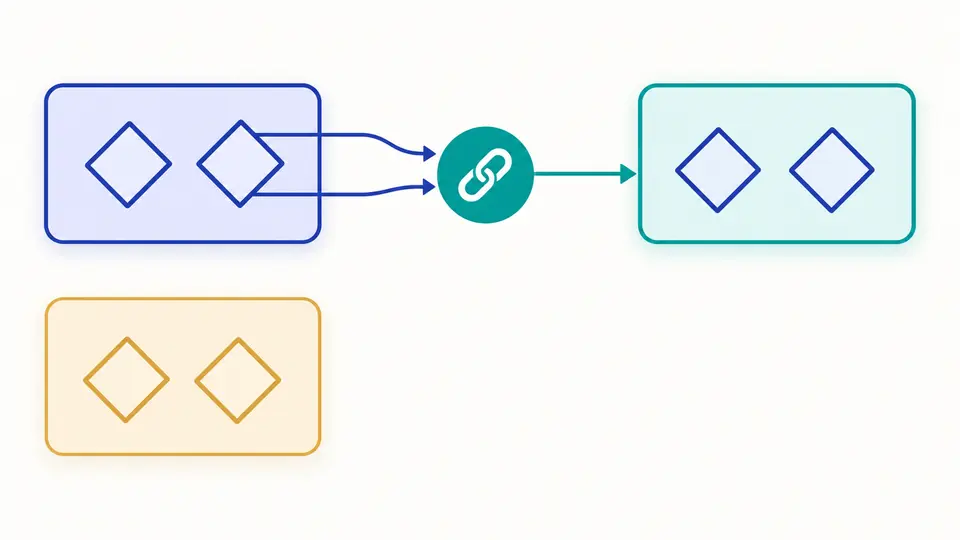
Avec xmlns="urn:books", saisissez {"b":"urn:books"} et utilisez //b:book. Sans préfixe, //book ne sélectionne que les éléments sans espace de noms.
La vue texte renvoie la valeur complète de chaque élément, descendants inclus. //title/text() sélectionne seulement les nœuds texte directs ; le contenu mixte peut donc donner des résultats différents.
Modifier XML, expression, associations ou vue désactive aussitôt les exports. Relancez la requête. L’aperçu progresse par 50 résultats ; la copie et le téléchargement contiennent tous les résultats réussis.
Outre les ensembles de nœuds, string(//title), count(//book) et boolean(//missing) produisent des scalaires. Le JSON conserve le type et représente les valeurs par des chaînes, afin que NaN et Infinity ne deviennent pas null.
//book[@id="b1"] filtre les éléments, //@id extrait les attributs et //book[price>15]/title applique une comparaison numérique. Zéro correspondance reste un succès : count vaut 0 et values est un tableau vide.
Les positions distinguent les frères de même nom. Pour les éléments avec espace de noms, local-name() et namespace-uri() rendent le chemin indépendant du préfixe choisi. Ces positions peuvent changer si la structure du document est modifiée.
Non. Le moteur réel est XPath 1.0 dans le navigateur. Des fonctions comme matches() exigent un autre moteur ; leur rejet ne signifie pas que le XML est incorrect.
//book[@id="b1"] sélectionne un élément selon son attribut ; //book/@id renvoie la valeur. La casse compte et les attributs sans préfixe n’héritent pas de l’espace de noms par défaut.
/ suit l’étape directe suivante. // recherche les descendants à partir de cette position : /library/book part de la racine, tandis que //book trouve aussi des éléments plus profonds.
Oui : string(//title), count(//book) et boolean(//book). L’export enregistre le type et la valeur textuelle. false, une chaîne vide et NaN sont des résultats valides.
L’espace par défaut s’applique aux éléments XML sans préfixe, mais pas aux noms sans préfixe de XPath 1.0. Associez un alias à l’URI, puis employez-le dans l’expression.
Une question demeure ?
Le testeur XPath rend visibles le type du résultat et les associations de noms. Conservez une expression réussie avec son exemple XML pour reproduire ensuite une différence.