01
Choisir le délimiteur extérieur
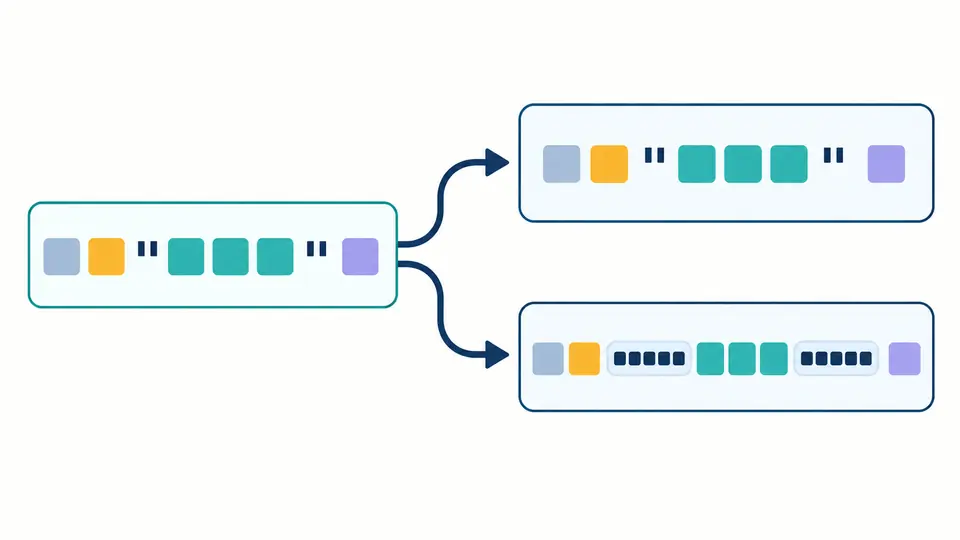
Le mode texte conserve les guillemets. Le mode attribut ne protège que le type choisi, simple ou double. Il n’ajoute ni guillemets extérieurs ni balise : le résultat reste un fragment de contenu.
Outils XML
Choisissez un nœud texte ou une valeur d’attribut avant la conversion.
Le traitement reste dans ce navigateur ; le texte n’est pas envoyé.
Le contexte concerne seulement l’encodage. Les séparateurs restent littéraux ; un saut de ligne décodé appartient à sa valeur. Le rapport JSON conserve les limites.
Entrée ≤ 1 048 576, sortie ≤ 6 291 456, rapport ≤ 16 777 216 unités UTF-16 ; lot ≤ 10 000 enregistrements.
38 → 48 unités · 3 remplacements · 1 enregistrements
L’échappement XML sert lorsqu’une esperluette dans un nom de produit casse un flux, ou qu’un guillemet doit entrer dans un attribut. Le texte d’un élément et la valeur d’un attribut ne demandent pas les mêmes remplacements.
Le décodage XML retire une seule couche de références. Il ne lit ni les balises ni une DTD et ne certifie pas la validité du document complet.
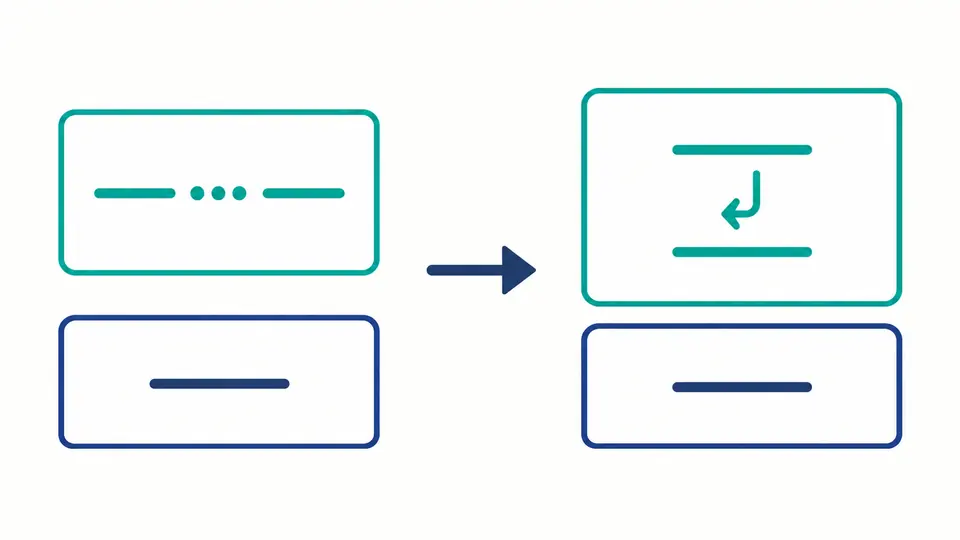
L’échappement XML écrit CR sous forme numérique. Dans un attribut, TAB, LF et le guillemet choisi sont aussi protégés, pour préserver la valeur dans un attribut ordinaire de type CDATA.
Une référence numérique peut rétablir un saut de ligne au milieu d’une valeur. Le rapport JSON sépare l’entrée, la sortie et le séparateur d’origine de chaque enregistrement.
Le mode texte conserve les guillemets. Le mode attribut ne protège que le type choisi, simple ou double. Il n’ajoute ni guillemets extérieurs ni balise : le résultat reste un fragment de contenu.
Le calcul démarre 350 ms après une modification. Désactivez l’automatisme pour afficher le bouton, ou utilisez Ctrl/Cmd+Enter. Toute modification bloque immédiatement l’export de l’ancien résultat.
Exemple et Effacer présentent un aperçu avec le nombre de caractères. Appliquer confirme ; Annuler restaure une fois l’entrée et le résultat précédents. L’aperçu long augmente par tranches de 20 000 unités.
L’échappement XML distingue les entités XML des noms HTML. Le décodage reconnaît amp, lt, gt, quot et apos, respecte la casse et exige le point-virgule final.
A et A redonnent tous deux A. Le préfixe hexadécimal exige un x minuscule ; les chiffres A–F peuvent être dans les deux casses. Les accents et emoji valides restent lisibles.
Les caractères spéciaux XML se représentent par des références, mais un caractère interdit reste interdit sous forme numérique. La première erreur indique la ligne et la colonne UTF-16 d’origine, sans résultat partiel.
Les noms prédéfinis sont amp, lt, gt, quot et apos. Ils représentent &, <, > et les deux guillemets. Cet échappement XML respecte leur casse et ne devine pas la signification d’un nom inconnu.
Utilisez une valeur décimale comme   ou hexadécimale comme  . Les caractères Unicode valides peuvent aussi rester littéraux ; les accents n’exigent pas systématiquement une référence. Un code interdit reste refusé.
Consultez l’indication de confidentialité sous la zone de saisie. Envoyer un retour est une action distincte : n’y joignez que les données que vous souhaitez partager.
CDATA peut rendre un texte riche en chevrons plus lisible, mais ne fonctionne pas dans un attribut et ne peut contenir sa terminaison ]]>. Cette page ne produit pas cette enveloppe.
Un analyseur XML signale les références incorrectes ou non déclarées. Le décodeur s’arrête également sur ces erreurs ; une conversion réussie ne vaut toutefois pas validation du document entier.
Une question demeure ?
Essayez l’échappement XML avec &, des guillemets et un saut de ligne, puis comparez les deux destinations.