01
Pon un alias al espacio predeterminado
Si aparece xmlns="urn:books", introduce {"b":"urn:books"} y consulta //b:book. //book solo selecciona elementos sin espacio de nombres.
Herramientas XML
Evalúa con el botón o Ctrl/Cmd+Enter. Tras cambiar entradas, asociaciones o vista, vuelve a ejecutar.
El XML y las consultas se procesan en este navegador; no se envía el documento a un servidor.
Usa un prefijo ASCII, por ejemplo {"b":"urn:books"}; puede ser distinto del original.
XPath 1.0; ejecución manual con Ctrl/Cmd+Enter. Los escalares JSON usan cadenas para conservar NaN e Infinity.
Resultado desactualizado; vuelve a evaluar para exportar.
Un probador de XPath ayuda cuando una consulta funciona en el ejemplo pero no encuentra nada en el XML real. Un espacio de nombres predeterminado, una condición de atributo o la profundidad del elemento pueden explicar la diferencia.
Puedes evaluar XPath sin formatear primero el documento. La expresión XPath trabaja sobre el texto original; así puedes comparar consultas XML sin eliminar espacios que influyen en el resultado.
Este probador de XPath muestra los mismos títulos como fragmentos XML, valores de texto o rutas absolutas. Así distingues el elemento elegido del texto que quieres extraer, sin modificar la fuente.
Vincula b con urn:books y usa //b:book aunque el documento emplee otro prefijo. Los elementos con el mismo nombre local y otra URI permanecen separados.
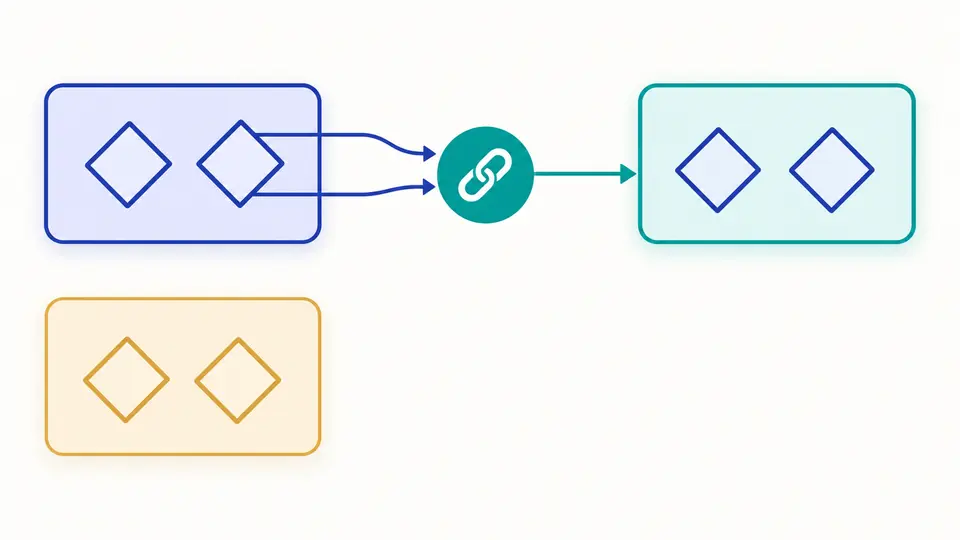
Si aparece xmlns="urn:books", introduce {"b":"urn:books"} y consulta //b:book. //book solo selecciona elementos sin espacio de nombres.
La vista de texto obtiene el valor completo de cada elemento, incluidos sus descendientes. //title/text() selecciona los nodos de texto directos; en contenido mixto no siempre produce lo mismo.
Cambiar XML, expresión, asociaciones o vista desactiva la exportación. Ejecuta de nuevo. La vista añade 50 resultados por vez; la copia y la descarga incluyen todos los resultados de la ejecución correcta.
Además de conjuntos de nodos, se admiten string(//title), count(//book) y boolean(//missing). El JSON guarda el tipo y usa cadenas para los valores, de modo que NaN e Infinity no se conviertan silenciosamente en null.
//book[@id="b1"] filtra elementos, //@id extrae atributos y //book[price>15]/title aplica una comparación numérica. Cero coincidencias es un resultado válido con count 0 y un array values vacío.
Las posiciones distinguen hermanos con el mismo nombre. Para elementos con espacio de nombres se usan local-name() y namespace-uri(), sin depender del prefijo elegido. Cambiar la estructura del documento puede desplazar esas posiciones.
XPath 1.0, mediante el motor real del navegador. Las funciones de XPath 2.0 como matches() requieren otro motor; que una expresión falle no implica que el XML sea incorrecto.
//book[@id="b1"] selecciona un elemento por atributo y //book/@id devuelve el valor. Los nombres distinguen mayúsculas; un atributo sin prefijo no hereda el espacio de nombres predeterminado.
/ avanza al paso directo siguiente. // busca descendientes desde esa posición: /library/book parte de la raíz, mientras que //book también alcanza niveles más profundos.
Sí: string(//title), count(//book) y boolean(//book). La exportación conserva el tipo y el valor como cadena. false, una cadena vacía y NaN son resultados correctos.
El espacio predeterminado se aplica a elementos XML sin prefijo, pero no a nombres sin prefijo en XPath 1.0. Asocia un alias a la URI y úsalo en la expresión.
¿Algo no está claro?
El probador de XPath deja visibles el tipo y las asociaciones de nombres. Guarda la expresión correcta junto con su muestra XML para reproducir diferencias posteriores.