01
Dê um alias ao namespace padrão
Se houver xmlns="urn:books", informe {"b":"urn:books"} e use //b:book. Sem prefixo, //book seleciona apenas elementos sem namespace.
Ferramentas XML
Execute pelo botão ou com Ctrl/Cmd+Enter. Ao mudar entradas, vínculos ou visualização, avalie novamente.
O XML e as consultas são processados neste navegador; o documento não é enviado a um servidor.
Use um prefixo ASCII, como {"b":"urn:books"}; ele pode ser diferente do prefixo original.
XPath 1.0; execução manual com Ctrl/Cmd+Enter. Escalares JSON usam strings para preservar NaN e Infinity.
Resultado desatualizado; avalie novamente para exportar.
Um testador de XPath ajuda quando uma expressão funciona no exemplo, mas não encontra nada no XML real. O namespace padrão, uma condição de atributo ou a profundidade do elemento podem explicar a diferença.
Você pode testar XPath sem formatar o documento antes. A expressão XPath usa o texto original, permitindo comparar uma consulta XML sem apagar espaços que influenciam o conteúdo selecionado.
Este testador de XPath mostra os mesmos títulos como fragmentos XML, valores de texto ou caminhos absolutos. Assim você distingue o elemento selecionado do conteúdo que deseja extrair, sem alterar a fonte.
Vincule b a urn:books e use //b:book, mesmo que o documento tenha outro prefixo. Elementos com o mesmo nome local em namespaces diferentes continuam separados.
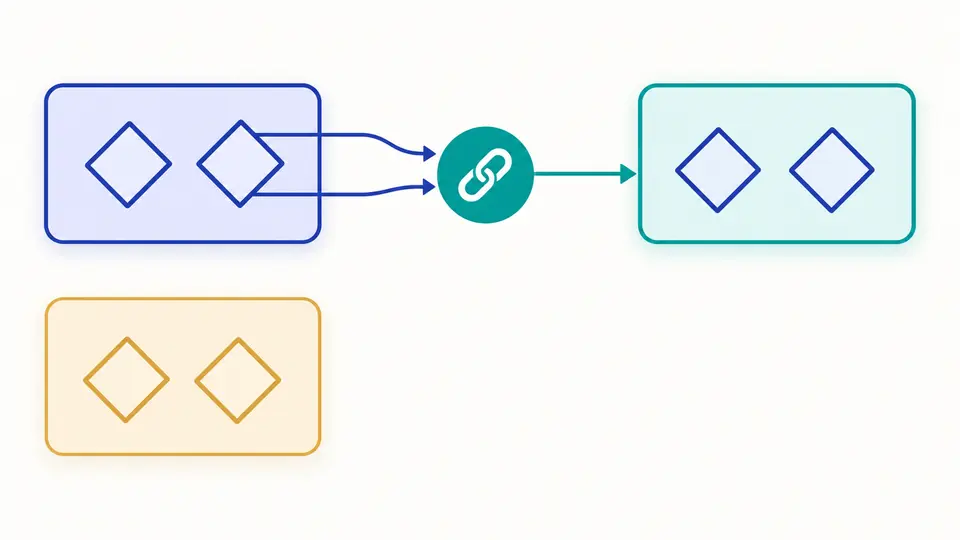
Se houver xmlns="urn:books", informe {"b":"urn:books"} e use //b:book. Sem prefixo, //book seleciona apenas elementos sem namespace.
A visualização de texto usa o valor completo de cada elemento, incluindo descendentes. //title/text() seleciona somente os nós de texto diretos; conteúdo misto pode gerar resultados diferentes.
Mudar XML, expressão, vínculos ou visualização desativa a exportação. Execute de novo. A tela acrescenta 50 resultados por vez; a cópia e o download incluem todos os resultados da execução bem-sucedida.
Além de conjuntos de nós, são aceitos string(//title), count(//book) e boolean(//missing). O JSON registra o tipo e armazena os valores como strings, preservando NaN e Infinity em vez de transformá-los em null.
//book[@id="b1"] filtra elementos, //@id extrai atributos e //book[price>15]/title aplica uma comparação numérica. Nenhuma correspondência ainda é sucesso, com count 0 e um array values vazio.
Posições distinguem irmãos de mesmo nome. Elementos com namespace usam local-name() e namespace-uri(), sem depender do prefixo configurado. Os caminhos correspondem ao documento atual; alterações na estrutura podem mudar as posições.
Vincule cada URI a um prefixo no JSON, por exemplo {"a":"urn:one","b":"urn:two"}, e use os prefixos na expressão. Eles não precisam coincidir com os prefixos do arquivo, mas as URIs devem ser exatas.
Em XML bem formado, //DIV/a seleciona filhos a de DIV e //DIV//a alcança descendentes. A caixa importa. Esta página não corrige HTML: feche as tags e escape entidades, ou use uma ferramenta própria para HTML.
Selecione o caminho do campo, como /library/book/title. Para obter seu conteúdo, escolha valores de texto e execute novamente. string(//title) retorna apenas o valor do primeiro título, não uma lista de todos eles.
Use / para filhos diretos, como /library/book, ou // para descendentes. Para extrair texto de cada elemento, selecione os nós e escolha a visualização de texto; text() sozinho não inclui texto de elementos internos.
Não. O mecanismo real é XPath 1.0 do navegador. Funções como matches() exigem outro mecanismo; uma expressão não suportada não prova que o XML esteja errado.
Ficou alguma dúvida?
O testador de XPath deixa claros o tipo e os vínculos de namespace. Guarde a expressão que funcionou junto com o XML de exemplo para reproduzir diferenças futuras.