01
Préparer la bonne structure
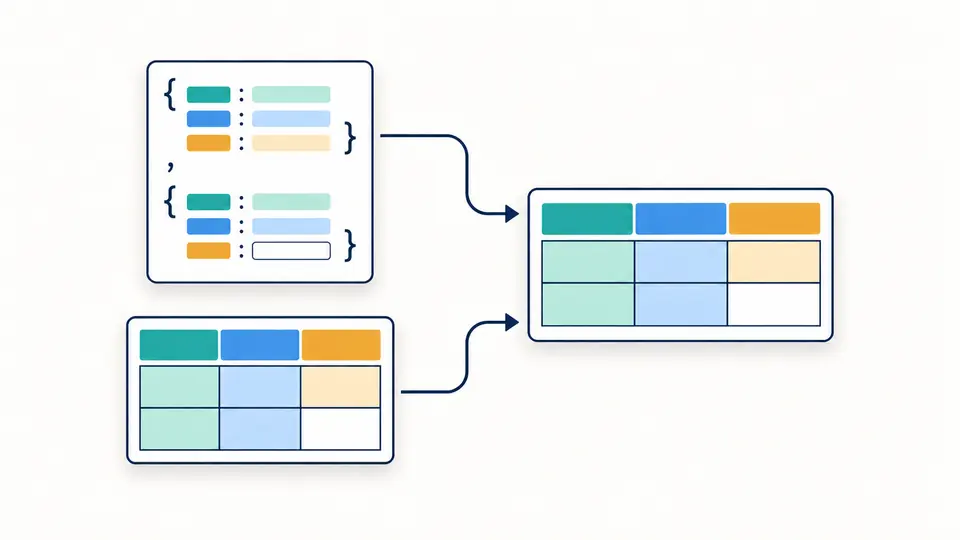
Le CSV exige un en-tête ; le JSON exige un tableau d’objets, même pour une seule ligne. Changer de format ne réécrit pas le texte.
- Appliquer un exemple réinitialise aussi les options et correspondances.
Outils de bases de données et SQL
Préparez des INSERT pour une table existante à partir d’un tableau JSON ou d’un CSV avec en-tête.
Les données restent dans ce navigateur, sans envoi ni connexion à une base.
Un seul identifiant, limité à 63 octets UTF-8. Le point fait partie du nom et ne sépare pas un schéma.
Toutes les colonnes sont conservées dans leur ordre de découverte. Le renommage ne modifie pas la source.
idnameactivenoteLimites : 1000 lignes, 100 colonnes, 50 000 cellules, 500 000 caractères en entrée et 2 000 000 en sortie.
Résultat périmé. Régénérez-le avant de l’exporter.
JSON vers SQL sert à transformer une réponse API en jeu de données de test reproductible. Un identifiant entre guillemets reste du texte, même s’il ne contient que des chiffres.
L’exemple contient une apostrophe, des caractères Unicode, un booléen et une valeur absente. Vérifiez ces cas avant d’adapter les noms à votre schéma.
Vérifiez séparément les correspondances et les lots.
JSON vers SQL rassemble les clés dans leur ordre de première apparition. Chaque colonne cible peut être renommée et typée. Une clé absente produit NULL sans décaler les valeurs suivantes.
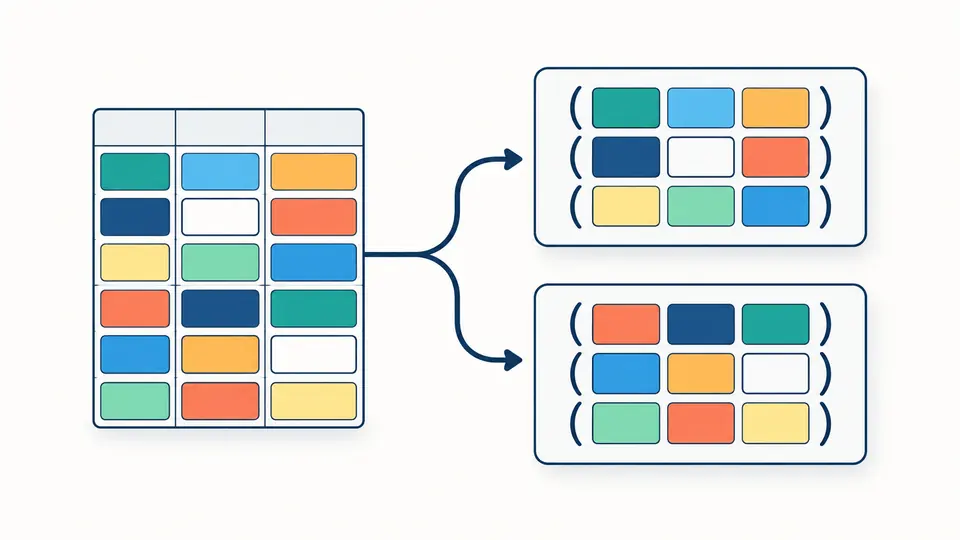
Un lot d’une ligne produit une instruction par enregistrement. Un lot plus grand réunit plusieurs tuples VALUES. Les compteurs de lignes et d’instructions permettent de vérifier ce changement de présentation.
Le CSV exige un en-tête ; le JSON exige un tableau d’objets, même pour une seule ligne. Changer de format ne réécrit pas le texte.
Le mode automatique conserve les chaînes JSON. En CSV, seuls les nombres stricts et true/false sont reconnus ; 007, les dates et le mot NULL restent du texte.
La conversion automatique attend 350 ms. Toute modification bloque immédiatement l’export de l’ancien résultat.
PostgreSQL utilise des chaînes E, SQL Server des chaînes Unicode N. Avec MySQL, les valeurs contenant une barre oblique inverse ou un caractère de contrôle deviennent des littéraux hexadécimaux UTF-8, indépendants du mode d’échappement.
Ce convertisseur JSON conserve les jetons numériques d’origine, y compris les grands entiers et les longues décimales. Un type nombre imposé vérifie la syntaxe sans conversion flottante JavaScript. La colonne du serveur détermine toujours la précision stockée.
Les cellules CSV vides peuvent devenir NULL ou des chaînes vides. Les clés JSON absentes et null donnent toujours NULL. Les instructions INSERT regroupent de 1 à 1000 lignes ; des marqueurs de transaction peuvent encadrer le script entier.
JSON vers SQL garde les types natifs : chaîne, nombre, booléen ou null. Pour le CSV, seuls les nombres décimaux stricts et true/false sont inférés. Vous pouvez imposer texte, nombre ou booléen à une colonne, mais une valeur incompatible arrête la génération.
Le choix modifie les guillemets des identifiants, les littéraux de chaîne, les booléens et les marqueurs de transaction. PostgreSQL, MySQL, SQLite et SQL Server sont disponibles. La compatibilité avec votre schéma reste à vérifier.
Toutes les clés rencontrées composent la liste des colonnes. Pour chaque objet, une clé absente produit NULL à sa position. Une valeur JSON null fait de même, tandis qu’une chaîne vide reste une chaîne vide.
Oui. Entourez le champ de guillemets doubles et doublez les guillemets internes. Les séparateurs et retours à la ligne contenus dans le champ sont conservés. Les erreurs de citation ou de largeur sont signalées avec une ligne source lorsque disponible.
Jusqu’à 1000 lignes de données, 100 colonnes et 50 000 cellules. Les plafonds sont de 500 000 caractères en entrée et 2 000 000 en sortie. Un dépassement provoque une erreur, jamais une troncature ou un export incomplet.
Un problème de mise en forme ?
Utilisez JSON vers SQL sur quelques lignes représentatives, vérifiez les colonnes cibles puis copiez ou téléchargez le script complet.