01
헤더와 배열 구조 맞추기
CSV 첫 행은 헤더여야 합니다. JSON은 한 행이어도 객체 배열로 입력합니다. 형식 선택은 원문을 자동으로 바꾸지 않습니다.
- 예제를 적용하면 입력과 함께 옵션과 매핑도 초기화됩니다.
데이터베이스 및 SQL 도구
기존 테이블에 맞춰 입력 형식, 대상 열과 타입을 확인하세요.
입력은 이 브라우저에서 처리하며 데이터베이스 연결이나 업로드를 하지 않습니다.
하나의 식별자로 처리합니다. UTF-8 기준 최대 63바이트이며 점은 스키마 구분자가 아니라 이름의 일부입니다.
모든 열이 발견 순서대로 출력됩니다. 이름 변경은 대상에만 적용되고 원본은 바뀌지 않습니다.
idnameactivenote제한: 데이터 1000행, 100열, 50,000셀, 입력 500,000자, 출력 2,000,000자.
결과가 오래되었습니다. 다시 생성한 뒤 내보내세요.
JSON to SQL 변환기는 API 응답으로 반복 가능한 테스트 데이터를 준비할 때 유용합니다. 따옴표로 감싼 고객 번호와 실제 숫자는 같은 자릿수여도 서로 다른 값입니다.
예제에서 작은따옴표, 유니코드, 불리언과 빈 값을 먼저 확인하세요. 이후 테이블과 열 이름을 실제 스키마에 맞추면 실수를 찾기 쉽습니다.
열의 대응과 배치 구성을 따로 검토합니다.
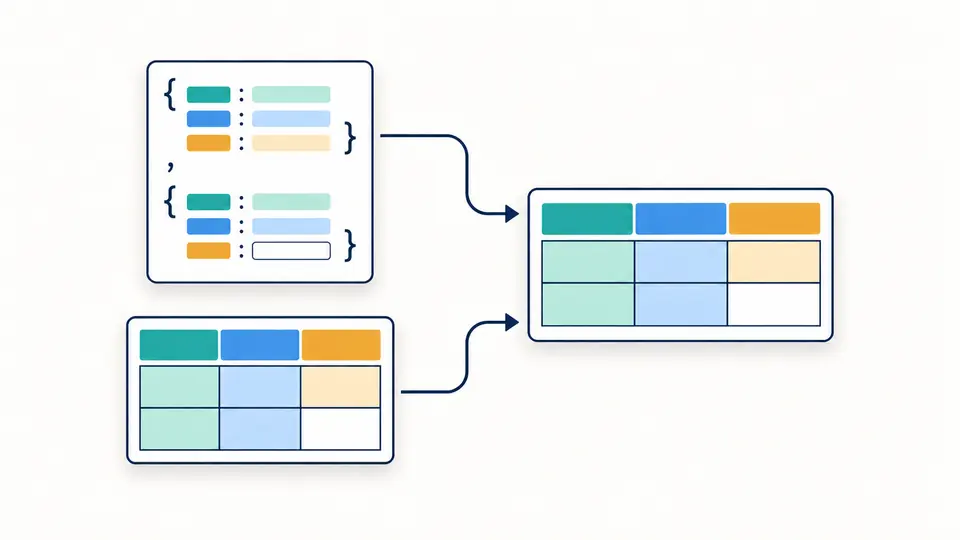
JSON to SQL 변환기는 모든 객체의 키를 처음 나타난 순서로 모읍니다. 대상 이름과 타입을 열별로 지정하며 빠진 키는 NULL이 되어 다른 값의 위치가 밀리지 않습니다.
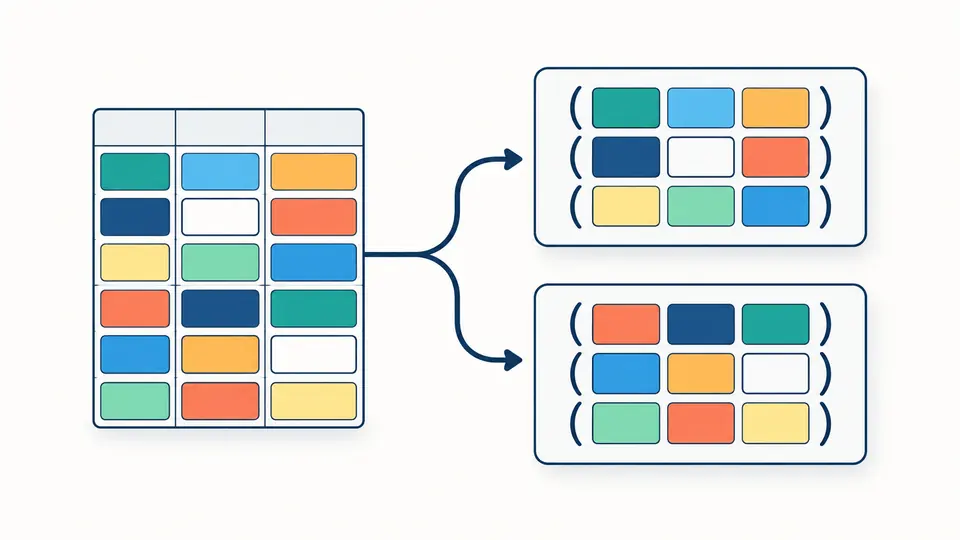
배치 크기 1은 개별 문장을 만들고 더 큰 값은 여러 행을 VALUES로 묶습니다. 데이터 행 수와 INSERT 개수를 함께 보면 분할 결과를 확인할 수 있습니다.
CSV 첫 행은 헤더여야 합니다. JSON은 한 행이어도 객체 배열로 입력합니다. 형식 선택은 원문을 자동으로 바꾸지 않습니다.
자동 타입은 JSON 문자열을 보존합니다. CSV는 엄격한 숫자와 true/false만 추론하며 007, 날짜, NULL 글자는 텍스트로 둡니다.
자동 변환은 변경 후 350ms를 기다립니다. 입력이나 옵션을 수정하는 즉시 이전 결과의 내보내기가 잠깁니다.
PostgreSQL은 E 문자열, SQL Server는 유니코드 N 문자열을 사용합니다. MySQL에서 역슬래시나 제어 문자가 있는 값은 UTF-8 16진 리터럴로 출력해 SQL 모드에 따른 해석 차이를 피합니다.
INSERT 문 생성 과정에서 JSON 숫자를 JavaScript 부동소수점으로 바꾸지 않습니다. 큰 정수와 긴 소수 표기를 그대로 유지하며 강제 숫자 타입도 십진 구문만 검사합니다. 실제 저장 정밀도는 데이터베이스 열에 따라 달라집니다.
빈 CSV 셀은 NULL 또는 빈 문자열로 선택할 수 있습니다. JSON null과 없는 키는 항상 NULL입니다. 문장당 1–1000행을 묶고 전체 스크립트에 트랜잭션 시작과 커밋 구문을 추가할 수 있습니다.
JSON to SQL 변환기는 자동 모드에서 JSON의 문자열, 숫자, 불리언과 null을 그대로 구별합니다. CSV에는 고유 타입이 없어 엄격한 십진수와 true/false만 추론합니다. 열 타입을 강제로 바꿀 때 부적합한 값이 있으면 오류를 표시합니다.
식별자의 따옴표, 문자열 리터럴, 불리언과 트랜잭션 구문이 달라집니다. PostgreSQL, MySQL, SQLite, SQL Server 중 선택할 수 있으나 실제 서버나 스키마를 검사하지는 않습니다.
아니요. 객체 배열 안의 값은 문자열, 숫자, 불리언 또는 null이어야 합니다. 중첩 값을 자동으로 펼치거나 JSON 문자열로 넣지 않습니다. 먼저 대상 열 구조를 정한 뒤 입력을 정리하세요.
여러 데이터 행을 하나의 INSERT 안에 묶는 기능입니다. 1로 설정하면 행마다 문장을 만듭니다. 기본값은 100이며 최대 1000입니다. 묶음 크기를 바꿔도 행이나 값은 제거하지 않습니다.
가능합니다. 필드를 큰따옴표로 감싸고 내부 큰따옴표는 두 번 써야 합니다. 필드 안의 쉼표와 줄 바꿈은 값으로 보존하며, 잘못된 인용이나 열 수 불일치는 오류로 보고합니다.
서식 문제를 발견했나요?