01
인코딩과 첫 레코드 확인
UTF-8과 시작 BOM을 지원합니다. 구분 문자와 헤더 여부를 확인하세요. 파일 교체·예제·비우기는 바이트 변화를 미리 본 뒤 적용하며 되돌리면 이전 입력, 설정, 결과를 복원합니다.
가져오기 한도에 맞게 준비
UTF-8 CSV 또는 TSV 파일 하나를 선택하고 분할 기준과 결과를 확인하세요.
파일이나 예제를 선택한 다음 분할하세요.
UTF-8만 지원. 입력과 누적 출력 각각 128MiB, 레코드 하나 1MiB, 1,000열, 256파일까지. Blob과 ZIP에는 추가 메모리가 필요합니다.
아직 생성된 파일이 없습니다.
파일은 현재 브라우저에서 읽고 처리하며 업로드하지 않습니다.
파일이나 예제를 선택한 다음 분할하세요.
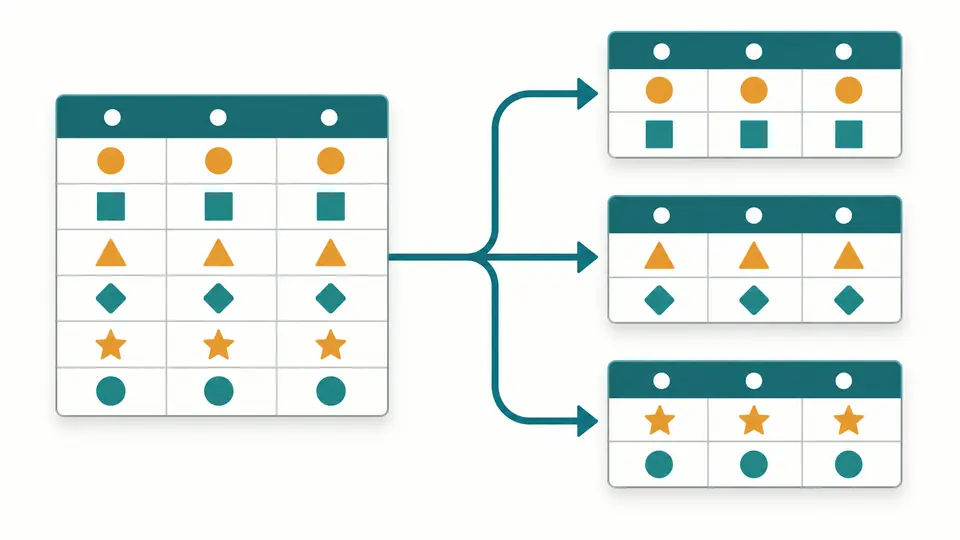
가져오기 서비스가 열 구조는 받아들이지만 레코드 수를 제한한다면 CSV 분할로 작은 묶음을 만들 수 있습니다. 표를 열어 같은 헤더를 여러 번 붙여 넣을 필요가 없습니다.
텍스트 줄바꿈 하나가 항상 레코드 하나는 아닙니다. 따옴표 안에 여러 줄 메모가 있으면 전체를 같은 필드로 읽어 한 레코드가 중간에서 갈라지지 않게 합니다.
CSV 분할에서 헤더를 켜면 첫 레코드를 모든 결과에 반복합니다. 기본 1,000은 헤더를 뺀 데이터 수이며 마지막 파일에는 더 적은 레코드가 들어갈 수 있습니다.
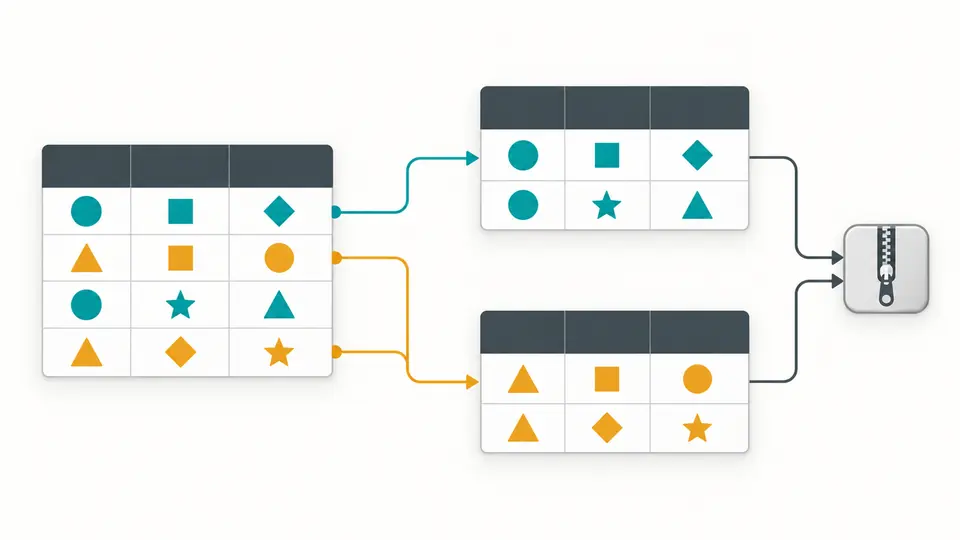
지역이나 상태 값이 같은 행을 원본 위치에 관계없이 모읍니다. 기준으로 고른 열뿐 아니라 모든 열을 유지하므로 각 담당자에게 완전한 레코드를 전달할 수 있습니다.
UTF-8과 시작 BOM을 지원합니다. 구분 문자와 헤더 여부를 확인하세요. 파일 교체·예제·비우기는 바이트 변화를 미리 본 뒤 적용하며 되돌리면 이전 입력, 설정, 결과를 복원합니다.
기본은 파일당 데이터 1,000개이고 크기 모드는 1MiB입니다. 열 위치는 1부터 세므로 헤더가 비어 있거나 중복되어도 정확한 위치를 지정할 수 있습니다.
버튼이나 Ctrl/Cmd + Enter로 실행하세요. 설정 변경 시 다운로드가 잠기며 다시 실행해야 합니다. 레코드 수와 바이트, 경고를 확인한 뒤 필요한 파일이나 ZIP을 저장하세요.
인용된 쉼표와 줄바꿈은 필드에 남습니다. 헤더는 데이터 수에 포함하지 않으며 헤더만 있는 입력도 데이터 0개의 파일 하나를 만듭니다.
UTF-8 직렬화와 반복 헤더를 계산합니다. 레코드 하나와 헤더만으로 목표를 넘으면 해당 레코드를 별도 파일로 보존하고 초과를 알립니다.
대소문자, 공백, 앞자리 0을 구분하여 001과 1은 다른 그룹입니다. 빈 문자열도 그룹이 됩니다. 파일명은 part-001.csv처럼 안전한 번호를 사용합니다.
각 파일의 첫 5개 데이터, 10개 열, 필드당 200자까지만 표시합니다. CSV 분할기 다운로드는 모든 레코드와 필드를 담고 ZIP은 압축 없는 STORE 방식입니다.
네. CSV 분할은 사용 요금 없이 실행할 수 있습니다. 다만 무료라는 뜻이 처리 용량 무제한을 의미하지는 않으며 페이지에 표시된 파일과 레코드 한도가 적용됩니다.
아니요. 선택한 데이터의 읽기와 분할은 현재 브라우저 안에서 이루어집니다.
원본은 128MiB까지이며 모든 결과의 합에도 별도 128MiB 한도가 있습니다. 단일 레코드, 열, 파일 개수 제한이나 브라우저 메모리 때문에 먼저 중단될 수도 있습니다.
기본 설정에서는 첫 레코드를 각 파일에 복제합니다. 헤더 없는 데이터라면 옵션을 끄세요. 그러면 첫 레코드도 일반 데이터로 포함됩니다.
계정이나 로그인이 필요하지 않습니다. 예제로 기준을 확인하거나 로컬 파일을 선택한 후 바로 실행할 수 있습니다.
예상과 다른 결과가 나왔나요?