01
크롤러 이름을 정합니다
기본값은 Googlebot입니다. 전용 그룹이 있으면 User-agent: *의 규칙을 상속하지 않습니다. 전체 HTTP 헤더가 아닌 제품 토큰을 사용하세요.
크롤링 제어
robots.txt 초안을 편집하고 크롤러와 URL 경로 하나를 지정하세요. 실제 사이트에는 접속하지 않습니다.
크롤링 허용
가장 긴 규칙이 이기며 동률이면 Allow가 우선합니다.
규칙은 이 브라우저 탭에서 처리하며 사이트로 요청하지 않습니다.
현재 초안 검사 완료
넓은 Disallow를 추가하고도 공개 경로가 열려 있어야 할 때가 있습니다. robots.txt 생성기는 규칙을 미리 보여 준 뒤 원문에 추가하고, 그 원문으로 결과를 검사합니다.
별도의 robots.txt 검사기로 옮길 필요 없이 크롤링 규칙 테스트의 선택 그룹과 승리한 줄을 확인할 수 있습니다. 사이트맵 URL은 표시하지만 접근 허용 여부에는 섞지 않습니다.
추측 대신 적용된 그룹과 줄을 보여 줍니다.
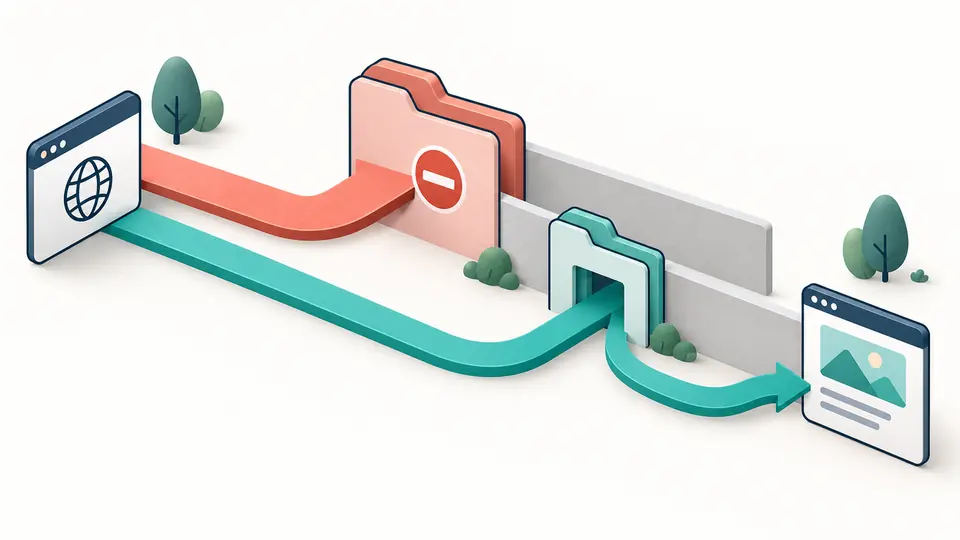
예시의 /private/는 차단되지만 /private/public/은 더 길어서 그 아래 페이지를 허용합니다. robots.txt 생성기에서 수정한 뒤 테스트 결과의 Allow 줄 번호를 확인하세요.
새 User-agent 그룹을 미리 본 뒤 원문 끝에 추가합니다. 이 원문으로 경로를 검사하고 동일한 robots.txt를 저장하므로 생성 결과와 테스트 대상이 어긋나지 않습니다.
기본값은 Googlebot입니다. 전용 그룹이 있으면 User-agent: *의 규칙을 상속하지 않습니다. 전체 HTTP 헤더가 아닌 제품 토큰을 사용하세요.
전체 URL을 입력해도 경로와 쿼리만 비교합니다. 자동 검사는 수정 후 350밀리초 기다립니다. 끄면 검사 버튼이나 Ctrl/Cmd + Enter를 사용하세요.
허용 여부와 그룹, 결정적인 규칙의 줄 번호를 읽으세요. 입력을 바꾸면 이전 결과는 낡은 것으로 표시되고 복사·다운로드가 일시 중지됩니다.
동일 토큰의 여러 그룹은 검사할 때 합치지만, Googlebot 그룹과 통배 그룹은 합치지 않습니다.
경로 접두사, * 와 끝의 $를 처리합니다. 일치 길이가 같으면 Allow가 Disallow보다 우선합니다.
유효한 절대 Sitemap URL은 줄 번호와 함께 표시합니다. 알 수 없는 지시문과 잘못된 경로는 알리고 원문은 유지합니다.
크롤러가 어떤 경로를 요청할 수 있는지 알려 주는 공개 텍스트 파일입니다. 이 페이지는 그 내용을 로컬에서 작성하고 한 경로에 적용해 봅니다.
선택된 User-agent 그룹에서 경로가 가장 길게 일치하는 규칙이 이깁니다. 길이가 같다면 Allow가 우선입니다.
일부 크롤러에게 요청 간 대기 시간을 제안합니다. Googlebot은 이를 무시하며, 이 도구도 접근 허용 판정에 반영하지 않습니다.
Sitemap 줄은 크롤러에 사이트맵 주소를 알려 줍니다. 완전한 HTTP(S) 주소를 입력하면 결과에 따로 표시되며 경로 허용에는 영향을 주지 않습니다.
아니요. 크롤링을 막아도 외부 링크로 알려진 URL은 검색에 남을 수 있습니다. 검색 제외에는 접근 가능한 페이지의 noindex를 검토하세요.
규칙 결과가 이해되지 않나요?