01
先确认爬虫身份
默认测试 Googlebot。若有专属 User-agent 组,它不会继承通配组的规则;请输入产品令牌,不要粘贴完整浏览器请求头。
抓取控制
编辑本地 robots.txt 草稿,指定一个爬虫和路径;页面不会请求目标网站。
允许抓取
最长的匹配规则生效;同长时 Allow 优先。
规则只在当前浏览器标签中处理,不请求目标网站。
当前草稿已测试。
准备更新网站的抓取规则时,最怕一条宽泛的 Disallow 连公开页面也拦住。robots.txt 测试工具用同一份草稿解释指定路径为何允许或禁止,而不是让你凭规则顺序猜。
这里还提供 robots.txt 生成器:新规则组先预览,再追加到原文;注释与未知指令原样保留。做 robots.txt 规则测试时,可直接看到 Allow Disallow 匹配的决定性行。
把抓取判定与文件生成放在同一份可编辑文本里。
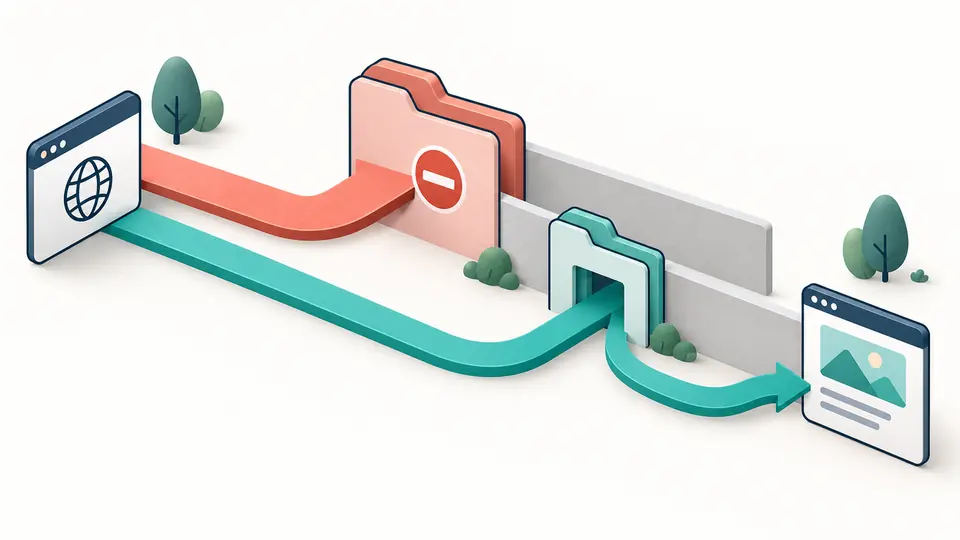
robots.txt 测试工具用示例演示:/private/ 被禁止,但 /private/public/page 命中更长的 Allow: /private/public/,因此允许抓取。结果会指出生效的原文行号。
为 User-agent 添加规则与 Sitemap 时,先核对生成文本和条目数量,再写回编辑器。测试结果与下载文件共用此文本;Sitemap 会单列展示,却不改变路径许可。
默认测试 Googlebot。若有专属 User-agent 组,它不会继承通配组的规则;请输入产品令牌,不要粘贴完整浏览器请求头。
输入 /private/public/page,或输入完整网址只取路径与查询部分。自动测试在停止修改约 350 毫秒后执行;关掉开关可用按钮或 Ctrl/Cmd + Enter。
结果给出匹配组、胜出的 Allow 或 Disallow 及行号。被忽略的错误行另外提示;改动后旧结果会过期,复制与下载会暂时禁用。
同名组的规则参与合并判定;有 Googlebot 专属组时,不会再叠加 User-agent: *。这常是“明明写了禁止却被允许”的原因。
支持路径前缀、* 通配符和末尾 $ 锚点。匹配的规则越长越优先;同样具体时 Allow 优先。
有效的绝对 Sitemap 网址显示行号。拼错的指令和路径格式问题会提示,但原文不会被工具悄悄改写。
粘贴文件,输入 User-agent 和路径。结果同时显示允许或禁止、匹配组、决定性规则及其行号。
比较匹配路径的长度;更长的规则生效。长度相同则 Allow 优先,与规则在文件里的先后位置无关。
能。结果会标出胜出的指令及原文行号;若没有适用规则,会明确说明默认允许的原因。
不会。草稿、测试路径和判定都在浏览器内处理,本页也不自动抓取网站。复制和下载只在你主动操作时执行。
它不抓线上 robots.txt、不爬整站、不改服务器,也不保证搜索引擎的实际缓存和收录状态。它只测试当前输入的一份文本。
对规则结果有疑问?