01
Identifier le robot
Googlebot est proposé au départ. Un groupe précis ne récupère pas les règles du groupe User-agent: *. Saisissez son jeton produit, pas un en-tête User-Agent complet.
Contrôle de l’exploration
Collez un brouillon robots.txt et choisissez un robot ainsi qu’un chemin. Le site distant n’est jamais interrogé.
Exploration autorisée
La règle correspondante la plus longue gagne ; Allow départage les égalités.
Les règles restent dans cet onglet. Aucune requête au site.
Brouillon actuel testé.
Avant de modifier un site, une règle Disallow trop large peut fermer une page publique. Le testeur de robots.txt indique quelle ligne s’applique réellement, y compris lorsqu’une exception Allow plus précise gagne.
Le générateur de robots.txt ajoute un groupe après prévisualisation dans le même texte. Pour tester une URL robots.txt, le chemin et la requête suffisent ; les règles Allow Disallow et les lignes Sitemap restent séparées dans le résultat.
Comprendre la décision avant de publier le fichier.
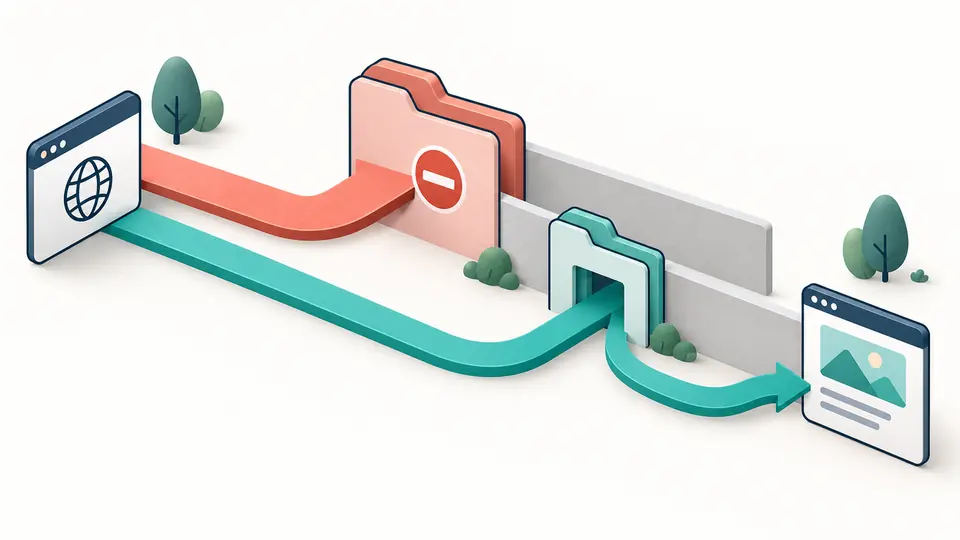
Dans l’exemple, Disallow: /private/ bloque le dossier, mais Allow: /private/public/ autorise la page plus précise. Le testeur de robots.txt affiche la ligne gagnante, sans dépendre de l’ordre des règles.
Prévisualisez le groupe User-agent, puis ajoutez-le au brouillon. Le test et le téléchargement utilisent exactement ce texte. Les Sitemap sont signalés à part, car ils n’autorisent pas un chemin.
Googlebot est proposé au départ. Un groupe précis ne récupère pas les règles du groupe User-agent: *. Saisissez son jeton produit, pas un en-tête User-Agent complet.
Vous pouvez saisir une URL complète ; seuls son chemin et sa requête sont comparés. Le test automatique attend 350 ms après une modification. Désactivez-le pour utiliser le bouton ou Ctrl/Cmd + Enter.
Vérifiez le groupe, la directive décisive et son numéro de ligne. Toute modification rend le verdict précédent obsolète et bloque copie et téléchargement jusqu’au nouveau test.
Les groupes répétés du même jeton sont réunis pour l’évaluation. Un groupe Googlebot ne fusionne pas avec le groupe générique *.
Les préfixes, * et le $ final sont pris en charge. À longueur égale, Allow prime sur Disallow.
Les URL Sitemap absolues sont listées avec leur ligne. Les directives inconnues ou chemins mal formés sont signalés, sans réécrire le brouillon.
Collez les règles, indiquez le robot et le chemin ou l’URL. Le résultat affiche le verdict, le groupe et la ligne exacte qui le décide.
Le jeton le plus spécifique est retenu ; les groupes équivalents sont réunis. Le groupe * n’est utilisé qu’en l’absence de groupe précis.
Le motif correspondant le plus long l’emporte. Si les longueurs sont égales, Allow est préféré à Disallow, quel que soit l’ordre des lignes.
* correspond à une suite de caractères ; un $ placé à la fin exige la fin du chemin ou de la requête. Testez les URL réelles avant publication.
Non. La règle limite l’exploration, mais une URL connue par des liens peut rester affichée. Pour l’exclure, envisagez noindex sur une page accessible au robot.
Un résultat vous paraît incorrect ?
Modifiez l’exemple et vérifiez la ligne gagnante. Le testeur de robots.txt exporte uniquement le texte actuellement vérifié.