01
対象クローラーを絞る
初期値はGooglebotです。専用グループがある場合、User-agent: *の規則は引き継がれません。完全なHTTPヘッダーではなく製品トークンを入力します。
クロール制御
貼り付けたrobots.txtだけを使い、クローラーと一つのパスを検査します。公開サイトは取得しません。
クロールを許可
最長一致が優先され、同長ならAllowが勝ちます。
規則はこのブラウザー内で処理し、サイトへ通信しません。
現在の草稿をテスト済みです。
公開前の設定でDisallow: /private/を追加したとき、公開ページまで止めていないか気になります。robots.txtテスターは対象パスに適用される行を示し、規則の並び順による思い込みを避けます。
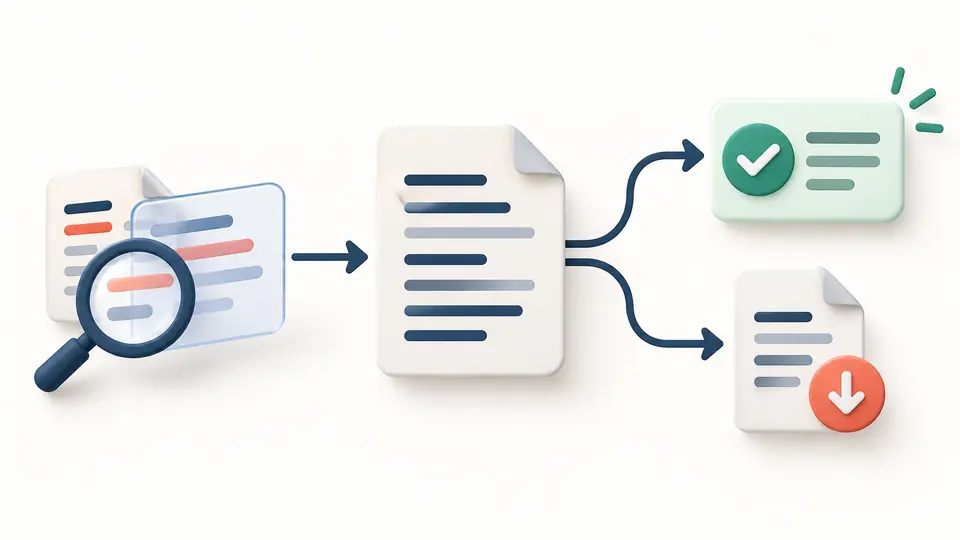
このページのrobots.txtジェネレーターは規則グループをプレビューしてから同じ本文へ追加します。robots.txt構文チェックで無視された行も示し、URLブロック判定とダウンロードの元になる本文を一つに保ちます。
許可・禁止の結論だけでなく、その根拠となる行を示します。
robots.txtテスターの例では/private/を禁止しても、より長い/private/public/のAllowが公開ページに適用されます。勝った行番号を確認してから公開できます。
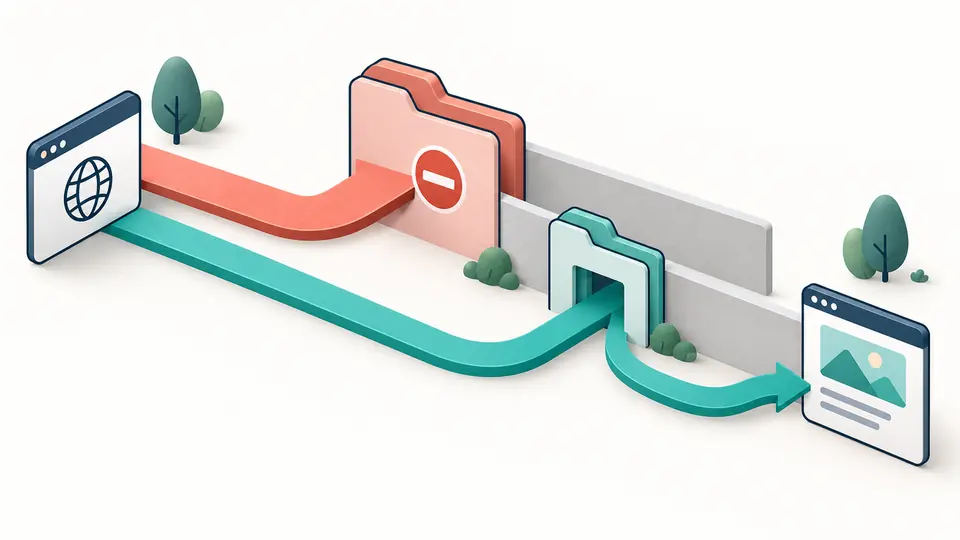
User-agentグループとSitemapを確認してから本文へ追加します。その本文をすぐテストし、同じ内容をrobots.txtとして保存します。Sitemapは経路の許可判定には使いません。
初期値はGooglebotです。専用グループがある場合、User-agent: *の規則は引き継がれません。完全なHTTPヘッダーではなく製品トークンを入力します。
パスのほか完全なURLも入力できますが、照合するのはパスとクエリだけです。自動判定は入力停止から350ミリ秒後に実行。オフにするとボタンやCtrl/Cmd + Enterで実行します。
結果に選択グループと決定的な規則を表示します。入力を変えた直後は結果が古くなり、再判定が終わるまでコピーと保存を無効にします。
同じトークンの複数グループは判定時に統合します。Googlebot専用グループと通配グループは混ぜません。
接頭辞のほか*と末尾$に対応します。最も長く一致した規則が勝ち、同じ長さならAllowがDisallowより優先されます。
有効な絶対Sitemap URLと行番号を別に表示します。未対応の指示や不正な経路は知らせますが、元の本文は書き換えません。
重要なページを誤って禁止すると、検索エンジンが内容を取得できなくなります。ここで公開前のパスをテストできますが、順位は予測しません。
できません。禁止されたURLが外部リンクから知られれば表示される場合があります。削除にはクロール可能なページのnoindexを検討します。
本文を貼り付け、クローラーの製品トークンと経路を入れます。判定結果のグループ、勝った規則、行番号を見てください。
このローカル判定はすぐ更新されます。実際のクローラーにはキャッシュがあるため、公開サイトへの反映時刻は本ツールでは確認できません。
一般に適用する禁止規則がなければクロールは許可されます。ただし本ツールはサイトへ問い合わせないため、実際の404状態は判定しません。
判定結果について質問がありますか?