01
Crawler-Token festlegen
Voreingestellt ist Googlebot. Eine konkrete Gruppe erbt die Regeln der Sternchen-Gruppe nicht. Geben Sie den Produkt-Token statt eines vollständigen HTTP-User-Agent-Headers ein.
Crawling-Regeln
Bearbeiten Sie einen robots.txt-Entwurf und testen Sie einen Crawler samt URL-Pfad. Die Website wird nicht abgerufen.
Crawling erlaubt
Die längste passende Regel gilt; bei Gleichstand gewinnt Allow.
Regeln bleiben in diesem Browser-Tab. Keine Anfrage an die Website.
Aktueller Entwurf geprüft.
Vor einem Relaunch kann eine breite Disallow-Regel aus Versehen einen öffentlichen Pfad sperren. Der Robots.txt Generator führt den Entwurf und einen lokalen Pfadtest zusammen, damit die wirksame Zeile sichtbar wird.
Der Robots.txt Tester nutzt dieselbe Datei, die Sie später herunterladen. Statt robots.txt prüfen nur anhand der Reihenfolge, sehen Sie die längste passende Regel und die betroffene Gruppe. Allow Disallow Regeln bleiben nachvollziehbar.
Die Entscheidung für einen Pfad ist bis zur Quellzeile nachvollziehbar.
Der Robots.txt Generator zeigt am Beispiel: Disallow: /private/ sperrt den Bereich, Allow: /private/public/ gibt den längeren Teilpfad frei. Die Ausgabe nennt die entscheidende Zeile.
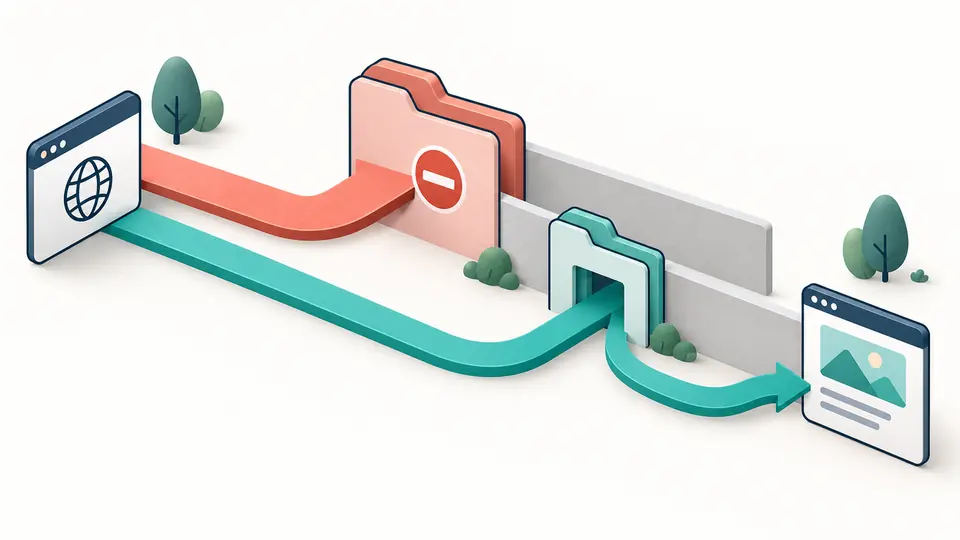
Neue User-agent-Gruppen werden vor dem Anhängen als Text geprüft. Anschließend testen und laden Sie genau denselben robots.txt-Inhalt herunter. Sitemap-Zeilen werden separat angezeigt und ändern keine Freigabe.
Voreingestellt ist Googlebot. Eine konkrete Gruppe erbt die Regeln der Sternchen-Gruppe nicht. Geben Sie den Produkt-Token statt eines vollständigen HTTP-User-Agent-Headers ein.
Ein vollständiger URL ist erlaubt; verglichen werden nur Pfad und Abfrage. Die automatische Prüfung startet 350 ms nach der letzten Änderung. Nach dem Abschalten dienen Schaltfläche und Ctrl/Cmd + Enter.
Kontrollieren Sie Gruppe, Allow/Disallow und Zeilennummer. Nach einer Änderung ist das alte Ergebnis veraltet; Kopieren und Herunterladen bleiben bis zur neuen Prüfung gesperrt.
Mehrfach definierte Gruppen desselben Tokens werden für die Prüfung zusammengeführt. Eine Googlebot-Gruppe wird nicht mit User-agent: * kombiniert.
Präfixe, * und ein abschließendes $ werden berücksichtigt. Bei gleich langen Treffern gewinnt Allow gegenüber Disallow.
Gültige absolute Sitemap-URLs erhalten Zeilennummern. Unbekannte Felder und ungültige Pfade bleiben im Text und werden gemeldet.
Ins Stammverzeichnis des jeweiligen Hosts, beispielsweise https://beispiel.de/robots.txt. Eine Datei in einem Unterordner gilt nicht für die ganze Domain.
Disallow verhindert Abrufe, aber nicht unbedingt die Anzeige einer verlinkten URL. Für eine Indexsperre muss die Seite für einen noindex-Hinweis erreichbar sein.
Unter User-agent: * bewirkt Disallow: / eine vollständige Crawling-Sperre für konforme Bots. Prüfen Sie das unbedingt vor dem Einsatz auf einer Live-Website.
Sie sperrt keinen Pfad. Der lokale Tester ignoriert diese Regel und erlaubt den Pfad, sofern keine andere passende Sperre greift.
Normalerweise nicht; Suchmaschinen benötigen sie für die Darstellung. Testen Sie Ressourcenpfade vor dem Veröffentlichen einer breiten Sperre.
Ist ein Regelergebnis unklar?
Ändern Sie eine Regel und prüfen Sie die entscheidende Zeile. Der Robots.txt Generator speichert nur den zuletzt geprüften Text.