01
단위를 먼저 확인
글자와 Markdown 모드는 사용자에게 보이는 글자 단위로 세고, 추정 토큰 모드는 문자별 가중치를 합칩니다. 크기와 겹침은 같은 단위입니다.
AI / LLM Dev Tools
청크 경계와 원문의 실제 겹침 범위를 먼저 확인하세요.
텍스트를 넣거나 예시를 불러오세요.
입력은 이 브라우저에만 있습니다. 업로드하거나 요청으로 전송하지 않습니다.
고정 글자 창은 결합 문자를 보호하지만 문장 중간을 자를 수 있습니다.
텍스트를 넣거나 예시를 불러오세요.
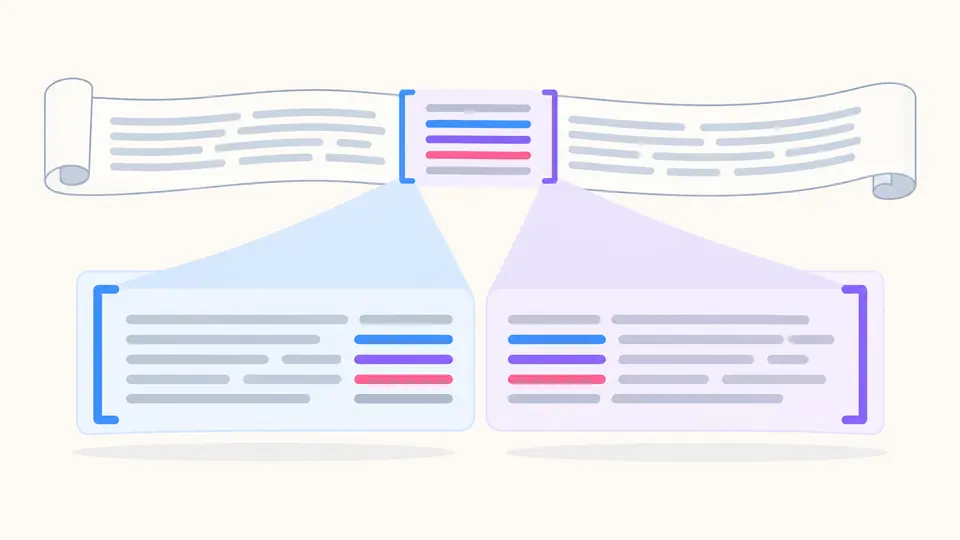
검색 결과에서 중요한 문장이 청크 경계에 걸릴 때 RAG 텍스트 청킹으로 잘린 위치를 살펴볼 수 있습니다. 겹침 숫자만 보지 말고 두 청크가 공유하는 원문을 읽어 보세요.
청크 크기와 청크 오버랩은 자료 구조와 질문에 따라 조정해야 합니다. 문서 분할 전략을 바꾸면 경계가 달라지고, 토큰 단위 청킹은 공개된 가중식으로 추정할 뿐 모델 토큰을 세지 않습니다.
설정값보다 결과가 실제로 어떻게 잘렸는지 확인하세요.
글자와 Markdown 모드는 사용자에게 보이는 글자 단위로 세고, 추정 토큰 모드는 문자별 가중치를 합칩니다. 크기와 겹침은 같은 단위입니다.
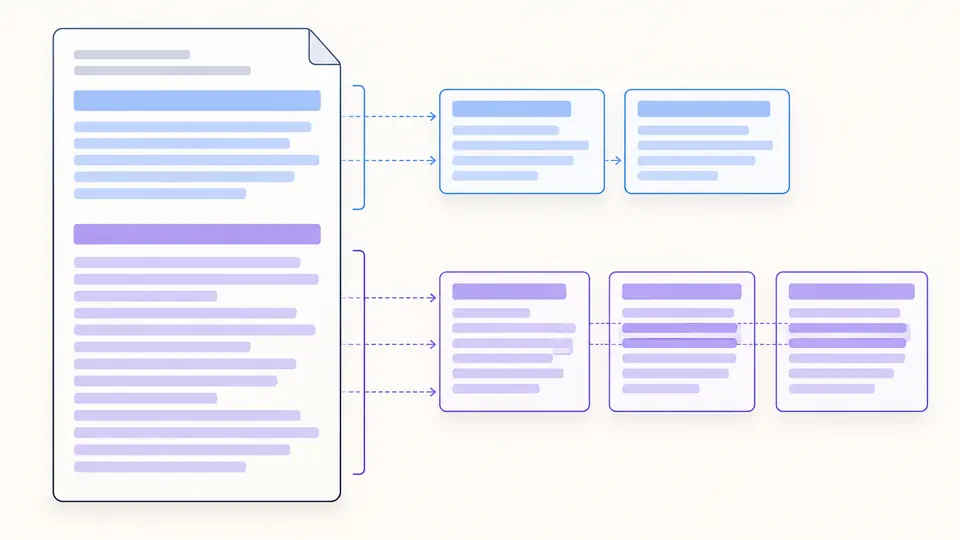
인접한 청크를 선택하면 원문의 반열린 범위와 겹치는 부분이 표시됩니다. 제목 사이에서는 겹침이 의도적으로 0입니다.
자동 분할은 편집이 멈춘 뒤 350밀리초에 실행됩니다. 수동 모드에서는 Ctrl/Cmd+Enter를 쓸 수 있고 오래된 결과는 복사할 수 없습니다.
각 청크를 원문 위치까지 추적할 수 있습니다.
피부색이 붙은 이모지나 결합 문자를 중간에서 끊지 않습니다. 다만 고정 길이 창은 문장 중간을 자를 수 있습니다.
한중일 문자, 다른 문자, 라틴 문자와 기호에 가중치를 적용합니다. 어떤 모델의 토크나이저와도 같다고 주장하지 않습니다.
전체 청크를 한 줄씩 내보내며 본문, 오프셋, 글자 수, 추정 토큰 수와 실제 겹침 범위를 함께 기록합니다.
분할 결과가 검색 품질이나 모델 한도를 보증하지 않습니다.
실제 설정과 출처 범위를 기준으로 답합니다.
경계에 걸친 문맥을 다음 청크에도 남기기 위해서입니다. 여기서는 중복된 원문 구간을 직접 확인할 수 있습니다.
이 도구의 숫자는 가중식 추정치입니다. 정확한 수가 필요하면 사용할 모델의 토크나이저로 별도 검사하세요.
보편적인 정답은 없습니다. RAG 텍스트 청킹 기본값을 출발점으로 삼고, 자신의 문서와 실제 검색 질문으로 비교하세요.
균일한 텍스트는 글자 창으로 기준선을 만들고, 제목이 있는 문서는 Markdown 경계를 살펴보세요. 추정 토큰은 예산을 대략 볼 때만 사용하세요.
항상 그렇지 않습니다. 중복이 늘면 저장량과 비슷한 결과가 함께 증가할 수 있습니다. 실제 질문의 회수 결과를 시험하세요.
누락된 사례가 있나요?