01
看清大小单位
字符和 Markdown 模式按 Unicode 字素簇计数,估算 Token 模式按加权值计数;同一模式的块大小与重叠量始终使用同一单位。
AI / LLM 开发
粘贴原文,调整块大小和重叠量,再逐块核对源范围。
粘贴文本或加载示例后开始。
输入仅在当前浏览器内处理,不上传,也不发起网络请求。
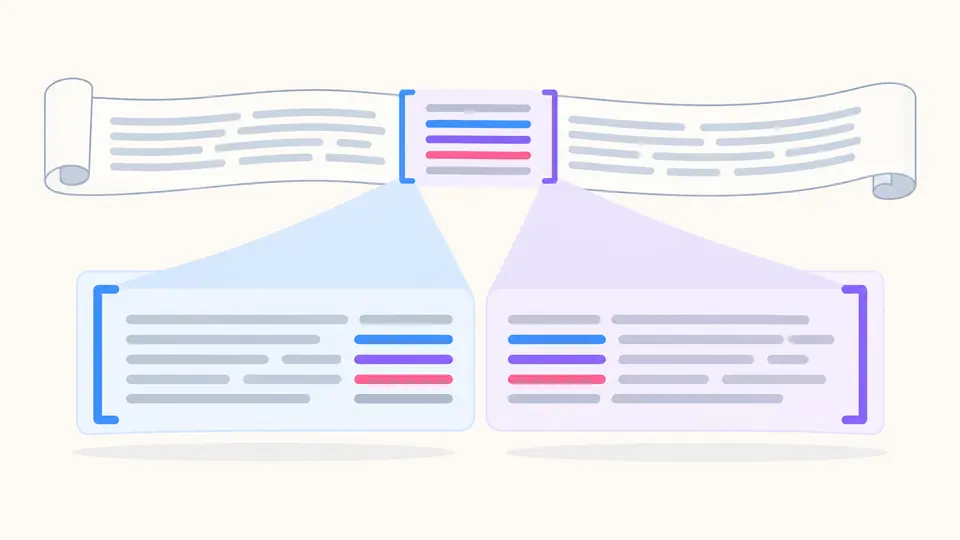
固定字符窗口保护组合字符,但仍可能切开句子。
粘贴文本或加载示例后开始。
当检索结果总是丢掉段落末尾的一句,文本分块工具可以先让你看清切点,再决定是否增加重叠。它只显示原文的切分结果,不替你判断召回质量。
RAG 文本分块的 Chunk Size 与 Overlap 应按自己的文档和问题测试。这里的切块重叠预览会显示真实重复范围;按 Token 分块使用公开估算公式,Markdown 标题模式保留章节边界。
三个不太容易从界面猜到的细节。
字符和 Markdown 模式按 Unicode 字素簇计数,估算 Token 模式按加权值计数;同一模式的块大小与重叠量始终使用同一单位。
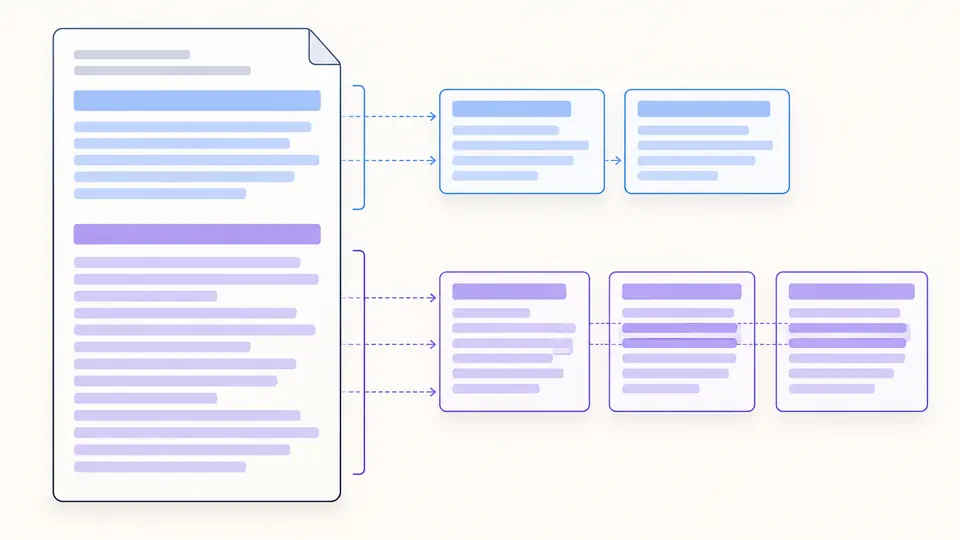
点选相邻块,检查源文半开区间和高亮部分。遇到 Markdown 标题时不跨章节复制重叠内容。
自动切块会在编辑停止 350 毫秒后运行。关闭开关可手动切块,也可按 Ctrl/Cmd + Enter;旧结果不能复制或下载。
每种方式都显示实际原文边界。
固定窗口不会把带肤色的表情或组合音符从中截断,但仍可能切开一句话。
按中日韩文字、其他文字、拉丁字符和符号赋不同权重,不冒充 GPT 等模型的真实分词器。
每行带编号、原文片段、偏移、字符数、估算 Token 数和重叠区间,导出的是全部块而非当前显示的 50 条。
这些是本工具的行为,不是模型服务的保证。
围绕单位、边界和实际数据的回答。
不是。这里是按字素簇类别加权得到的估算 Token;不同模型分词器可能相差明显,硬性输入上限要用目标模型复核。
字符和估算 Token 策略使用固定窗口;Markdown 策略优先按标题分节,长节再尝试段落与行边界。
必须是小于块大小的非负整数。输入无效时文本分块工具会报错,不自动改写你的参数。
两者在同一策略里单位相同:字符及 Markdown 为字素簇,估算 Token 为加权估算值。
没有万能数值。拿自己文档和已知答案的问题测试,在边界预览与实际召回之间比较不同参数。
发现未覆盖的情况?