01
まず単位を見る
文字とMarkdownは書記素クラスタ、推定トークンは公開された重みで数えます。同じモードのサイズと重複は必ず同じ単位です。
AI / LLM Dev Tools
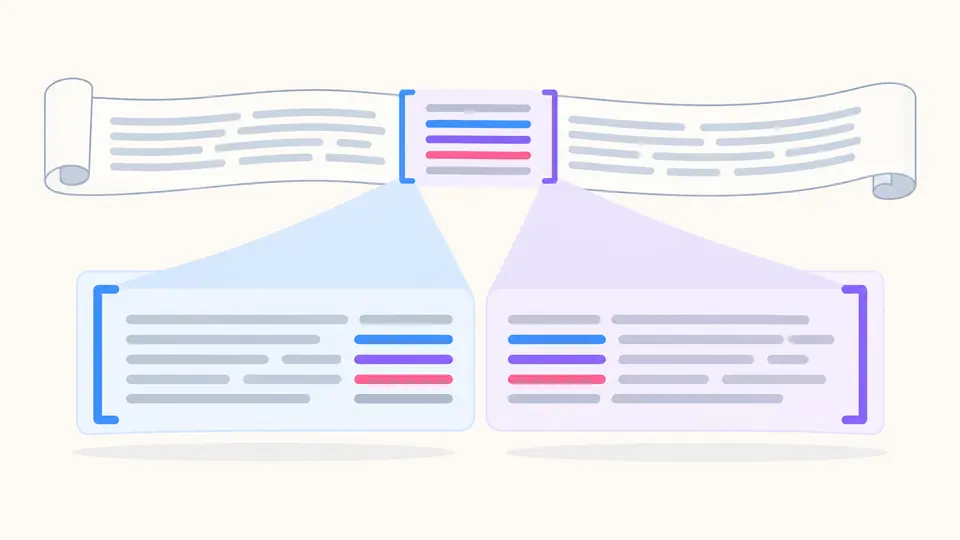
元の文章に対する切れ目と重複範囲を、チャンクごとに確かめます。
文章を貼るかサンプルを読み込んでください。
入力はこのブラウザ内だけで処理され、アップロードやネットワーク通信は行いません。
固定窓は結合文字を壊しませんが、文の途中で切ることがあります。
文章を貼るかサンプルを読み込んでください。
検索で必要な一文が境界の向こうに落ちるとき、テキストチャンク分割で実際の切れ目を先に確認できます。数値だけでなく、前後のチャンクに何が重複するかを読んで判断してください。
RAGチャンク分割ではトークン数ベースやオーバーラップ指定が重要です。ここではMarkdown見出し分割も選べますが、モデルごとの正確なトークン数や検索品質までは測りません。
プリセットよりも結果を読んで調整します。
文字とMarkdownは書記素クラスタ、推定トークンは公開された重みで数えます。同じモードのサイズと重複は必ず同じ単位です。
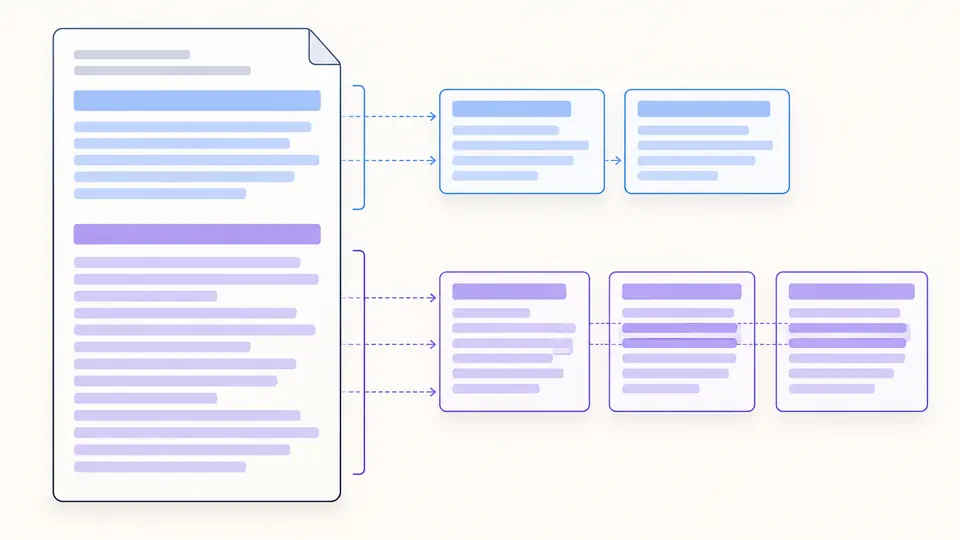
結果からチャンクを選び、元文書の半開区間と強調表示を確認します。見出しをまたぐ重複は意図的にありません。
自動分割は入力停止から350ミリ秒後に実行します。手動に切り替えるとCtrl/Cmd+Enterが使え、古い結果のコピーと保存は無効になります。
境界と元文書の対応を明示します。
結合絵文字や濁点付き文字の途中では切りません。ただし固定長なので文の途中では切れる場合があります。
文字種ごとに重みを与えますが、GPTやClaudeなどの実際のモデル用トークナイザーを模倣しません。
番号、本文、元文書の位置、文字数、推定トークン数、実際の重複区間を一行ずつ出力します。
この分割器の出力だけで検索精度を保証することはできません。
文字、推定トークン、重複についての回答です。
文字モードは書記素クラスタを数えます。推定トークンモードは文字種の重みを積算するため、同じ文章でも境界が変わります。
境界にまたがる文脈を隣のチャンクにも残すためです。テキストチャンク分割では共有した原文そのものを確認できます。
このページの文字・推定トークンは固定窓、Markdownは見出し優先です。文書構造に合わせて試し、実際の質問で検索を評価してください。
万人向けの値はありません。初期値から前後に動かし、自分の文書の切れ目と検索結果を比較してください。
いいえ。分割とJSONL生成は現在のブラウザー内で実行され、このツールは原文をアップロードしません。
未対応のケースがありますか?