01
Leer la unidad de ambos campos
Caracteres y Markdown usan grafemas Unicode; tokens estimados usan una fórmula ponderada. Tamaño y solapamiento siempre comparten unidad.
AI / LLM Dev Tools
Comprueba cada corte, su rango de origen y el texto que se repite.
Pega texto o carga el ejemplo.
La entrada permanece en este navegador. No se sube ni se envía en solicitudes.
La ventana fija conserva grafemas compuestos, pero puede cortar una frase.
Pega texto o carga el ejemplo.
Un fragmentador de texto permite ver si una respuesta quedó partida entre dos pasajes antes de crear un índice RAG. Pega un documento real y revisa sus límites.
Esta fragmentación RAG ofrece división por tokens estimados y títulos Markdown. El solapamiento de chunks se muestra como texto compartido; el divisor de texto exporta las posiciones de cada fragmento en JSONL.
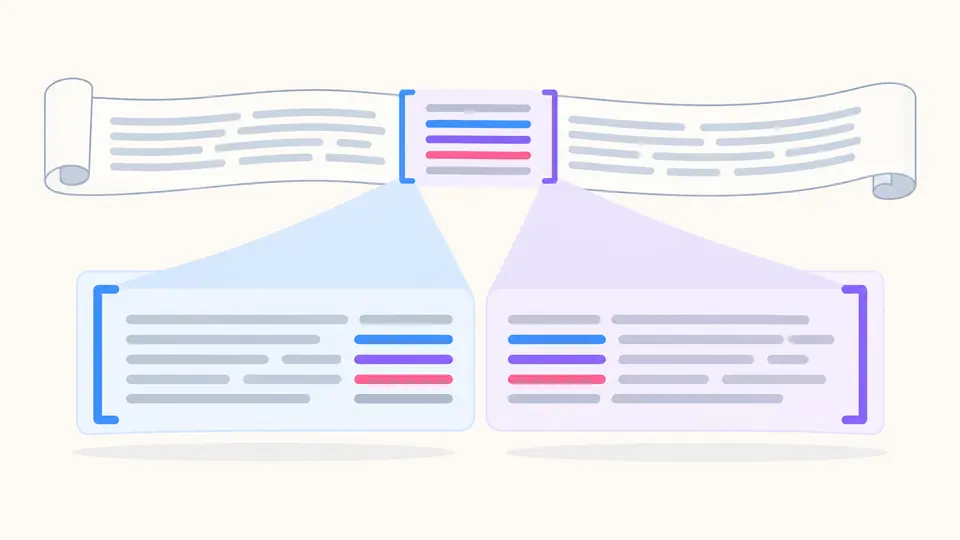
Inspecciona el texto repetido, no solo su porcentaje.
El fragmentador de texto guarda los offsets UTF-16 de inicio y fin, y destaca el tramo compartido por dos fragmentos vecinos.
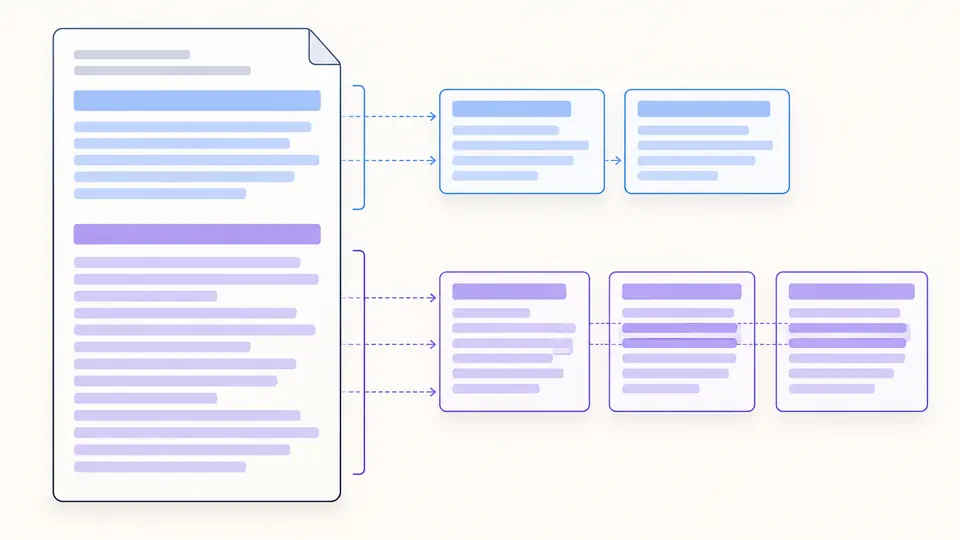
Un título Markdown inicia otra sección sin arrastrar texto del tema anterior. Las secciones largas vuelven a párrafos, líneas y grafemas.
Tres cosas que conviene verificar en el resultado.
Caracteres y Markdown usan grafemas Unicode; tokens estimados usan una fórmula ponderada. Tamaño y solapamiento siempre comparten unidad.
Selecciona fragmentos vecinos para comprobar sus rangos semiabiertos y el texto resaltado. Un nuevo título Markdown reinicia el solapamiento.
El modo automático espera 350 ms tras editar. En modo manual usa Ctrl/Cmd+Enter; mientras el resultado esté obsoleto, copiar y descargar quedan desactivados.
Cada fragmento conserva su relación con la fuente.
Un emoji compuesto o una letra con marca combinada no se corta por la mitad, aunque una frase sí puede quedar dividida.
La ponderación varía por escritura y símbolos; no se presenta como el tokenizador exacto de ningún modelo.
Cada línea incluye texto, inicio, fin, caracteres, tokens estimados y el intervalo real compartido con el fragmento anterior.
El resultado no mide por sí solo la calidad de recuperación.
Respuestas basadas en lo que muestra la herramienta.
No existe uno universal. Usa el valor inicial como referencia y contrasta varios tamaños con preguntas reales sobre tus documentos.
Pueden perder el contexto necesario para responder. Revisa los cortes y prueba una ventana mayor o algo de solapamiento.
Pueden mezclar temas y ocupar más contexto del necesario. Compara rangos más pequeños y revisa si cada fragmento sigue teniendo sentido.
Depende de tu corpus, las preguntas y el modelo. El fragmentador de texto permite comparar límites, pero no calcula la mejor recuperación.
Es el texto compartido por dos fragmentos consecutivos. Aquí puedes ver el intervalo exacto; en un nuevo título Markdown puede ser cero.
¿Falta algún caso?
Pega un pasaje real, ajusta los parámetros y guarda todos los cortes comprobados en JSONL.