01
Einheit vor dem Split prüfen
Zeichen- und Markdown-Modus zählen Unicode-Grapheme, der Token-Modus berechnet gewichtete Schätzwerte. Größe und Überlappung haben je Modus dieselbe Einheit.
AI / LLM Dev Tools
Sehen Sie Schnittstellen und echte Überschneidungen direkt am Quelltext.
Text einfügen oder Beispiel laden.
Die Eingabe bleibt im Browser. Kein Upload und keine Datenanfrage.
Feste Fenster erhalten zusammengesetzte Zeichen, können aber Sätze trennen.
Text einfügen oder Beispiel laden.
Ein Text-Chunker hilft, wenn eine wichtige Aussage an der Grenze zwischen zwei Suchpassagen zerfällt. Prüfen Sie einen echten Text, bevor Sie ihn indexieren.
Mit diesem Werkzeug lässt sich Text in Chunks aufteilen. Chunk-Größe und Chunk-Überlappung bleiben in derselben Einheit; Markdown-Chunking hält Überschriften getrennt und liefert nachvollziehbare JSONL-Daten.
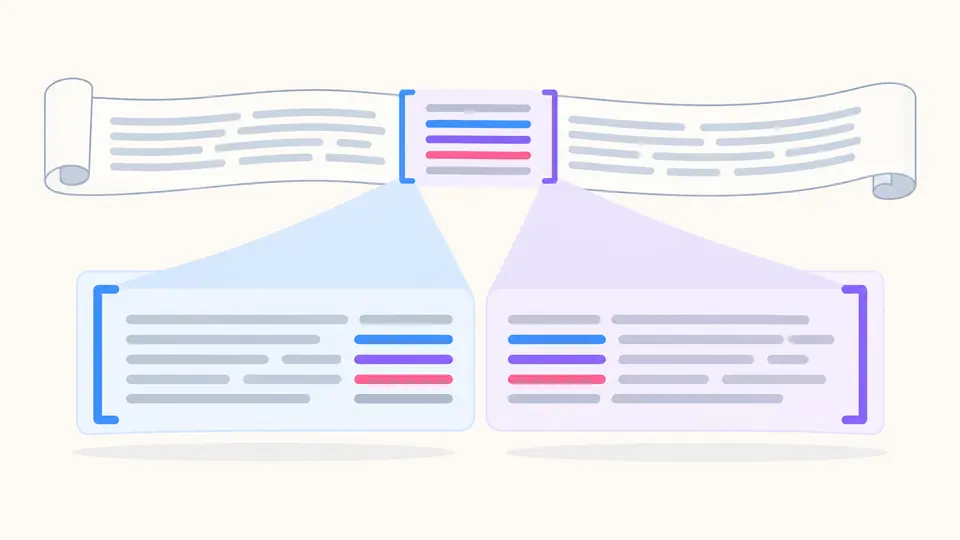
Jede wiederholte Stelle lässt sich im Original überprüfen.
Der Text-Chunker speichert UTF-16-Start und -Ende jedes Chunks und markiert den Bereich, den zwei Nachbarn tatsächlich gemeinsam enthalten.
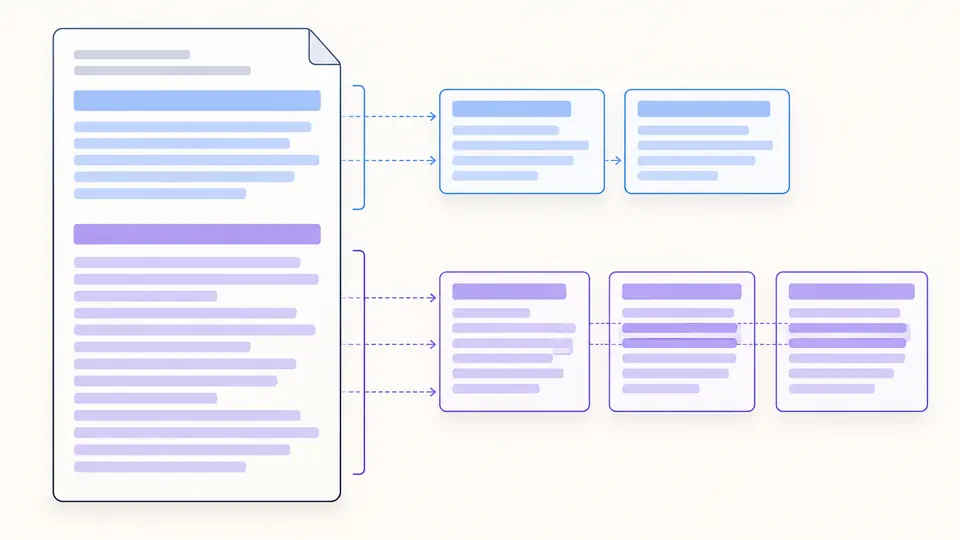
An einer Markdown-Überschrift beginnt ein neuer Abschnitt ohne Überlappung aus dem vorigen Thema. Lange Abschnitte werden weiter nach Absätzen und Zeilen zerlegt.
Drei Punkte, die ein Standardwert nicht erklären kann.
Zeichen- und Markdown-Modus zählen Unicode-Grapheme, der Token-Modus berechnet gewichtete Schätzwerte. Größe und Überlappung haben je Modus dieselbe Einheit.
Wählen Sie benachbarte Chunks und vergleichen Sie ihre halboffenen Quellbereiche. Eine neue Markdown-Überschrift setzt die Überlappung auf null.
Automatik wartet nach der Eingabe 350 ms. Manuell startet Strg/Cmd+Enter; geänderte Eingaben sperren Kopieren und Download bis zur nächsten Berechnung.
Die Daten eignen sich für nachvollziehbare Indexierungsversuche.
Ein zusammengesetztes Emoji oder ein Akzent wird nicht halbiert; ein festes Fenster kann dennoch mitten in einem Satz enden.
Gewichte für CJK, andere Schriften, lateinische Zeichen und Symbole liefern nur eine Schätzung, keine Modell-Tokenisierung.
Jede Zeile enthält Text, Start, Ende, Graphemzahl, geschätzte Tokens und den tatsächlich gemeinsam genutzten Quellbereich.
Die Grenzen gelten für diesen Splitter, nicht für ein Embedding-Modell.
Antworten zu Größe, Überlappung und Datenquelle.
Es gibt keine universelle Größe. Beginnen Sie bei 1000 Graphemen und vergleichen Sie andere Werte anhand Ihrer Dokumente und echter Suchfragen.
Sie wiederholt Text an einer Grenze, damit Kontext nicht abrupt verloren geht. Der gemeinsam verwendete Quellbereich ist hier sichtbar.
Das hängt vom Dokument ab. Zu viel Überlappung erzeugt mehr nahezu gleiche Einträge; testen Sie mehrere Werte mit Ihren Fragen.
Dokumente werden vor dem Embedding in abrufbare Passagen zerlegt. Dieses Werkzeug zeigt nur die Aufteilung, erzeugt aber weder Embeddings noch eine Vektorsuche.
Wählen Sie die Größe passend zur erwarteten Antwortlänge und Dokumentstruktur. Prüfen Sie die Schnittstellen; der Text-Chunker gibt keinen allgemeinen Optimalwert vor.
Fehlt ein Anwendungsfall?
Fügen Sie eine echte Passage ein, ändern Sie die Parameter einzeln und speichern Sie alle geprüften Grenzen als JSONL.