HTTP y depuración de peticiones

Analizador de cabeceras HTTPconserva cada aparición

Pega un bloque de cabeceras y revisa valores, parámetros y repeticiones. Hay ejemplos distintos de petición y respuesta.

Analizador de cabeceras HTTP

Cabeceras HTTP originales

La entrada se procesa en este navegador. La herramienta no envía peticiones ni guarda historial.

Resultado del análisis

Línea de petición o estado

GET /reports HTTP/1.1

Host

Línea 2
example.com

Accept

Línea 3
application/json, text/html;q=0.8, */*;q=0.1
Detalle de parámetros
  • application/jsonPeso (q): 1
  • text/htmlPeso (q): 0.8
  • */*Peso (q): 0.1

Accept-Language

Línea 4
en, ja;q=0.8, *;q=0
Detalle de parámetros
  • enPeso (q): 1
  • jaPeso (q): 0.8
  • *Peso (q): 0

Authorization

Línea 5Oculto
[REDACTED]

X-Trace

Línea 6Repetido
first

x-trace

Línea 7Repetido
second

Opciones

Oculta Authorization, Proxy-Authorization, Cookie y Set-Cookie en resultados y exportaciones. La entrada sigue visible; no oculta claves propias ni secretos en URL.

Un bloque de texto, hasta 128 KiB UTF-8 y 1000 campos. La primera línea vacía termina las cabeceras.

6 campos · 2 entradas repetidas · 0 notas

El Analizador de cabeceras HTTP permite revisar una captura antes de convertirla en un caso de prueba. Una segunda aparición puede revelar que un proxy añadió un valor; sobrescribirla durante la conversión haría desaparecer esa pista.

Al pasar cabeceras HTTP a JSON, obtienes una lista ordenada y arrays agrupados por nombre. Así puedes consultar los encabezados HTTP desde un script sin renunciar al orden original ni eliminar cabeceras repetidas.

Por qué usar este Analizador de cabeceras HTTP

No perder las repeticiones

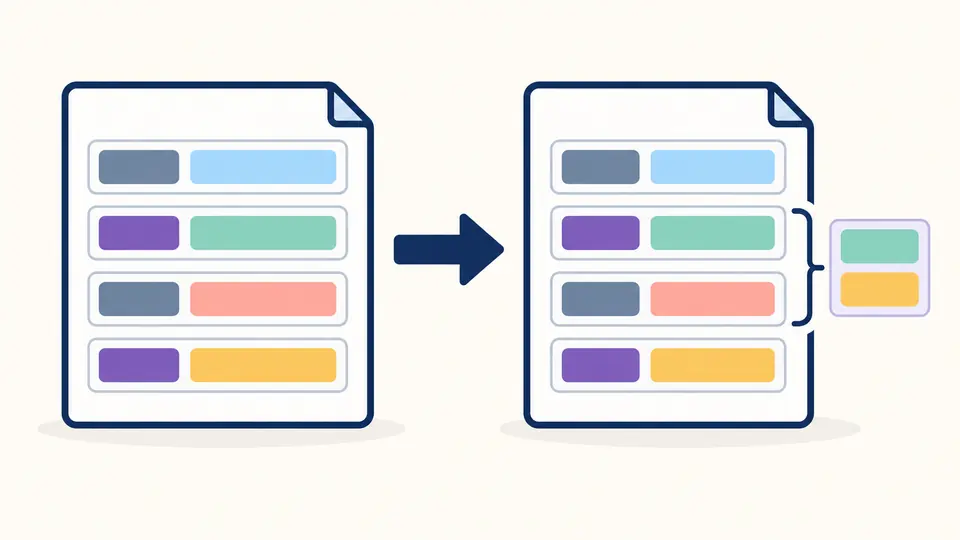
El Analizador de cabeceras HTTP conserva dos líneas Set-Cookie como entradas independientes aunque cambien de mayúsculas a minúsculas. La coma de Expires sigue siendo parte del valor. Esto permite comprobar una respuesta sin inventar una única cadena combinada.

Dos campos con el mismo nombre conservan valores de distinto color en una lista ordenada y en un grupo.

Separar con conocimiento de las comillas

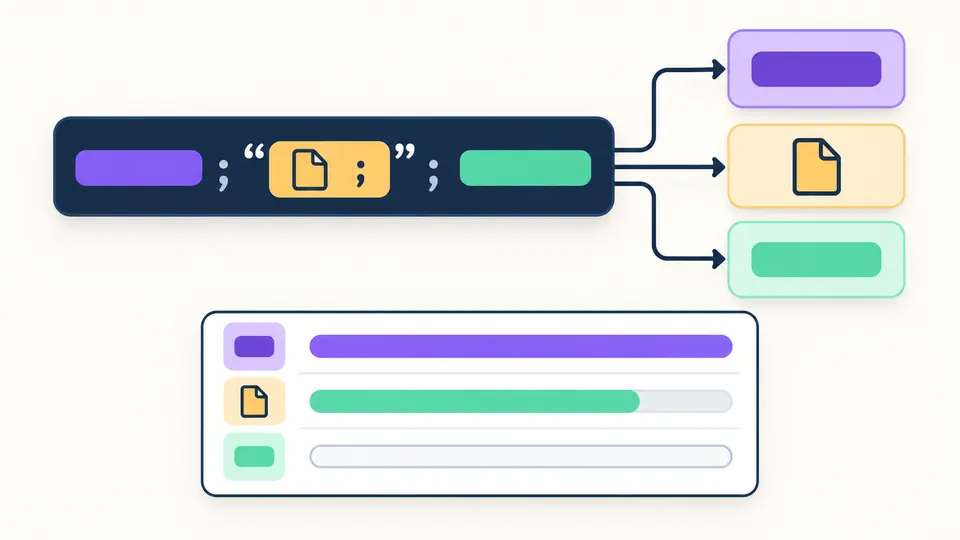
Un punto y coma dentro del nombre de archivo entre comillas no abre otro parámetro. Content-Disposition se descompone respetando ese límite, mientras Accept y Accept-Language muestran sus elementos y pesos junto al valor original.

Un campo complejo se divide en una tarjeta de nombre de archivo y varias tarjetas de parámetros ordenadas.

Revisa una captura con su contexto

01

Elige la dirección del ejemplo

El ejemplo de petición incluye Accept, idiomas y un token ficticio. El de respuesta muestra un nombre extendido y dos cookies. Antes de reemplazar se presenta el texto y su cantidad de caracteres; Deshacer restaura también el informe anterior.

02

Controla cuándo se actualiza

El modo automático espera 350 ms tras la última edición. Al apagarlo aparece Analizar, y también funciona Ctrl/Cmd+Intro. Cambiar la entrada o la presentación de nombres desactiva la exportación hasta que se analice de nuevo con éxito.

03

Comprueba qué vas a compartir

La ocultación está activada al empezar. Al desactivarla, los valores de los cuatro campos protegidos aparecen también en el JSON exportado. Las vistas comparten un informe; mostrar otros 50 elementos amplía la vista previa, mientras la descarga siempre incluye todos.

Del campo a sus parámetros

Orden y acceso por nombre

entries registra la línea, el nombre original, el nombre mostrado y el valor en su orden de entrada. grouped usa la primera escritura mostrada como clave y guarda arrays incluso para los campos únicos. Ningún objeto de valor único sobrescribe una segunda aparición.

Nombres extendidos de archivos

Se muestran el tipo y los parámetros de Content-Disposition. Un filename* válido tiene prioridad sobre filename. Se decodifican UTF-8 e ISO-8859-1; los parámetros duplicados y las codificaciones no admitidas generan notas para evitar presentar un nombre ambiguo como definitivo.

Pesos sin negociar una respuesta

Los rangos de medios de Accept y los rangos de idiomas conservan el orden y los parámetros. Si falta q se muestra 1, y q=0 no desaparece. Un peso inválido figura como null con una nota. No se ordenan las preferencias ni se decide qué devolverá el servidor.

Fallos con posición de origen

Un separador ausente, nombre incorrecto, carácter de control o línea plegada detiene el análisis con línea y columna. Los problemas internos de los tres campos especializados generan notas conservando el valor completo. Un bloque mal formado no produce un informe parcialmente correcto para exportar.

Alcance y límites del resultado

Solo un bloque de texto
La primera línea vacía después de un campo o línea inicial termina el análisis; se ignora el cuerpo posterior. Pega cada respuesta por separado. No se admiten comandos cURL completos, prefijos de registros, HAR ni tramas binarias. Sí se aceptan pseudocabeceras textuales como :method: GET.
No es una validación del protocolo
Cambiar la escritura del nombre no certifica que pueda enviarse así por la red. No se verifican credenciales, CORS, CSP ni políticas de caché. No hay conversión inversa para crear peticiones ni descarga de adjuntos; el nombre sugerido del archivo nunca se usa para guardar este informe.
Tamaño y ocultación delimitados
El texto completo puede ocupar hasta 128 KiB UTF-8 y el bloque hasta 1000 campos. El exceso produce un error, sin truncar datos. La ocultación reconoce cuatro nombres fijos; revisa claves personalizadas y secretos en el destino de la petición antes de compartir.

Preguntas del Analizador de cabeceras HTTP

¿Hay que pulsar un botón para analizar?

De forma predeterminada el análisis se ejecuta tras una pausa de 350 ms. Puedes desactivar el modo automático y usar Analizar o Ctrl/Cmd+Intro. En ese modo una edición deja el resultado pendiente y bloquea su exportación.

¿Con qué formato deben estar las cabeceras?

Un par Nombre: valor por línea. Puedes conservar la línea inicial reconocible y los valores vacíos. Las continuaciones con sangría se rechazan; prepara cada campo en una sola línea antes de analizarlo.

¿Qué pasa con la línea de petición o de estado?

Una primera línea como GET / HTTP/1.1 o HTTP/2 200 queda en startLine, separada de los campos. El contador solo incluye cabeceras. También puedes introducir un bloque sin esa línea inicial.

¿Entiende las pseudocabeceras de HTTP/2?

Acepta su representación textual, por ejemplo :method: GET o :status: 200. Esto permite inspeccionar texto copiado de herramientas del navegador; no implica decodificar tramas binarias ni verificar todas las reglas de HTTP/2.

¿Qué ocurre con cabeceras repetidas como Set-Cookie?

Se conservan todas las líneas y se marca cada entrada cuyo nombre está repetido. La agrupación no distingue mayúsculas y minúsculas y siempre utiliza arrays. No se combinan valores con comas ni se conserva solo el último.

¿Algún campo se interpreta mal?

Examina tu siguiente captura

Usa el Analizador de cabeceras HTTP con una captura concreta, revisa las notas sobre parámetros y descarga el JSON actual para continuar el diagnóstico.