HTTP und Request-Debugging

User-Agent-Parser

Ein User-Agent pro Zeile. Erkannte Angaben und unbekannte Felder bleiben zusammen mit dem Original nachvollziehbar.

User-Agent-Parser

User-Agent-Eingabe

UA-Texte werden im Browser verarbeitet; Eingaben werden weder versendet noch gespeichert.

Analyseergebnis

Analyseregeln werden geladen…

Analyseoptionen

Ein UA pro Zeile · 500 Einträge · 500 Zeichen je UA · 512 KiB Eingabe.

Die Regeln beschreiben den Text. Unbekannt bedeutet nicht Desktop; Versionen können eingefroren sein.

Parser: ua-parser-js 1.0.41 · Mitgelieferte Regeln: 1.0.41

Analyseregeln werden geladen…

Ein Support-Ticket nennt Edge, im angehängten Text stehen aber auch Chrome und Safari. Der User-Agent-Parser ordnet solche Kompatibilitätsangaben anhand fester Regeln ein. Das voreingestellte Beispiel zeigt, warum die Suche nach einem einzelnen Browsernamen nicht ausreicht.

Für eine kleine Stichprobe aus Zugriffsprotokollen genügt eine UA pro Zeile. Wiederholungen bleiben erhalten, und jede Ausgabe verweist auf ihre ursprüngliche Zeile. Fehlende Geräteangaben werden nicht durch eine vermeintlich sichere Desktop-Zuordnung ersetzt.

Warum diesen User-Agent-Parser verwenden

Erkannte Angaben von Lücken unterscheiden

Der User-Agent-Parser zeigt elf Felder getrennt an. Er kann einen Browser erkennen, ohne den Gerätetyp bestimmen zu können. Vergleichen Sie deshalb den User-Agent String mit dem Ergebnis, bevor Sie eine konkrete Testumgebung aus den Angaben ableiten.

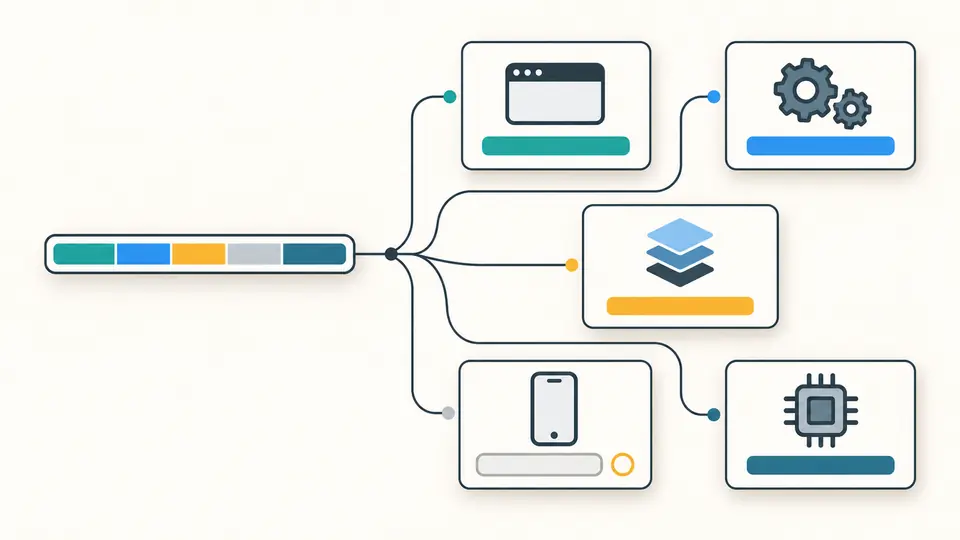
Eine Eingabe verzweigt sich in Karten für Browser, Engine, Betriebssystem, Gerät und CPU; ein unbekanntes Gerätefeld bleibt leer.

Jede Ausgabe zur Quelle zurückverfolgen

Originalzeile, bereinigter UA-Wert und Zeilennummer bleiben im Bericht verbunden. Leerzeilen werden gezählt, identische Einträge nicht zusammengeführt. Auch ein unbekannter Client bleibt zwischen erkannten Browsern sichtbar und kann später einzeln untersucht werden.

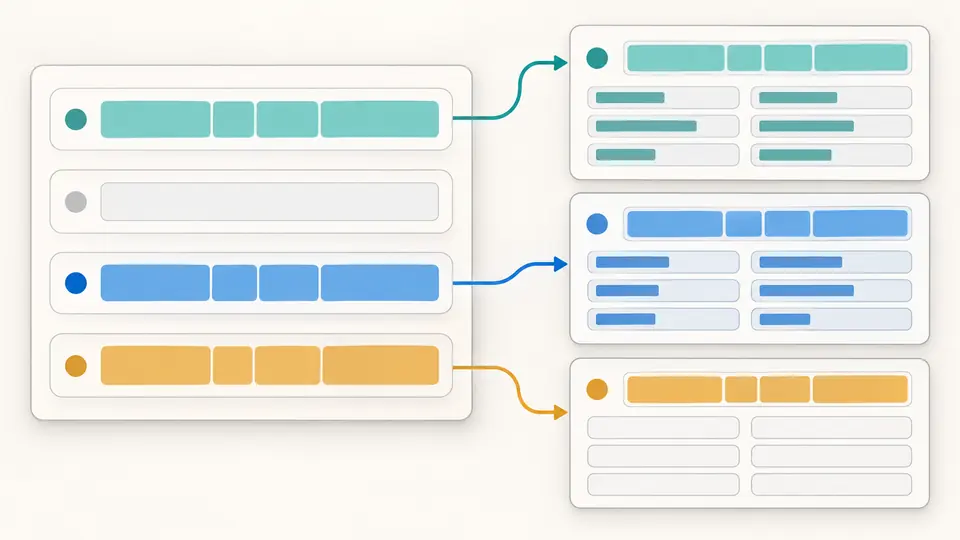
Mehrere Eingabezeilen führen zu passenden Ergebniskarten; eine Leerzeile wird übersprungen und unbekannte Angaben bleiben leer.

Eine Protokollstichprobe richtig vorbereiten

01

Nur den UA-Wert übernehmen

Pro Zeile ist ein UA-Wert oder ein einzelner Header mit User-Agent: erlaubt. Groß- und Kleinschreibung des Präfixes spielt keine Rolle. Präfix und äußere Leerzeichen werden nur für die Analyse entfernt. Vollständige Logzeilen, JSON-Anführungszeichen und Escape-Sequenzen werden nicht aufgelöst.

02

Den Ausführungszeitpunkt wählen

Die automatische Analyse wartet nach Änderungen 350 ms. Ist sie ausgeschaltet, starten Sie mit Analysieren oder Strg/Cmd+Enter. Sobald sich die Eingabe ändert, wird der Export des alten Berichts gesperrt. Ein Wechsel zwischen Feldern und JSON löst keine neue Analyse aus.

03

Ersetzen und Exportumfang prüfen

Eigener Browser, Beispiele und Leeren zeigen zunächst eine Vorschau samt Anzahl der betroffenen Einträge. Nach dem Anwenden stellt Rückgängig Eingabe und Bericht wieder her. Weitere 50 anzeigen erweitert die Vorschau; Kopieren und Herunterladen enthalten immer den vollständigen aktuellen Bericht.

Welche Angaben im Bericht stehen

Browser und Engine getrennt

Name, gemeldete Vollversion und Hauptversion des Browsers erscheinen separat. Auch Rendering-Engine und Betriebssystem haben eigene Namens- und Versionsfelder. Ein Edge-UA kann Chrome- und Safari-Tokens enthalten. Eingefrorene Versionswerte bleiben im Bericht so stehen, wie die Regeln sie lesen.

Gerätehinweise ohne voreilige Ergänzung

Typ, Hersteller, Modell und CPU-Architektur werden einzeln ermittelt. Ein erkanntes Mobilgerät muss kein bekanntes Modell haben; ein erkanntes Windows beweist keinen Desktop. Fehlende Werte erscheinen in JSON als null. unknownFields nennt die betroffenen Felder für die weitere Verarbeitung.

Original und Analysewert nebeneinander

raw enthält die komplette Originalzeile, ua den Wert ohne Headerpräfix und äußere Leerzeichen. line zählt ab eins und verweist auf die Eingabe. Die Normalisierung verändert den Editor nicht. Damit bleibt auch nach einem Export nachvollziehbar, welcher Text tatsächlich ausgewertet wurde.

Festgehaltener Regelstand

Der Bericht nennt ua-parser-js 1.0.41 und die mit dieser Version ausgelieferten Regeln. Eingefügte Texte und die eigene Browserkennung folgen demselben Ablauf. Touch-Erkennung, Brave-Sondererkennung und Client Hints werden nicht mit alten Protokolldaten vermischt.

Grenzen der Aussagekraft

Keine Prüfung der Identität
Clients können ihren UA frei wählen. Das Werkzeug bestätigt weder menschliche Besucher noch Suchmaschinen-Crawler und gibt kein Bot-Urteil aus. Auch ein bekannter Browsername kann von einem Skript stammen. Ob eine Funktion unterstützt wird, muss in der tatsächlichen Umgebung geprüft werden.
Unbekannte oder eingefrorene Angaben
Windows NT 10.0 unterscheidet Windows 10 nicht von Windows 11. Ein iPad im Desktopmodus kann Macintosh melden. Gekürzte Versionen und generische Modelle lassen sich aus diesem Text nicht wiederherstellen. Ein fehlender Gerätetyp bleibt unbekannt und wird niemals automatisch zu Desktop.
Begrenzung ohne Abschneiden
Erlaubt sind 500 nichtleere Einträge und insgesamt 512 KiB UTF-8-Eingabe. Jeder normalisierte UA darf höchstens 500 UTF-16-Codeeinheiten enthalten. Bei Überschreitung oder unerlaubten Steuerzeichen stoppt der ganze Bericht mit einer Positionsangabe. Es wird kein abgeschnittener oder teilweise erfolgreicher Export angeboten.
Ein Werkzeug für zeilenweisen Text
Dateiimport, URL-Abruf, Anfragewiederholung, Client-Hints-Ergänzung und automatische Extraktion aus vollständigen Logs gehören nicht dazu. Anführungszeichen und Escape-Sequenzen bleiben wörtlich erhalten. Leerzeilen werden übersprungen, Duplikate behalten. Exportiert wird JSON; Sortierung, Bereinigung und Verkehrsstatistiken sind nicht enthalten.

Fragen zum User-Agent-Parser

Warum sehen Edge und Opera wie Chrome aus?

Chromium-Browser behalten ältere Kompatibilitätstokens. Die Regeln prüfen bekannte Edge- und Opera-Signaturen vor dem allgemeinen Chrome-Muster. Fehlt das abschließende Edg/ oder OPR/, kann die entscheidende Information verloren sein. Fügen Sie deshalb die vollständige Zeichenfolge ein.

Wie wird der Gerätetyp bestimmt?

Die Bibliothek sucht nach bekannten Gerätemustern. Ohne Treffer bleibt das Feld unbekannt, auch wenn Browser oder Betriebssystem erkannt wurden. Ein Treffer beschreibt die Zeichenfolge und bestätigt weder Gehäuseform noch tatsächlich verwendete Hardware.

Kann das Werkzeug Googlebot erkennen?

Diese Ausgabe bietet keine Bot-Klassifikation. Ein Text, der Googlebot nennt, wird wie jeder andere selbst angegebene UA verarbeitet und kann unbekannte Browserfelder ergeben. Die Echtheit eines Crawlers muss mit zusätzlichen Informationen außerhalb der Zeichenfolge geprüft werden.

Kann ich die Kennung meines eigenen Browsers laden?

Ja. Eigener Browser liest navigator.userAgent und öffnet eine Vorschau zum Ersetzen der Eingabe. Nach dem Anwenden wird derselbe reine Textparser verwendet. Bildschirmdaten, Touch-Fähigkeiten und zusätzliche Client Hints werden nicht übernommen.

Wo wird meine eingefügte Zeichenfolge verarbeitet?

Nach dem Laden der Parserdatei läuft die Berechnung im Browser. Der Arbeitsbereich versendet keine UA-Daten, speichert keinen Eingabeverlauf und schreibt den Text nicht in die URL. Ein exportierter Bericht enthält die Originalzeilen; prüfen Sie diese vor dem Weitergeben.

Wird eine Kennung falsch ausgewertet?

Den nächsten Client untersuchen

Nutzen Sie den User-Agent-Parser für eine kleine Stichprobe, vergleichen Sie unbekannte Angaben mit den Originalzeilen und exportieren Sie den Bericht samt Regelversion.