Unicode et internationalisation

détecteur de caractères invisiblescomprendre les différences cachées

Examinez chaque position avant de choisir les caractères à modifier.

détecteur de caractères invisibles

Texte à examiner

Positions détectées

Le texte reste dans ce navigateur, sans être envoyé.

Confirmer chaque catégorie à traiter

Aucune catégorie n’est cochée au départ. Une sélection confirme son effet décrit. Relancez l’analyse, puis consultez l’aperçu avant d’appliquer.

Sous-ensemble fixe Unicode 17.0.0 : 521 points de code et substituts isolés. Ce n’est pas une détection complète de visibilité ni un verdict de sécurité. Les noms officiels gardent la notation Unicode.

Décalage et indice commencent à 0 ; ligne et colonne à 1. Les colonnes comptent les points de code, pas les cellules visibles. CRLF est un saut ; CR, LF, NEL, LS et PS aussi. Les deux caractères CRLF appartiennent à la ligne précédente.

Jusqu’à 100 000 unités UTF-16. Les CR/CRLF non modifiés restent tels que reçus du navigateur ; les nouveaux sauts utilisent LF. L’éditeur peut afficher des fins de ligne normalisées.

Les marqueurs servent à l’affichage et ne sont pas insérés. Les contrôles suivent l’ordre de stockage sans être exécutés. Contexte limité à 24 unités UTF-16 de chaque côté.

Saisissez du texte ou chargez l’exemple, puis lancez la détection.

Le détecteur de caractères invisibles aide à comprendre pourquoi deux identifiants identiques à l’écran échouent lors d’une comparaison. Des espaces sans largeur peuvent couper un mot ; une espace insécable peut ressembler à une espace ordinaire tout en ayant un autre code.

Commencez par le fragment le plus court qui reproduit le problème. L’Unicode caché peut provenir d’un document, d’une page ou d’un éditeur. Un caractère de contrôle n’est pas une preuve de malveillance : sa fonction dépend de la langue et de son contexte.

Pourquoi utiliser ce détecteur de caractères invisibles ?

Lire la différence à sa position exacte

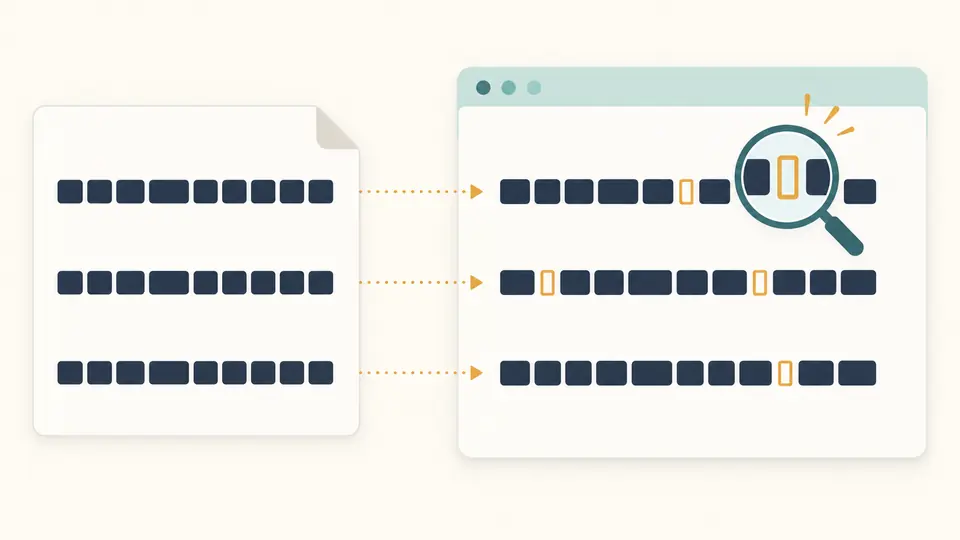
Le détecteur de caractères invisibles montre chaque occurrence au milieu du texte voisin. En français, une espace fine insécable peut être voulue devant la ponctuation. Son code explique une différence de comparaison sans imposer sa suppression.

Deux lignes semblables dont les positions cachées apparaissent avec des marqueurs colorés.

Conserver les liaisons utiles

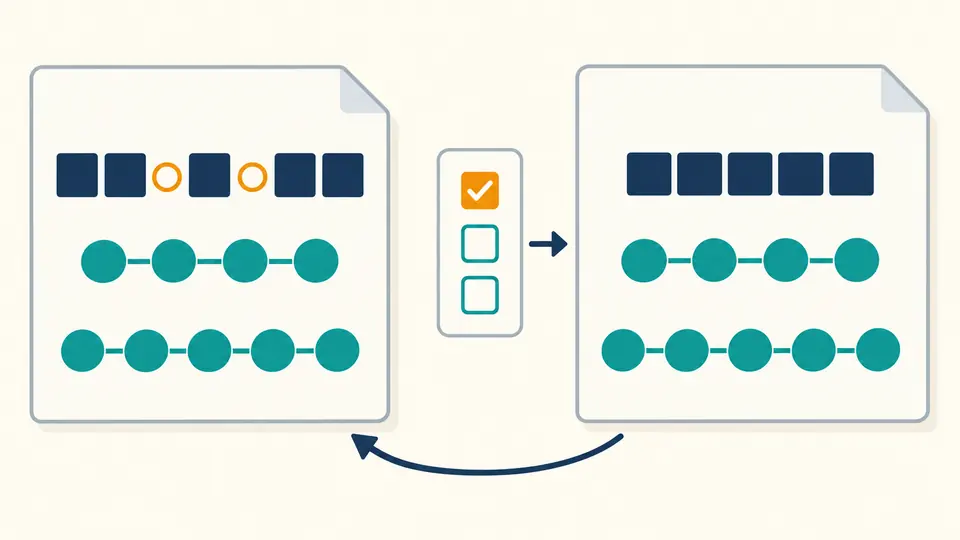
Un ZWJ peut réunir plusieurs symboles en un emoji, tandis que des marques directionnelles organisent un texte bilingue. Aucune catégorie de nettoyage n’est cochée au départ : vous choisissez celles dont la modification est réellement souhaitée.

Une seule catégorie de marqueurs supprimée, avec des groupes de symboles toujours reliés.

Contrôler un résultat avant de l’appliquer

01

Relancer après une modification

L’analyse est manuelle, par bouton ou Ctrl/Cmd+Enter. Modifier le texte ou les catégories rend le résultat précédent périmé et désactive l’export. Relancez l’analyse avant de préparer un nouvel aperçu du nettoyage.

02

Comparer les deux transformations

Les espaces spéciales deviennent des espaces ordinaires. Les autres catégories sélectionnées sont supprimées. Vérifiez le texte avant et après ainsi que les quantités ; supprimer des contrôles peut aussi joindre des lignes ou des colonnes.

03

Garder une possibilité de retour

Appliquer remplace l’entrée et actualise les résultats. Annuler restaure le précédent texte et son analyse. Exemple et Effacer passent également par un aperçu lorsqu’ils doivent remplacer une entrée déjà remplie.

Les détails utiles pour retrouver une occurrence

Nom, code et contexte logique

Chaque résultat donne le code U+, le nom et la catégorie. Dans le contexte de diagnostic, les contrôles sont des marqueurs visibles affichés dans l’ordre de stockage. Ils ne réorganisent donc pas le fragment que vous examinez.

Trois coordonnées distinctes

Le décalage UTF-16 et l’indice de point de code commencent à zéro ; ligne et colonne commencent à un. Une colonne compte les points de code. Un caractère supplémentaire occupe deux unités UTF-16, ce qui explique les indices différents.

Un rapport complet malgré la pagination

La liste affiche 50 occurrences supplémentaires à la fois. Le rapport JSON contient tous les résultats et leurs positions numériques, sans le texte source intégral. L’export texte correspond à l’entrée analysée ; il devient nettoyé uniquement après application.

Périmètre et effets à connaître

Une table fixe issue d’Unicode 17
L’analyse couvre les contrôles, les caractères de format, les espaces non ASCII, les sélecteurs de variation et certains fillers. Les formats ne sont pas tous invisibles ou nuisibles. Les espaces ASCII, homographes et accents combinatoires ordinaires sont hors périmètre. Fillers inclus : U+034F / U+115F / U+1160 / U+17B4 / U+17B5 / U+2800 / U+3164 / U+FFA0.
Des lignes logiques, pas visuelles
CRLF compte comme un saut ; CR, LF, NEL, LS et PS séparent aussi les lignes. Les colonnes ne comptent ni octets ni glyphes. L’outil analyse le texte remis par le navigateur, sans reconstruire les octets du fichier d’origine.
Une autorisation explicite par catégorie
Aucun nettoyage n’est présélectionné. Remplacer une espace spéciale enlève sa largeur ou son rôle insécable. Supprimer des contrôles peut fusionner des lignes ; supprimer des liaisons, sélecteurs ou marques bidi peut modifier une écriture parfaitement légitime.
Limite et UTF-16 incomplet
La limite est de 100 000 unités UTF-16, sans troncature silencieuse. Les substituts isolés sont signalés mais jamais réparés. La copie et le téléchargement de texte sont alors désactivés pour éviter une substitution avec perte ; le rapport JSON reste disponible.

Questions sur le détecteur de caractères invisibles

Comment supprimer les espaces sans largeur ?

Choisissez la catégorie des séparateurs sans largeur, relancez l’analyse puis examinez l’aperçu. Seule l’application confirme le changement. Les liaisons ZWJ et ZWNJ appartiennent à une autre catégorie pour pouvoir les conserver lorsqu’elles servent à la langue ou aux emoji.

Des caractères cachés peuvent-ils apparaître dans du texte IA ?

Oui, comme dans du texte provenant d’un site, d’un PDF ou d’un traitement de texte. Leur présence ne permet pas d’attribuer un texte à une IA ni de prouver un filigrane. Cette page inspecte des caractères, sans analyser l’auteur ou la génération.

Hangul Filler est-il un espace normal ?

Non. U+3164 est un caractère de remplissage hangul, distinct d’U+0020. Il figure dans la catégorie des autres formats et fillers. Si vous choisissez cette catégorie, il sera supprimé, tandis que la catégorie des espaces spéciales effectue des remplacements.

L’outil modifie-t-il automatiquement mon texte ?

Non. La détection et l’aperçu conservent l’entrée. Appliquer est nécessaire pour écrire le résultat dans le champ, et une annulation permet de retrouver l’état précédent. Modifier les options ne déclenche jamais de suppression en arrière-plan.

Le texte collé est-il envoyé à un serveur ?

Non. L’analyse et le nettoyage s’exécutent dans la mémoire du navigateur. Copier ou télécharger crée toutefois une sortie dans votre presse-papiers ou sur votre appareil ; la gestion de ces copies reste distincte du fonctionnement de cette page.

Une occurrence mérite une vérification ?

Revenir au fragment à vérifier

Utilisez le détecteur de caractères invisibles sur un exemple court, puis choisissez les seules catégories dont vous comprenez l’effet sur le texte final.