Unicode e internacionalización

detector de caracteres invisiblesrevisa lo que la pantalla oculta

Identifica la posición y el efecto de cada carácter antes de cambiarlo.

detector de caracteres invisibles

Texto de entrada

Posiciones detectadas

El texto permanece en este navegador y no se envía.

Confirmar cada categoría de limpieza

Todas empiezan sin seleccionar. Elegir una categoría confirma el efecto descrito; vuelve a detectar y revisa la vista previa antes de aplicar.

Subconjunto fijo de Unicode 17.0.0: 521 puntos de código y sustitutos aislados. No es una detección completa de visibilidad ni un veredicto de seguridad. Los nombres oficiales mantienen la notación Unicode.

Desplazamiento e índice empiezan en 0; línea y columna en 1. Las columnas cuentan puntos de código, no celdas visuales. CRLF es un salto; CR, LF, NEL, LS y PS también. Ambos caracteres CRLF pertenecen a la línea anterior.

Hasta 100.000 unidades UTF-16. Los CR/CRLF no editados se conservan como los entrega el navegador; los saltos nuevos usan LF. El editor puede mostrar finales de línea normalizados.

Las marcas son ayudas visuales, no caracteres insertados. Los controles se muestran en orden de almacenamiento sin ejecutarse. Contexto limitado a 24 unidades UTF-16 por lado.

Introduce texto o carga el ejemplo y detecta los caracteres.

El detector de caracteres invisibles ayuda cuando un nombre parece correcto pero no coincide en una búsqueda. Los espacios de ancho cero pueden partir una palabra sin dejar un hueco visible. Otros espacios se parecen al normal, aunque su código y comportamiento sean distintos.

Empieza con el fragmento mínimo que reproduce el fallo. El Unicode oculto puede llegar desde una web, un documento o un editor. Los controles de dirección también tienen usos legítimos; encontrar uno no demuestra por sí mismo un ataque ni una procedencia concreta.

Por qué usar este detector de caracteres invisibles

Una diferencia localizada en su contexto

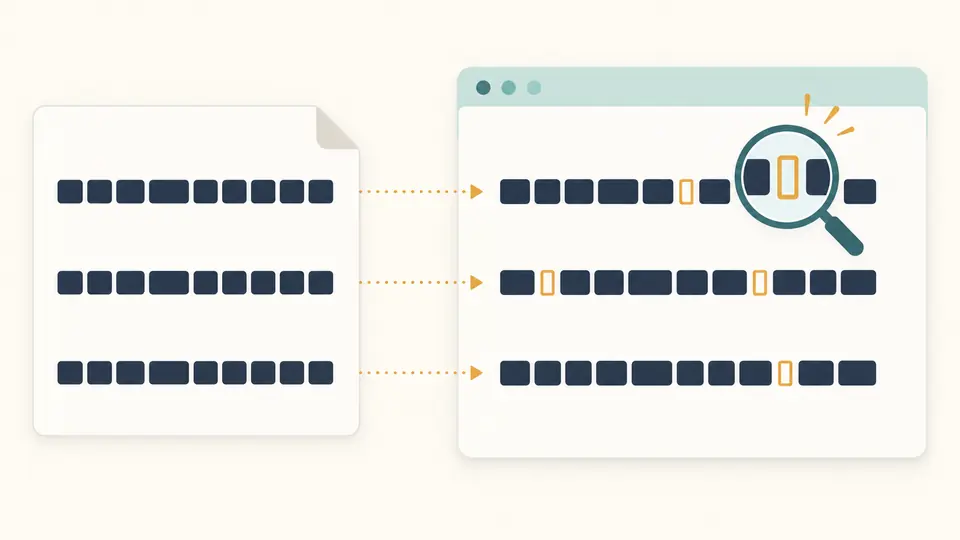
El detector de caracteres invisibles muestra cada hallazgo junto al texto que lo rodea. Un espacio sin separación entre una cifra y su unidad puede impedir un salto de línea y fallar al compararlo con un espacio corriente. El código permite distinguirlos.

Dos líneas parecidas con marcas de color que revelan posiciones ocultas.

Mantener las uniones que sí hacen falta

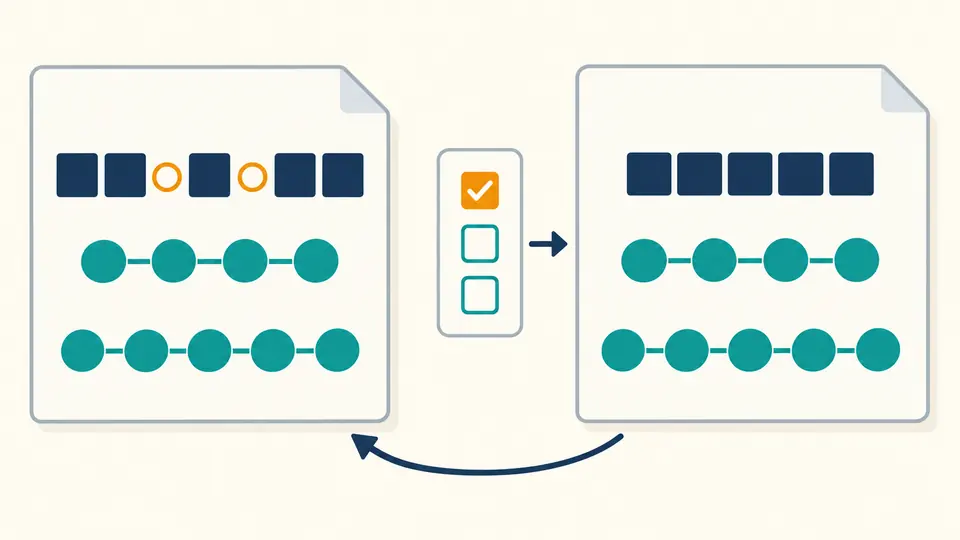
ZWJ puede unir varios símbolos en un emoji, y ZWNJ modifica la unión de letras en determinadas escrituras. Las categorías empiezan sin seleccionar para que puedas quitar separadores no deseados y conservar las uniones necesarias.

Se elimina una categoría de marcas y se conservan los grupos de símbolos unidos.

Revisar una captura antes de modificarla

01

Volver a detectar tras un cambio

La detección es manual, con el botón o Ctrl/Cmd+Enter. Al cambiar la entrada o las categorías, el resultado anterior queda desactualizado y se bloquea la exportación. Detecta de nuevo antes de preparar otra vista previa.

02

Distinguir sustituciones y eliminaciones

Los espacios especiales se sustituyen por espacios normales; las demás categorías elegidas se eliminan. Comprueba el antes, el después y las cantidades. Al eliminar controles también puedes unir columnas separadas por tabuladores o juntar líneas.

03

Conservar una opción para deshacer

Aplicar cambia la entrada y vuelve a detectar. Deshacer recupera la entrada y el resultado anteriores. Ejemplo y Limpiar también muestran una vista previa cuando van a reemplazar texto que ya está escrito.

Datos para revisar cada posición

Código, nombre y contexto lógico

Cada hallazgo incluye el código U+, el nombre y la categoría. El contexto de diagnóstico representa los controles mediante marcas visibles en orden de almacenamiento, de modo que no vuelvan a reorganizar el fragmento mostrado.

Tres coordenadas sin mezclarlas

El desplazamiento UTF-16 y el índice de punto de código empiezan en cero. La línea y la columna empiezan en uno; las columnas cuentan puntos de código. Un carácter suplementario ocupa dos unidades UTF-16 y puede separar ambos índices.

Lista por lotes e informe completo

Se muestran 50 hallazgos adicionales cada vez. El informe JSON incluye todos los hallazgos y sus posiciones numéricas, pero no el texto original completo. La salida de texto es la entrada analizada; solo estará limpia después de aplicar los cambios.

Alcance y consecuencias de la limpieza

Tabla fija basada en Unicode 17
Se inspeccionan controles, caracteres de formato, espacios no ASCII, selectores de variación y determinados rellenos. Un carácter de formato no siempre es invisible ni perjudicial. Los espacios ASCII, homógrafos y acentos combinados comunes quedan fuera del análisis. Rellenos incluidos: U+034F / U+115F / U+1160 / U+17B4 / U+17B5 / U+2800 / U+3164 / U+FFA0.
Líneas lógicas, no ajuste en pantalla
CRLF cuenta como un salto; CR, LF, NEL, LS y PS también dividen líneas. Las columnas no son bytes ni celdas visuales. Se analiza el texto entregado por el navegador, sin recuperar los bytes originales de un archivo.
Confirmación por cada categoría
Nada está seleccionado inicialmente. Sustituir espacios especiales pierde su anchura o función de impedir saltos. Borrar controles puede fusionar filas; eliminar uniones, selectores o marcas bidi puede alterar texto e incluso emoji que eran correctos antes de limpiar.
Límite y UTF-16 incompleto
El límite es de 100.000 unidades UTF-16; una entrada mayor se rechaza sin recortarla. Los sustitutos aislados se informan pero no se reparan. Para evitar pérdidas, se deshabilita copiar o descargar texto en ese caso; el informe JSON sigue disponible.

Preguntas del detector de caracteres invisibles

¿Cómo elimino espacios de ancho cero?

Selecciona los separadores de ancho cero, vuelve a detectar y abre la vista previa. Aplicar confirma la eliminación. ZWJ y ZWNJ tienen una categoría separada para conservarlos cuando forman parte de palabras o secuencias de emoji válidas.

¿Puede haber caracteres ocultos en texto generado por IA?

Sí, pero también aparecen en texto copiado de páginas, PDF, mensajería o editores. Su presencia no permite determinar que el autor sea una IA ni demostrar una marca de agua. Este análisis informa de caracteres, no del origen del contenido.

¿Hangul Filler es lo mismo que un espacio normal?

No. Hangul Filler es U+3164 y un espacio normal es U+0020. Se informa como relleno dentro de otros formatos. Elegir esa categoría lo elimina; elegir espacios especiales realiza una sustitución y no equivale a borrar todos los caracteres con aspecto vacío.

¿El detector cambia mi texto automáticamente?

No. Detectar y previsualizar mantienen la entrada intacta. Debes aplicar la propuesta para cambiarla. Después puedes deshacer una vez y recuperar el estado anterior; ajustar las opciones nunca borra texto por sí solo.

¿El texto pegado se envía a un servidor?

No. La detección y la limpieza se realizan en la memoria del navegador. Al copiar o descargar guardas una salida en el portapapeles o en tu dispositivo, de modo que esas copias deben gestionarse por separado si usas un equipo compartido.

¿Hay una posición que debamos revisar?

Volver al fragmento sospechoso

Prueba el detector de caracteres invisibles con un ejemplo pequeño y cambia únicamente las categorías cuyo efecto quieres introducir en el texto de destino.