01
Distinguir un punto de un byte
En puntos de código se admiten U+0041, 0x41 y 41. En bytes, cada valor debe tener dos dígitos hexadecimales. Use espacios o comas como separadores; no pegue una cadena hexadecimal continua ni entidades HTML.
Unicode e internacionalización
Compare puntos, unidades y bytes sin modificar la secuencia.
La vista previa muestra hasta 4.000 caracteres; copia y descarga incluyen toda la salida. El texto se previsualiza con marcadores de diagnóstico escapados.
La entrada permanece en este navegador y no se sube.
Texto: hasta 10.000 unidades UTF-16. Entrada codificada: hasta 200.000 caracteres y un máximo de 10.000 unidades al decodificar. Puntos: U+HEX, 0xHEX o HEX; bytes: dos dígitos HEX con 0x opcional. Separe con espacios o comas. No se interpretan escapes ni entidades HTML.
Nombres: Unicode 17.0.0. Grafemas: Intl.Segmenter del navegador; no expone su versión Unicode y esta puede diferir. Nombres oficiales y alias de control permanecen en inglés.
El orden de bytes es explícito. Se conserva U+FEFF inicial; no se detecta, elimina ni añade BOM. Sin normalización. Se conservan CR/CRLF recibidos intactos del navegador; el campo muestra los saltos como LF.
Las posiciones cuentan unidades UTF-16 desde 0 y excluyen el extremo final. Líneas, columnas y bytes de error empiezan en 1; los bytes ausentes apuntan justo después de la entrada. El recuento escalar excluye sustitutos aislados.
Introduzca texto o cargue un ejemplo.
El inspector de caracteres Unicode permite comprobar qué contiene un emoji antes de atribuir un fallo a la fuente o al contador. Una imagen de una familia puede contener varios puntos de código unidos, aunque se perciba como un solo símbolo.
Los caracteres invisibles también ocupan posiciones. Un espacio de ancho cero o un selector de variación puede explicar por qué dos cadenas no coinciden. La inspección expone su secuencia; no decide eliminarlos ni cambia automáticamente la normalización.
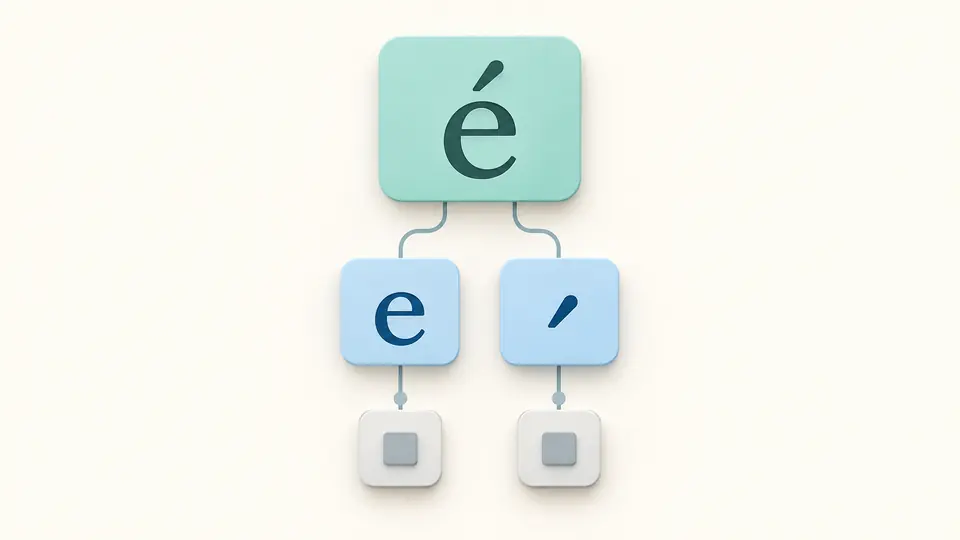
Con el inspector de caracteres Unicode puede comparar un grafema con sus componentes. Una vocal seguida de un acento combinante suma dos puntos y dos unidades UTF-16. Un emoji fuera del plano básico puede sumar un punto y dos unidades. Son mediciones distintas.
Introduzca bytes UTF-8 separados para reconstruir el texto. En UTF-16 y UTF-32 elija LE o BE expresamente. Los errores señalan la posición problemática en vez de producir un carácter de reemplazo que ocultaría el fallo original.
En puntos de código se admiten U+0041, 0x41 y 41. En bytes, cada valor debe tener dos dígitos hexadecimales. Use espacios o comas como separadores; no pegue una cadena hexadecimal continua ni entidades HTML.
La inspección automática se ejecuta tras 250 ms sin escribir. Al desactivarla, use el botón o Ctrl/Cmd+Enter. Con entrada existente, Ejemplo y Vaciar requieren vista previa y Aplicar; Deshacer recupera el estado anterior. El ejemplo entra directamente si el campo está vacío.
JSON es la salida inicial. La lista carga 50 entradas cada vez y la vista previa muestra como máximo 4.000 caracteres. La copia y descarga son completas. El texto válido se copia con sus caracteres reales, aunque la vista previa utilice marcadores seguros.
La base de nombres es Unicode 17.0.0. Los alias de controles se distinguen de los nombres oficiales. Uso privado, no caracteres, sustitutos y valores sin asignar reciben una indicación de tipo cuando no existe nombre.
Los intervalos UTF-16 empiezan en cero y excluyen el final. Los errores usan línea, columna y byte desde uno. Así puede relacionar una entrada con los índices de una cadena sin confundir bytes y unidades.
Elija diagnóstico U+, unidades UTF-16, texto o bytes UTF-8/16/32. El informe JSON conserva el análisis completo. Cambiar la vista de detalles entre puntos y grafemas no equivale a cambiar el formato exportado.
Un punto de código identifica una posición en Unicode, escrita habitualmente como U+ seguida de hexadecimal. No equivale necesariamente a un símbolo visible. Un carácter puede requerir varias unidades de codificación y un grafema puede reunir varios puntos.
Un emoji puede incluir modificadores de tono, selectores de variación o uniones ZWJ. Cada componente tiene su propia entrada por punto de código. La vista de grafemas permite ver su agrupación según el navegador sin borrar los componentes.
Sí: los valores y nombres ayudan a identificar espacios especiales, controles y componentes sin ancho visible. La vista usa marcadores para examinarlos. Eso no constituye una comprobación universal de visibilidad ni una valoración de seguridad.
Sí, incluidos los que ocupan dos unidades UTF-16 y las secuencias de varios puntos. La agrupación depende del navegador y la apariencia depende de la fuente; el análisis no garantiza que un dispositivo dibuje todos los emojis.
No admite archivos, lectura de URL, búsqueda por nombre, reparación automática ni escapes como formato de entrada. Tampoco normaliza ni elimina caracteres. El propósito es conservar evidencia sobre puntos, unidades y bytes de un fragmento acotado.
¿Hay un resultado que necesita explicación?
Abra el inspector de caracteres Unicode con el fragmento que produce la diferencia. Elija una representación y conserve el informe completo para comparar el resultado con su aplicación.