01
값의 종류부터 정하기
코드 포인트는 U+0041, 0x41, 41을 허용합니다. 바이트는 두 자리 16진수 토큰을 공백이나 쉼표로 나눠야 합니다. 연속된 긴 16진수 문자열, JavaScript 이스케이프, HTML 엔티티는 해당 입력으로 해석하지 않습니다.
Unicode 및 국제화
텍스트와 인코딩 값을 같은 기준으로 확인합니다.
미리보기는 출력 4,000자까지 표시합니다. 복사와 다운로드는 전체 출력을 포함합니다. 텍스트 미리보기는 이스케이프된 진단 표식을 사용합니다.
입력은 이 브라우저에만 머물며 업로드되지 않습니다.
텍스트는 UTF-16 단위 10,000개까지, 인코딩 입력은 200,000자까지 허용하며 디코딩 후에도 10,000단위 이하여야 합니다. 코드 포인트는 U+HEX, 0xHEX 또는 HEX, 바이트는 두 자리 HEX이며 0x는 선택 사항입니다. 공백이나 쉼표로 구분하세요. 이스케이프와 HTML 엔티티는 해석하지 않습니다.
이름 데이터는 Unicode 17.0.0입니다. 자소는 브라우저의 Intl.Segmenter를 사용하며 해당 Unicode 버전은 공개되지 않아 다를 수 있습니다. 공식 이름과 제어 문자 별칭은 영어를 유지합니다.
바이트 순서를 직접 선택합니다. 맨 앞 U+FEFF를 유지하며 BOM을 감지·제거·추가하지 않습니다. 정규화하지 않습니다. 브라우저에서 그대로 받은 CR/CRLF는 보존하지만 입력창은 줄 끝을 LF로 표시합니다.
상세 위치는 0부터 세는 UTF-16 단위이며 끝 위치는 포함하지 않습니다. 오류의 행·열·바이트 위치는 1부터 시작하고 부족한 바이트는 입력 바로 다음을 가리킵니다. 스칼라 개수에는 고립된 서로게이트가 포함되지 않습니다.
텍스트를 입력하거나 예제를 불러오세요.
Unicode 문자 검사기는 화면에서 한 글자로 보이는데 문자열 길이는 다르게 나올 때 유용합니다. 한글 음절 하나와 분리된 자모 조합은 비슷하게 보일 수 있지만 저장된 코드 포인트가 다릅니다. 먼저 실제 입력의 구성을 확인하세요.
이 도구는 유니코드 변환기처럼 코드 포인트와 바이트에서 텍스트로 돌아가는 입력도 제공합니다. 다만 잘못된 바이트를 임의로 고치거나 원문을 정규화하지 않습니다. 서로 다른 값이 어디서 생겼는지 확인할 근거를 그대로 남깁니다.
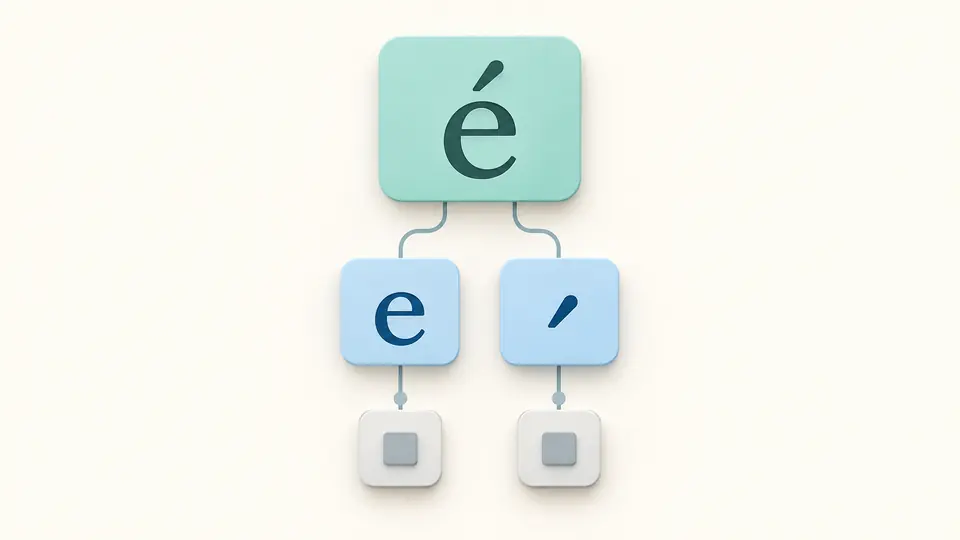
Unicode 문자 검사기로 결합 악센트와 기본 문자를 살펴보면 하나의 자소가 두 코드 포인트로 나뉘는 모습을 확인할 수 있습니다. 이모지는 한 코드 포인트가 UTF-16 두 단위를 쓰기도 합니다. 자소·코드 포인트·단위는 서로 바꿔 쓸 수 있는 개수가 아닙니다.
로그에 나온 UTF-8 바이트를 공백으로 구분해 입력하세요. UTF-16과 UTF-32는 LE 또는 BE를 직접 선택합니다. 잘못된 시퀀스는 오류 위치로 안내하며 맨 앞 FEFF를 보고 바이트 순서를 바꾸거나 문자를 없애지 않습니다.
코드 포인트는 U+0041, 0x41, 41을 허용합니다. 바이트는 두 자리 16진수 토큰을 공백이나 쉼표로 나눠야 합니다. 연속된 긴 16진수 문자열, JavaScript 이스케이프, HTML 엔티티는 해당 입력으로 해석하지 않습니다.
자동 검사는 입력이 250ms 멈추면 실행됩니다. 자동을 끄면 검사 버튼이나 Ctrl/Cmd+Enter를 사용하세요. 입력이 있을 때 예제와 비우기는 미리보기 후 적용하며 실행 취소로 되돌릴 수 있습니다. 빈 입력에는 예제가 바로 들어갑니다.
기본 출력은 JSON입니다. 상세 목록은 50개씩 추가하고 출력 미리보기는 4,000자까지 보여 줍니다. 복사와 다운로드에는 전체 결과가 포함됩니다. 유효한 텍스트 출력은 안전 표식 대신 실제 문자를 복사합니다.
Unicode 17.0.0 이름 데이터를 사용하고 제어 문자 별칭을 따로 표시합니다. 사용자 영역, 비문자, 서로게이트, 미할당 값에는 유형을 붙입니다. 공식 이름이 없는 자리에 임의의 이름을 만들지 않습니다.
상세 범위는 UTF-16 단위를 0부터 세며 끝 위치는 제외합니다. 오류의 행·열·바이트 위치는 1부터 시작합니다. 보이는 글자 수와 인덱스를 혼동하지 않도록 스칼라와 고립 단위도 따로 셉니다.
JSON 보고서, U+ 진단, UTF-16 코드 단위, UTF-8/16/32 바이트와 텍스트를 선택할 수 있습니다. 상세 보기의 자소 그룹과 출력 형식은 별개입니다. 제어 문자는 텍스트 미리보기에서 안전한 진단 표식으로 나타납니다.
네. 두 UTF-16 단위를 사용하는 이모지와 ZWJ, 피부색 수정자 등이 포함된 시퀀스를 검사합니다. 코드 포인트 보기에서는 구성 요소가 나뉘고 자소 보기에서는 브라우저 기준으로 묶입니다. 실제 그림이 표시되는지는 글꼴에 달려 있습니다.
HTML에서 특수 문자를 표현하는 표기입니다. 예를 들어 &는 앰퍼샌드를 나타냅니다. 이 도구는 HTML 엔티티를 디코딩하는 도구가 아니므로 실제 문자를 붙여넣거나 지원하는 코드 포인트·바이트 형식을 사용하세요.
아니요. 입력은 브라우저에서 처리되며 이름 데이터를 불러올 때도 입력을 전송하지 않습니다. 파일 업로드 기능은 없습니다. 결과는 사용자가 복사하거나 다운로드할 때 가져갈 수 있습니다.
파일이나 URL 읽기, 이름 검색, HTML·CSS·JavaScript 이스케이프 입력, 자동 정규화와 정리는 지원하지 않습니다. 글꼴 표시나 보안도 판정하지 않습니다. 잘못된 바이트를 고쳐서 처리하지 않고 오류로 알립니다.
너비가 없는 구분자, 제어 문자, 일부 서식 문자 등은 화면에서 직접 보이지 않을 수 있습니다. 다만 실제 가시성은 문맥과 글꼴에 따라 달라집니다. 코드와 진단 표식을 보고 확인할 수 있지만 모든 값을 숨은 문자나 위험 요소로 분류하지는 않습니다.
결과에 더 필요한 설명이 있나요?
Unicode 문자 검사기에 오류가 재현되는 짧은 구간을 넣어 보세요. 어떤 값과 인덱스가 다른지 확인한 뒤 필요한 형식으로 전체 결과를 보관하세요.