01
コードポイントとバイトを区別する
コードポイントはU+3042、0x3042、3042のいずれでも入力できます。バイトはE3 81 82のように2桁ずつ空白またはカンマで区切ります。0x接頭辞も使えますが、連続した長い16進数やバックスラッシュのエスケープは受け付けません。
Unicodeと国際化
文字から情報を調べることも、コードポイントやバイト列から文字を確かめることもできます。
プレビューは出力の先頭4,000文字までです。コピーとダウンロードには全体を含みます。文字列のプレビューでは診断用エスケープを表示します。
入力はこのブラウザー内で処理され、アップロードされません。
文字列はUTF-16コード単位で10,000個まで。符号化入力は200,000文字までで、復号結果も10,000コード単位以内です。コードポイントはU+HEX、0xHEX、HEX、バイトは2桁の16進数(0x付きも可)で指定します。空白かカンマで区切ってください。エスケープやHTML実体参照には対応していません。
名前のデータはUnicode 17.0.0です。書記素はブラウザーのIntl.Segmenterで分割します。内部のUnicodeバージョンは取得できず、名前のデータと異なる場合があります。正式名と制御文字の別名は公式の英語表記です。
バイト順は選択した形式で決まります。先頭のU+FEFFを保持し、BOMの検出・削除・追加は行いません。入力の正規化もしません。ブラウザーから受け取った未編集のCR/CRLFは保持しますが、入力欄では改行をLFとして表示します。
詳細の位置は0始まりのUTF-16コード単位で、終端を含まない範囲です。エラーの行・列・バイト位置は1始まりです。欠落したバイトは入力の直後を示します。スカラー値の個数に孤立サロゲートは含めません。
文字を入力するか、サンプルを読み込んでください。
Unicode文字情報検索は、同じように見える文字を正確に区別したいときに役立ちます。濁点付きの仮名やアクセント付きの文字は、単独の値で表す場合と、基底文字に結合文字を続ける場合があります。表示だけで判断せず、保存された順序を確認しましょう。
文字列を入力すると、名前とコードポイントに加えてUTF-8バイト列、UTF-16コード単位を調べられます。U+表記や明示したバイト順の16進数からも入力できるので、仕様書の数値を実際の文字と照合できます。
Unicode文字情報検索では、見た目のまとまりである書記素と、その中のコードポイントを別々に表示します。結合した濁点が独立した値なのかを確認でき、文字数と文字列の長さが一致しない理由を追えます。
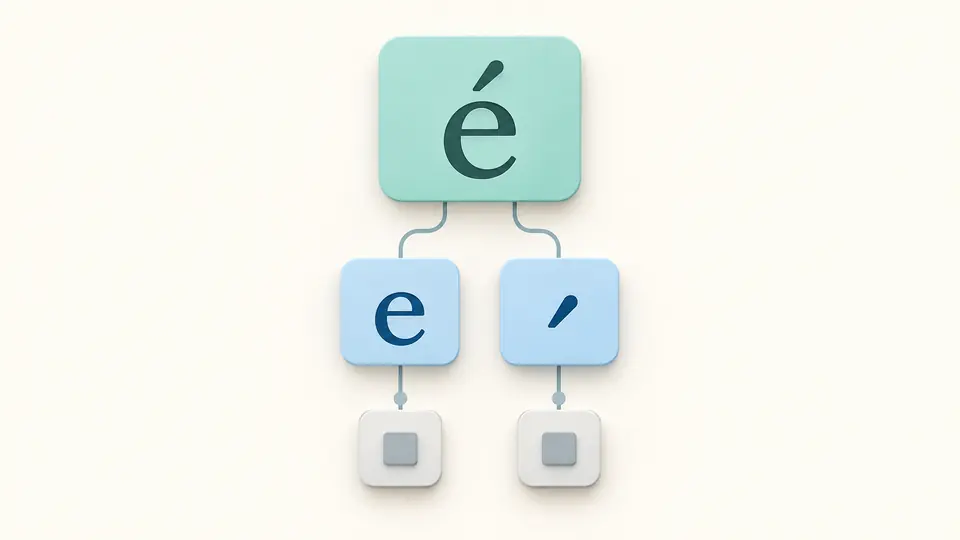
入力をUTF-8やUTF-16LE/BE、UTF-32LE/BEのバイト列に切り替えると、数値が表す文字を検査できます。復号後に別の符号化形式を出力すれば、バイト順による並びの違いも比較できます。
コードポイントはU+3042、0x3042、3042のいずれでも入力できます。バイトはE3 81 82のように2桁ずつ空白またはカンマで区切ります。0x接頭辞も使えますが、連続した長い16進数やバックスラッシュのエスケープは受け付けません。
初期設定では編集が止まって250 ms後に更新します。自動実行を切ると、ボタンまたはCtrl/Cmd+Enterで実行できます。既存入力をサンプルやクリアで置き換える場合は先に確認画面が出ます。適用後は元に戻せます。
詳細は50件ずつ追加表示し、書記素の境界にも切り替えられます。出力プレビューは4,000文字までですが、コピーとダウンロードは全体が対象です。文字列プレビューの診断記号は、実際にコピーされる文字とは区別してください。
Unicode 17.0.0の名前データと規則的な命名範囲を使用します。正式名は英語のまま示し、制御文字の別名は別項目にします。私用、非文字、未割り当てなどを区別するため、名前がないことを一律にエラーとはしません。
各項目にコード単位とスカラー値を表示し、出力形式ではUTF-16とUTF-32の大小両方のバイト順を選べます。4桁のUTF-16コード単位も出力できますが、その形式を入力として復号する機能はありません。
詳細範囲は0始まりのUTF-16コード単位で、終端位置は含みません。エラーの行・列・バイト位置は1始まりです。既定のJSONレポートは全体を保持するので、画面の折り返しや字体に頼らず位置を共有できます。
Unicodeのコード空間にある数値の位置です。通常はU+に16進数を続けて書き、例えばひらがなの「あ」はU+3042です。すべての位置に文字や正式名があるわけではなく、未割り当てや私用の値もあります。
補助平面の文字をUTF-16で表すときに使う、上位と下位の二つの16ビットコード単位です。一つのコードポイントでも二単位になります。家族などの絵文字はさらに複数コードポイントから成る場合があり、サロゲートペアとは別の組み合わせです。
送信されません。検査は現在のブラウザーで行い、入力した内容を外部の検索サービスに渡すこともありません。名前はこのツールのデータを使って調べます。
はい。テキスト形式で文字を貼り付けると、各項目のU+値と名前、符号化情報が表示されます。複数文字も入力でき、コードポイント形式から文字への逆方向にも対応しています。
同じではありません。Unicodeは文字などに値を割り当てる規格で、UTF-8はスカラー値を一つから四つのバイトに表す方式です。コードポイントの16進表記とUTF-8バイト列は、ASCII範囲外では同じ並びになりません。
名前や境界が想定と違いましたか?