01
Choisir la nature des nombres
Les points de code acceptent U+0041, 0x41 ou 41. Les octets exigent deux chiffres hexadécimaux par valeur, séparés par espaces ou virgules. Une entité HTML ou un échappement JavaScript n’est pas interprété.
Unicode et internationalisation
Comparez les unités stockées et les caractères perçus.
Aperçu limité à 4 000 caractères de sortie ; copie et téléchargement complets. L’aperçu texte utilise des marqueurs de diagnostic échappés.
La saisie reste dans ce navigateur, sans envoi vers un serveur.
Texte : 10 000 unités UTF-16 maximum. Saisie encodée : 200 000 caractères maximum, donnant au plus 10 000 unités. Points de code : U+HEX, 0xHEX ou HEX ; octets : deux chiffres HEX avec préfixe 0x facultatif. Séparer par des espaces ou virgules. Ni échappements ni entités HTML.
Noms : Unicode 17.0.0. Graphèmes : Intl.Segmenter du navigateur, dont la version Unicode n’est pas exposée et peut différer. Les noms officiels et alias de contrôle restent en anglais.
Ordre des octets explicite. U+FEFF initial conservé ; aucun BOM détecté, supprimé ou ajouté. Aucune normalisation. Les CR/CRLF reçus intacts du navigateur sont conservés ; le champ affiche les fins de ligne comme LF.
Les positions détaillées comptent les unités UTF-16 à partir de 0, borne finale exclue. Lignes, colonnes et positions d’octets des erreurs commencent à 1 ; un octet manquant pointe juste après la saisie. Le compte des scalaires exclut les substituts isolés.
Saisissez du texte ou chargez un exemple.
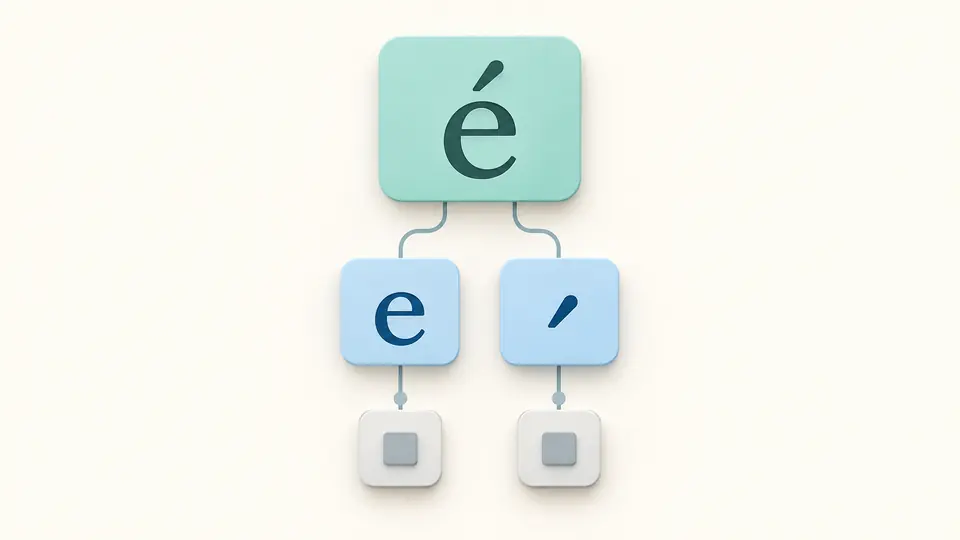
Un inspecteur Unicode est utile lorsqu’un accent visible ne correspond pas à un seul élément stocké. Dans « e » suivi d’un accent combinant, le navigateur peut reconnaître un graphème tandis que la chaîne contient deux points de code et deux unités UTF-16.
Le rendu dépend aussi de la police : deux lettres semblables peuvent appartenir à des écritures différentes. Comparez leurs valeurs avant de conclure à une erreur de saisie. Aucun caractère n’est normalisé ni supprimé pendant l’examen.
Cet inspecteur Unicode présente les graphèmes avec leurs composants. Pour un accent combinant, vous retrouvez le caractère de base et la marque séparément, avec leurs positions UTF-16. Cette distinction aide à expliquer un curseur ou une limite de longueur qui semble incohérente.
Les octets UTF-8 d’un journal peuvent être décodés directement. Pour UTF-16 et UTF-32, choisissez LE ou BE selon la source. Une séquence incorrecte produit une erreur localisée ; le décodage ne remplace pas silencieusement les valeurs invalides.
Les points de code acceptent U+0041, 0x41 ou 41. Les octets exigent deux chiffres hexadécimaux par valeur, séparés par espaces ou virgules. Une entité HTML ou un échappement JavaScript n’est pas interprété.
L’inspection automatique attend 250 ms de pause. En mode manuel, utilisez Inspecter ou Ctrl/Cmd+Entrée. Si du texte existe, Exemple et Effacer ouvrent un aperçu avant Appliquer ; Annuler le remplacement restaure l’état précédent. Un exemple se charge directement dans une saisie vide.
Le rapport JSON est sélectionné au départ. Les détails s’affichent par lots de 50 et l’aperçu de sortie se limite à 4 000 caractères. Copie et téléchargement prennent la totalité. Pour le texte valide, la copie contient les vrais caractères, pas les marqueurs de l’aperçu.
La table de noms utilise Unicode 17.0.0. Les alias de contrôle sont identifiés comme tels. Usage privé, non-caractères, substituts et valeurs non attribuées sont distingués sans leur inventer un nom officiel.
Le bilan sépare scalaires, unités UTF-16, graphèmes et unités isolées. Les positions détaillées commencent à zéro et excluent la borne finale ; les positions d’erreur commencent à un. Les octets ne sont pas confondus avec les unités de code.
Exportez JSON, diagnostic U+, unités UTF-16 ou octets UTF-8/16/32. L’ordre des octets reste celui choisi. Les marqueurs visibles protègent l’aperçu texte contre les effets des caractères de contrôle.
Un point de code est une valeur Unicode ; une unité UTF-16 est un élément de stockage de 16 bits ; un graphème représente un groupe perçu comme un caractère. Un emoji hors du plan de base peut occuper deux unités pour un point de code, et une séquence combinée plusieurs points pour un graphème.
Toutes les valeurs n’ont pas de nom officiel. Les caractères de contrôle peuvent avoir un alias ; l’usage privé dépend d’un accord externe. Les valeurs non attribuées dans Unicode 17.0.0 sont signalées selon cette version fixe, même si un navigateur plus récent sait les afficher.
C’est un caractère qui ressemble à un autre, par exemple certaines lettres latines et cyrilliques. Leurs valeurs diffèrent malgré leur apparence. Le rapport permet de les comparer, mais ne décide pas si leur emploi constitue une tentative de tromperie.
Oui. Collez une seule lettre ou saisissez son point de code dans le format correspondant. Vous pouvez aussi examiner une séquence complète ; la limite porte sur les unités UTF-16, et non sur le nombre de lettres visibles.
Non. L’analyse s’effectue dans le navigateur. Le chargement de la table des noms ne transmet pas votre saisie. Vous choisissez ensuite de copier ou télécharger le résultat pour le conserver.
Une explication mérite une précision ?
Cet inspecteur Unicode vous aide à formuler un constat précis : quelles valeurs sont présentes, où elles commencent et comment elles sont encodées. Repartez du fragment qui pose problème.