01
Commencer par NFC, lire les quatre états
NFC est sélectionné au départ, mais les quatre formes sont calculées simultanément. Si l’affichage semble inchangé, lisez les points U+ et les octets UTF-8 de la plage concernée.
Unicode et internationalisation
Comparez les quatre formes à la source puis examinez le résultat choisi.
L’aperçu montre au plus 4 000 caractères ; copie et téléchargement sont complets.
Le texte est traité dans ce navigateur et n’est pas envoyé.
Limite de 10 000 unités UTF-16 ; les entrées trop longues sont rejetées sans coupe.
La normalisation dépend de l’implémentation Unicode du navigateur, sans version fixée.
Saisissez du texte ou choisissez un exemple.
Deux libellés se ressemblent mais une recherche ne les reconnaît pas comme identiques ? Une lettre accentuée peut être un seul point de code ou une lettre suivie d’une marque combinante. Le normalisateur Unicode rend cette différence visible.
Avant d’unifier des noms ou des données, le normalisateur Unicode permet de comparer NFC et NFD. NFKC et NFKD modifient aussi certaines distinctions typographiques : mieux vaut inspecter le résultat avant de remplacer la source.
Comparer la séquence enregistrée plutôt que l’apparence.
Le convertisseur NFC et la conversion NFD partent chacun du même texte, sans enchaîner les résultats. Le résumé indique quelles formes sont déjà identiques à la source.
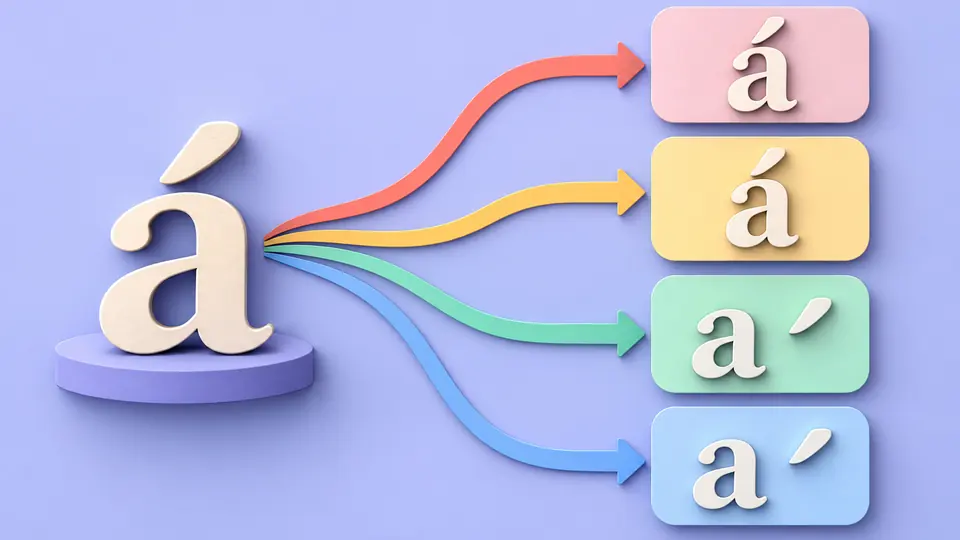
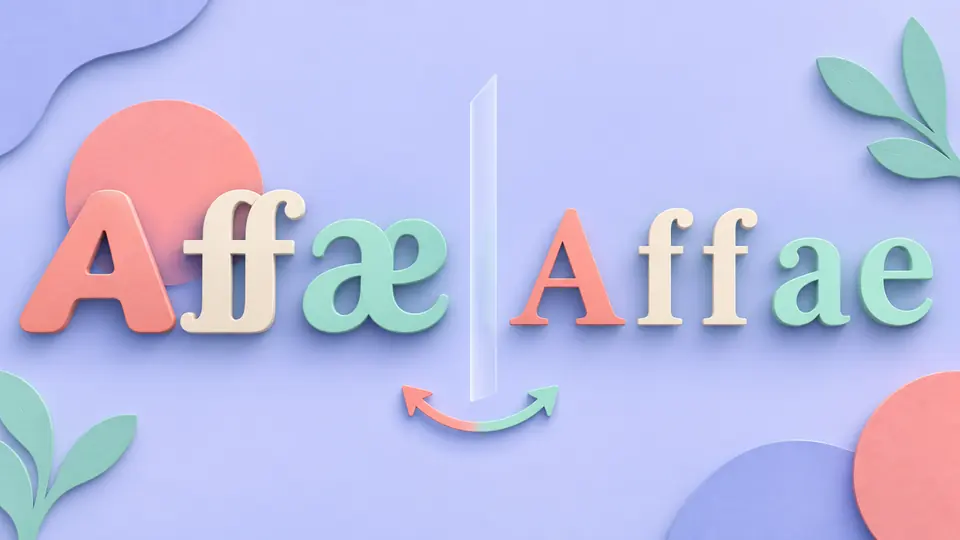
NFKC peut remplacer des lettres pleine chasse ou des ligatures par des lettres ordinaires. Le normalisateur Unicode conserve la source et souligne les plages modifiées avant tout remplacement.
NFC est sélectionné au départ, mais les quatre formes sont calculées simultanément. Si l’affichage semble inchangé, lisez les points U+ et les octets UTF-8 de la plage concernée.
Le mode texte entier préserve les fins de ligne. Le mode ligne traite chaque ligne séparément, y compris les vides, puis les relie avec LF. Gardez le mode entier si CRLF doit rester intact.
L’aperçu peut être abrégé mais la copie et le fichier contiennent tout. Sans vérification automatique, Ctrl/Cmd+Entrée lance l’analyse. Remplacer la saisie exige une confirmation et offre une annulation.
La normalisation Unicode compare séparément NFC, NFD, NFKC et NFKD à la source. Le nombre de points de code et d’octets UTF-8 accompagne chaque résultat.
Composer ou décomposer ne constitue pas toujours une substitution caractère pour caractère. Les changements sont groupés en plages avec séquences U+ et octets hexadécimaux des deux côtés.
Même si l’aperçu s’arrête à 4 000 caractères, l’export reste complet. La confirmation montre le texte avant et après ; une annulation restaure la saisie et ses résultats.
Collez le texte, puis choisissez NFC ou NFD. Les quatre sorties sont calculées depuis l’original ; NFC compose quand c’est possible, tandis que NFD effectue une décomposition canonique.
NFC et NFD utilisent l’équivalence canonique. NFKC et NFKD ajoutent des correspondances de compatibilité susceptibles d’effacer largeur, ligatures et exposants.
La lettre é peut être un seul point de code ou e suivi d’un accent combinant. Le rendu se ressemble, mais les points de code et octets UTF-8 diffèrent.
Non. Le contrôle, les différences et la préparation du téléchargement s’exécutent dans votre navigateur. Le texte n’est pas envoyé à un serveur de conversion.
Il ne retire pas les accents, ne change pas la casse, ne détecte pas les caractères trompeurs et ne lit aucun fichier. Le mode ligne concerne du texte collé, pas un CSV.
Une séquence vous surprend ?
Partez d’un court exemple qui pose problème, comparez les quatre formes puis choisissez le résultat adapté.