01
Empezar por NFC y revisar los cuatro estados
NFC aparece seleccionado, pero se calculan las cuatro formas. Si el texto parece igual, mira los valores U+ y los bytes UTF-8: la diferencia puede estar bajo el mismo glifo.
Unicode e internacionalización
Compara las cuatro formas con el original y examina los cambios de la forma elegida.
La vista previa muestra hasta 4000 caracteres; copia y descarga incluyen todo.
El texto se procesa en este navegador y no se sube.
Máximo 10 000 unidades UTF-16; se rechaza el exceso sin recortar.
La normalización usa la implementación Unicode del navegador; no se promete una versión fija.
Escribe texto o elige un ejemplo.
Si dos nombres se ven iguales pero una búsqueda no los considera idénticos, quizá usan secuencias Unicode distintas. Una letra acentuada puede ser un punto de código o una letra más un acento combinante. El normalizador Unicode permite ver la diferencia.
Antes de unificar nombres o datos, usa el normalizador Unicode para comparar NFC y NFD. NFKC y NFKD también pueden eliminar diferencias de ancho, ligaduras o superíndices: conviene revisar el resultado antes de reemplazar el original.
Distingue el aspecto del contenido almacenado.
La conversión NFC y la conversión NFD no se encadenan: las cuatro formas parten del original. El resumen muestra cuáles ya coinciden exactamente con él.
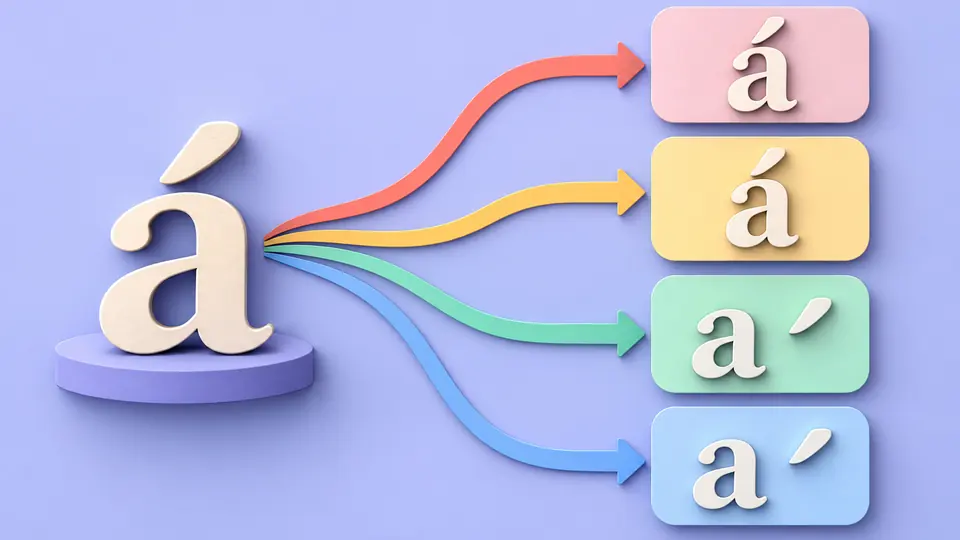
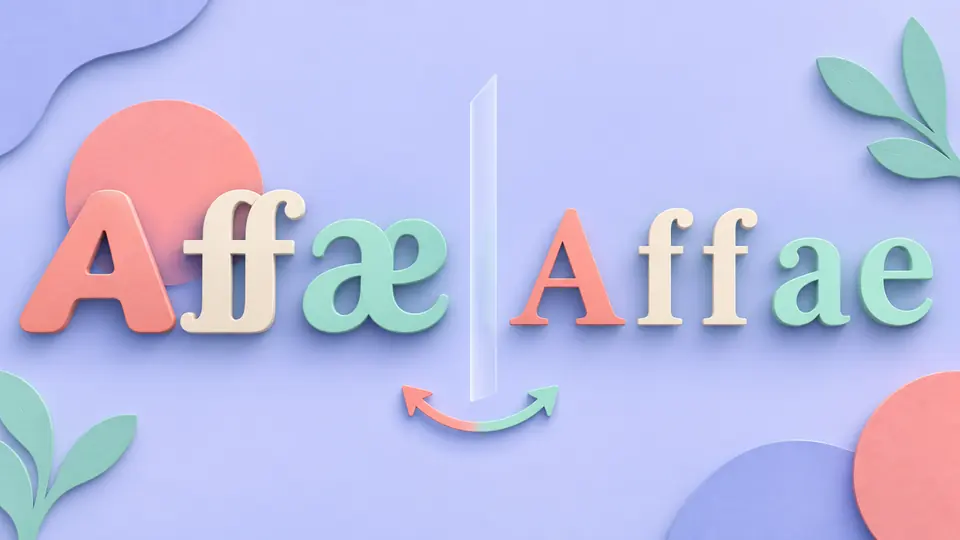
NFKC puede convertir letras de ancho completo o ligaduras en letras comunes. El normalizador Unicode conserva la entrada y resalta los cambios antes de pedir confirmación.
NFC aparece seleccionado, pero se calculan las cuatro formas. Si el texto parece igual, mira los valores U+ y los bytes UTF-8: la diferencia puede estar bajo el mismo glifo.
El modo completo conserva los saltos originales. Por líneas se procesa cada registro, incluidos los vacíos, y se unen con LF. Si necesitas mantener CRLF, usa texto completo.
Los rangos resaltados pueden contener varios puntos de código. Copiar y descargar usan la salida completa. Si desactivas la comprobación automática, Ctrl/Cmd+Intro ejecuta la prueba.
La normalización Unicode evalúa NFC, NFD, NFKC y NFKD contra la fuente. Cada forma indica si cambia y cuántos puntos de código y bytes UTF-8 produce. El convertidor NFC muestra específicamente la forma compuesta.
La composición y descomposición no siempre hacen una sustitución uno a uno. Los cambios se agrupan y muestran secuencias U+ y bytes UTF-8 de ambos lados.
La vista previa se limita a 4000 caracteres, pero la copia y el archivo incluyen todo. Aplicar un resultado exige vista previa; deshacer restaura entrada y resultados previos.
Pega el texto y elige NFC o NFD. Ambas salidas se calculan desde el original. NFC compone cuando puede y NFD aplica descomposición canónica; puedes copiar el resultado sin cambiar la entrada.
NFC y NFD conservan equivalencia canónica. NFKC y NFKD añaden correspondencias de compatibilidad que pueden eliminar diferencias de ancho, ligaduras o superíndices.
Una é puede guardarse como un único punto de código o como e más un acento combinante. Se ven igual, pero cambian la secuencia y los bytes UTF-8.
No. La comprobación, las diferencias y el archivo se preparan en el navegador. El texto no se envía a un servidor de conversión.
No quita acentos, no cambia mayúsculas, no detecta suplantaciones ni lee archivos. El modo por líneas procesa texto pegado, no formatos CSV o JSON.
¿Algún cambio inesperado?
Usa un fragmento que falle al compararlo, revisa las cuatro formas y elige solo el resultado que necesitas.