01
Comece por NFC e veja as quatro situações
NFC vem selecionado, mas as quatro formas são calculadas juntas. Mesmo quando a aparência não muda, consulte os valores U+ e os bytes UTF-8 do trecho alterado.
Unicode e internacionalização
Compare as quatro formas ao original e examine as diferenças do resultado escolhido.
A prévia mostra até 4.000 caracteres; cópia e download incluem tudo.
O texto é processado neste navegador e não é enviado.
Limite de 10.000 unidades UTF-16; entradas maiores são recusadas sem corte.
A normalização usa a implementação Unicode do navegador; nenhuma versão fixa é prometida.
Digite texto ou escolha um exemplo.
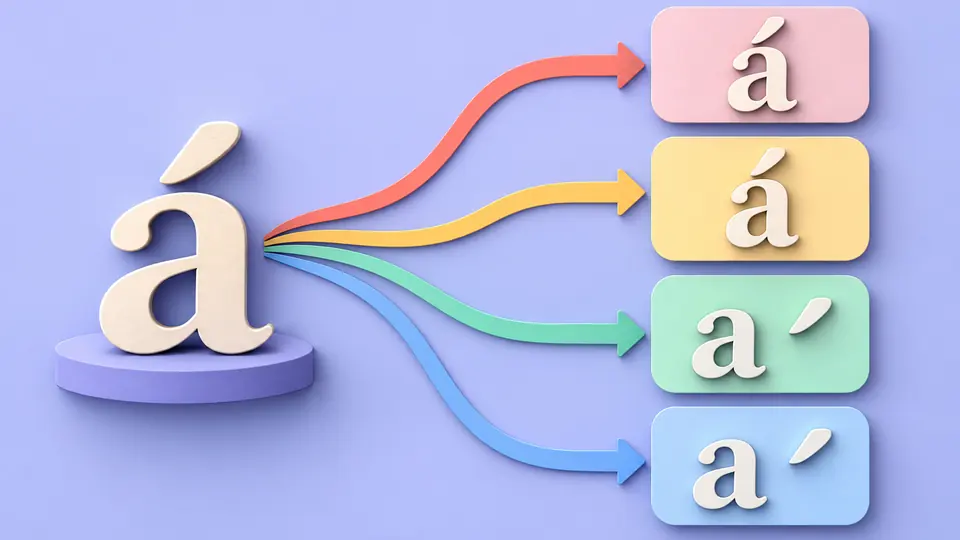
Dois nomes parecem iguais, mas não batem em uma busca? Uma letra acentuada pode ser um único ponto de código ou uma letra com acento combinante. O normalizador Unicode mostra essa diferença sem depender da aparência.
Antes de uniformizar nomes ou campos, use o normalizador Unicode para comparar NFC e NFD. NFKC e NFKD também podem dobrar largura, ligaturas e sobrescritos; confira o resultado antes de substituir a entrada.
A grafia visível nem sempre revela os valores armazenados.
O conversor NFC não alimenta o conversor NFD em sequência. Cada forma parte do texto original, permitindo saber quais já correspondem a ele.
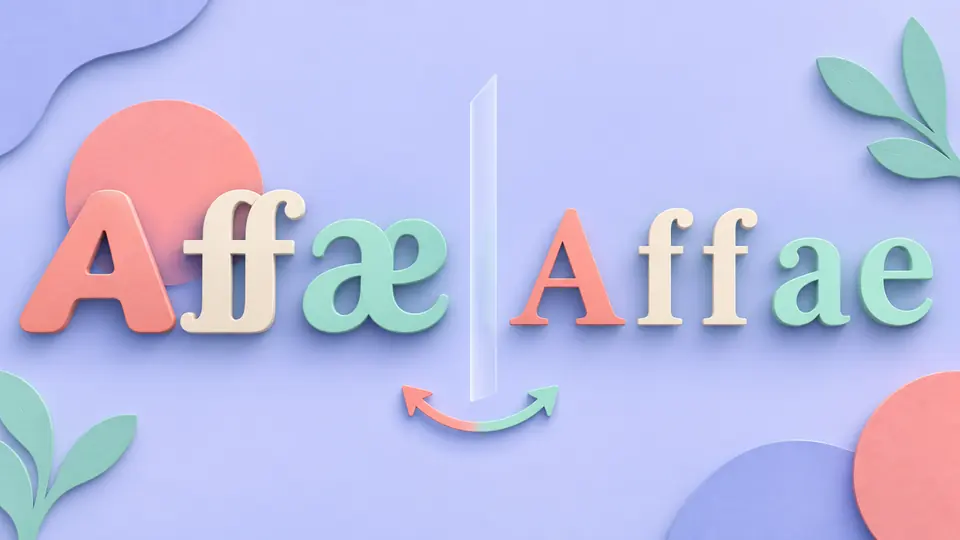
Letras de largura inteira e ligaturas podem virar letras comuns em NFKC. O normalizador Unicode preserva a entrada e destaca trechos alterados antes de qualquer substituição.
NFC vem selecionado, mas as quatro formas são calculadas juntas. Mesmo quando a aparência não muda, consulte os valores U+ e os bytes UTF-8 do trecho alterado.
Texto inteiro preserva as quebras originais. Por linha, cada registro é verificado separadamente, inclusive os vazios, e a saída usa LF. Para manter CRLF, fique no modo inteiro.
O destaque representa sequências, não caracteres em pares. Cópia e download levam a saída completa. Com o modo automático desligado, Ctrl/Cmd+Enter inicia a verificação.
A normalização Unicode compara NFC, NFD, NFKC e NFKD com a fonte. Cada forma mostra se mudaria e o total de pontos de código e bytes UTF-8.
Composição e decomposição podem envolver vários pontos. Os trechos alterados exibem sequências U+ e bytes hexadecimais antes e depois da conversão.
A prévia é limitada a 4.000 caracteres, mas a exportação é integral. Aplicar pede uma conferência do antes e depois; desfazer recupera entrada e resultados.
NFC costuma servir para texto geral, mas a exigência do sistema de destino é o que vale. Se ele pede decomposição canônica, escolha NFD; confira as diferenças antes de usar NFKC ou NFKD.
NFC e NFD preservam equivalência canônica; NFKC e NFKD também aplicam correspondências de compatibilidade. Essas últimas podem eliminar diferenças de largura, ligatura ou sobrescrito.
A forma composta de é usa um ponto de código e dois bytes UTF-8; e seguido do acento combinante usa dois pontos e geralmente três bytes. O painel mostra as sequências reais.
Emojis normalmente permanecem como estão nas quatro formas. A normalização não separa uma sequência emoji em componentes visuais; para inspecionar cada ponto use o inspetor Unicode.
As quatro formas ajudam a comparar texto de HTML ou CSS com a sequência esperada. Elas não substituem uma política de normalização definida para seu conteúdo, nem corrigem caracteres visualmente confundíveis.
Alguma alteração inesperada?
Cole o menor trecho que apresenta diferença, compare as quatro formas e use apenas a saída adequada ao destino.