01
Prefira o arquivo de origem
Arquivo e Hex preservam os bytes reais e mostram o deslocamento, a partir de zero, de erros UTF-8. O texto já colado não conserva a posição desses bytes no arquivo anterior.
Unicode e internacionalização
Compare interpretações sem alterar o texto nem os bytes de origem.
Digite texto, cole Hex ou escolha um arquivo.
Texto e bytes do arquivo são processados apenas neste navegador; nada é enviado.
Entrada ou opções mudaram. Aguardando nova análise.
Candidatos são hipóteses. Ser reversível não prova qual era o texto original.
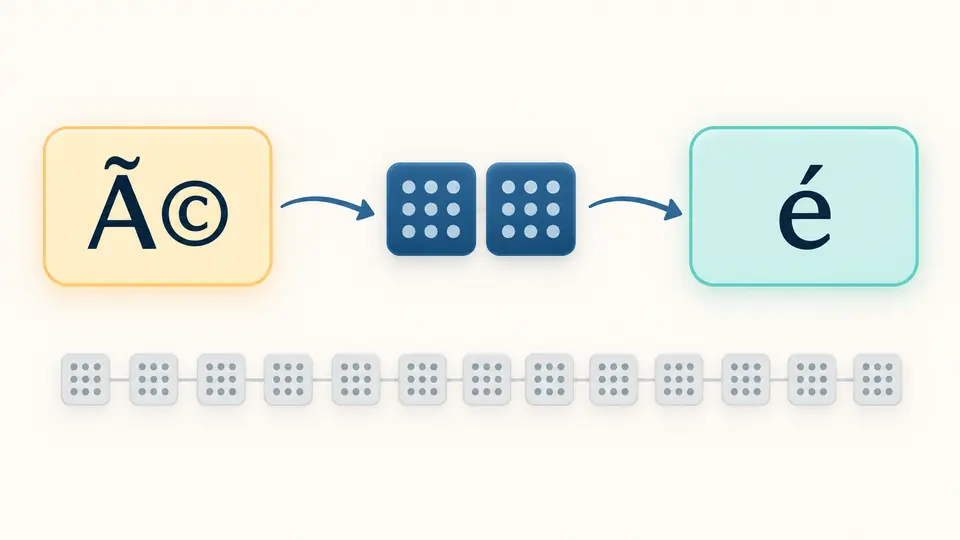
É hora de corrigir caracteres corrompidos quando um nome com acento vira “café” ou um CSV antigo apresenta símbolos estranhos. Comece com um trecho pequeno que contenha palavras conhecidas.
Se o arquivo original ainda existe, use os bytes dele. Tentar corrigir caracteres estranhos só a partir de texto corrompido não recupera valores que outro aplicativo já trocou por �.
O material de origem continua disponível ao testar cada hipótese.
Ao corrigir caracteres corrompidos, os bytes de um arquivo ou de Hex permanecem intactos. UTF-8, GBK e outros decodificadores geram prévias separadas; escolher uma não altera a origem.
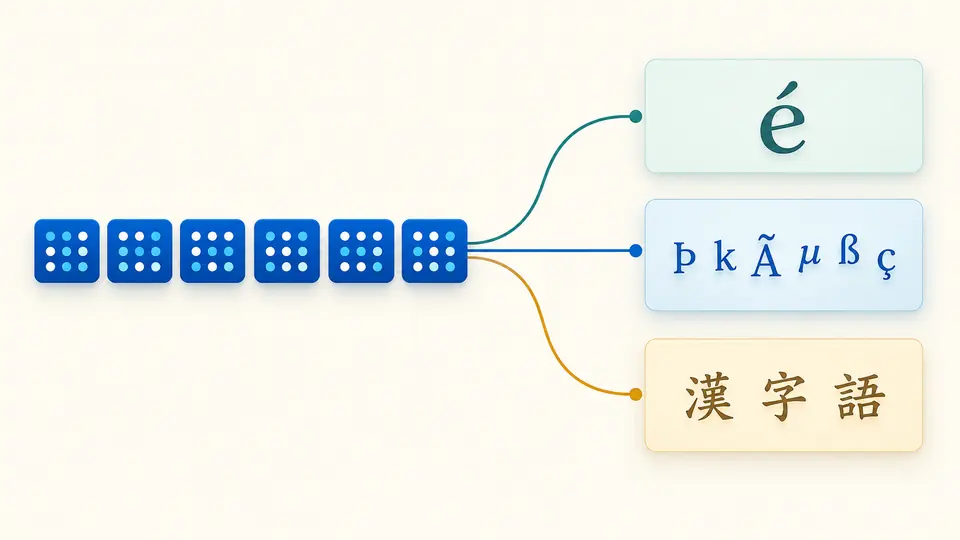
Para texto colado, a ferramenta refaz os bytes conforme a codificação da leitura equivocada e depois interpreta pela codificação original presumida. O caminho aparece junto do candidato.
Arquivo e Hex preservam os bytes reais e mostram o deslocamento, a partir de zero, de erros UTF-8. O texto já colado não conserva a posição desses bytes no arquivo anterior.
“Gravado originalmente em” indica a primeira codificação; “lido por engano como” indica a interpretação posterior. Alterar uma opção invalida imediatamente o resultado anterior.
Um caminho reversível não é prova de correção. Compare nomes, acentos e pontuação; a cópia e o download exigem uma análise atualizada.
Em bytes de arquivo ou Hex, a análise aponta inícios, continuações e sequências truncadas inválidas. A codificação UTF-8 não recebe um falso deslocamento quando a entrada é só texto colado.
Leituras ocidentais, cirílicas e do leste asiático aparecem separadas. Um reparador de mojibake mostra hipóteses, sem declarar que a primeira é necessariamente a correta.
O candidato escolhido é salvo como novo texto UTF-8. Os bytes iniciais podem ser baixados à parte, permitindo reexaminar uma escolha ruim sem perder a origem.
Ele surge quando bytes gravados em uma codificação são lidos em outra. A mesma sequência então passa a representar caracteres diferentes.
Não. A análise e a seleção de candidato não modificam a entrada. O download cria um arquivo novo e o original continua disponível.
Você pode ler os bytes de um CSV local e salvar a prévia escolhida como texto UTF-8. A ferramenta não analisa colunas nem regrava o arquivo original.
Elas podem ter passado por várias conversões ou já conter � no lugar dos bytes antigos. Tente obter uma exportação anterior e avalie trechos separados.
Eles descrevem uma hipótese sobre como os bytes foram gravados e depois lidos por engano. Use a direção manual e compare o resultado com o contexto, sem tratar o rótulo como certeza.
Encontrou outro caso difícil?
Para corrigir caracteres corrompidos neste trecho, compare candidatos com o contexto e preserve os bytes antes de salvar uma interpretação.