Unicode e internacionalização

inspetor de caracteresentenda as diferenças que a tela não mostra

Compare a estrutura do texto com suas representações codificadas.

inspetor de caracteres

Texto ou entrada codificada

Prévia da saída

A prévia mostra até 4.000 caracteres; cópia e download incluem toda a saída. A prévia de texto usa marcadores de diagnóstico escapados.

A entrada fica neste navegador e não é enviada.

Texto: até 10.000 unidades UTF-16. Entrada codificada: até 200.000 caracteres, resultando em até 10.000 unidades. Pontos: U+HEX, 0xHEX ou HEX; bytes: dois dígitos HEX com 0x opcional. Separe por espaços ou vírgulas. Sem escapes ou entidades HTML.

Nomes: Unicode 17.0.0. Grafemas: Intl.Segmenter do navegador; a versão Unicode não é informada e pode ser diferente. Nomes oficiais e aliases de controle permanecem em inglês.

A ordem dos bytes é explícita. U+FEFF inicial é preservado; nenhum BOM é detectado, removido ou adicionado. Sem normalização. CR/CRLF recebidos intactos do navegador são preservados; o campo exibe quebras como LF.

As posições dos detalhes contam unidades UTF-16 a partir de 0, com fim exclusivo. Linha, coluna e byte de erro começam em 1; bytes ausentes apontam logo após a entrada. A contagem escalar exclui substitutos isolados.

Digite um texto ou carregue um exemplo.
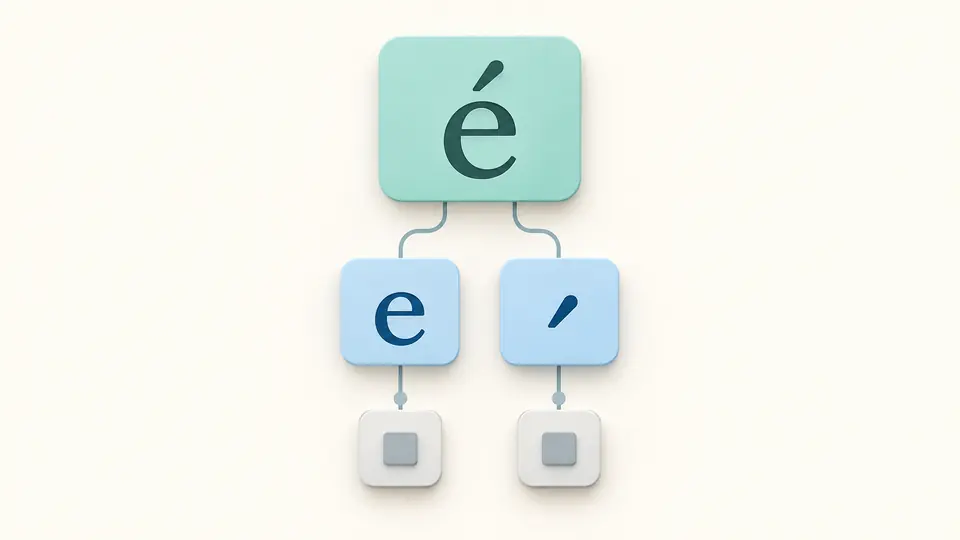
O inspetor de caracteres ajuda quando “ação” parece igual em duas fontes, mas a comparação exata falha. Uma letra acentuada pode estar pronta em um ponto de código ou ser formada por letra e acento combinante. A aparência sozinha não esclarece essa diferença.

Confira também os caracteres invisíveis, espaços especiais e componentes de emojis. Eles podem aumentar o comprimento armazenado sem acrescentar uma letra visível. A ferramenta mantém a sequência original para que a causa continue disponível no diagnóstico.

O que revela o inspetor de caracteres

Explicar a diferença de comprimento

O inspetor de caracteres separa unidades UTF-16, pontos e grafemas. Um acento combinante pode acompanhar uma letra no mesmo grafema, mas ocupar outro ponto e outra unidade. Essa distinção permite interpretar limites de formulário e índices de cadeias com mais precisão.

Uma letra com acento combinante forma um grafema e se divide em dois pontos e unidades.

Conferir a sequência recebida em bytes

Cole bytes UTF-8 de um registro para reconstruir o texto, ou escolha UTF-16LE/BE e UTF-32LE/BE. A ordem escolhida é respeitada. Uma sequência inválida produz erro localizado, sem inserir silenciosamente um caractere de substituição.

Caracteres e grupos de bytes ligados por setas de ida e volta, sem texto.

Da entrada ao relatório completo

01

Selecionar o formato antes de interpretar

Pontos de código aceitam U+0041, 0x41 ou 41. Bytes exigem pares hexadecimais separados por espaços ou vírgulas; 0x é opcional. Um bloco hexadecimal contínuo não é aceito como sequência de bytes, e escapes não são interpretados.

02

Acompanhar atualização e substituição

A inspeção automática espera 250 ms após a digitação. No modo manual, use Inspecionar ou Ctrl/Cmd+Enter. Exemplo e Limpar abrem uma prévia quando já existe entrada; Aplicar confirma e Desfazer restaura o estado anterior. Em campo vazio, o exemplo é carregado diretamente.

03

Exportar a representação necessária

JSON é o formato inicial. Os detalhes avançam em grupos de 50 e a prévia mostra até 4.000 caracteres. Copiar e baixar incluem a saída inteira. Na saída de texto válido, os marcadores visuais da prévia dão lugar aos caracteres reais na cópia.

Informações para conferir uma cadeia

Nomes com origem definida

Os nomes seguem Unicode 17.0.0. Aliases de controle são separados de nomes oficiais. Uso privado, não caracteres, substitutos e pontos não atribuídos recebem tipos próprios, sem preencher a ausência com um nome inventado.

Posições úteis no código

Os intervalos contam unidades UTF-16 desde zero e não incluem o fim. Linha, coluna e byte de erro começam em um. Um ponto fora do plano básico ocupa duas unidades UTF-16, o que explica deslocamentos diferentes do número de símbolos.

Saída além da aparência

Compare diagnóstico U+, unidades UTF-16 e bytes UTF-8/16/32. A visão de grafemas mostra agrupamentos quando disponível, enquanto o relatório JSON mantém a análise completa mesmo que a lista visível esteja reduzida.

Limites e preservação dos dados

Decodificação sem reparos
Entradas codificadas exigem valores escalares válidos, sem substitutos ou valores acima de U+10FFFF. UTF-8 rejeita sequências excessivas e incompletas. UTF-16 exige pares válidos e quantidade par de bytes; UTF-32 exige grupos válidos de quatro bytes.
Substitutos isolados são preservados
No modo texto, essas unidades podem ser inspecionadas e contadas separadamente. Elas desativam grafemas e exportação de texto ou bytes. JSON, diagnóstico U+ e unidades UTF-16 continuam copiáveis; U+ de substituto não é uma entrada escalar reversível.
Sem normalização ou adivinhação
U+FEFF inicial permanece no conteúdo. Não se adiciona nem remove BOM, e a ordem dos bytes nunca é inferida. Não há limpeza automática, upload de arquivos, pesquisa por nome ou avaliação de intenção maliciosa.
Tamanho e segmentação
São permitidas 10.000 unidades UTF-16 de texto ou 200.000 caracteres codificados, com o mesmo limite depois de decodificar. Excesso é rejeitado, não cortado. Grafemas usam Intl.Segmenter; a API não revela sua versão Unicode e, se ausente, a contagem fica indisponível.

Dúvidas sobre o inspetor de caracteres

Como os emoji são tratados?

Emojis são examinados por seus pontos de código. Alguns ocupam duas unidades UTF-16; outros incluem tom de pele, seletor de variação e ZWJ. A visão de grafemas reúne componentes conforme o navegador, sem garantir que toda fonte consiga desenhar o resultado.

Qual é a diferença entre ponto de código e bytes UTF-8?

Um ponto de código identifica uma posição Unicode. Bytes UTF-8 são sua representação codificada, de um a quatro bytes por escalar. Por isso contar bytes, pontos e letras visíveis pode produzir três resultados diferentes, todos corretos para sua finalidade.

Meu texto é carregado?

Não. A análise ocorre no navegador, e a entrada não acompanha o carregamento da tabela de nomes. Você decide se quer copiar ou baixar a saída; não há importação de arquivos ou envio automático do relatório.

Por que o comprimento da cadeia excede os caracteres visíveis?

O comprimento de uma cadeia JavaScript conta unidades UTF-16. Um emoji pode precisar de duas e um acento combinante acrescenta outra unidade sem criar necessariamente outro grafema. Compare os contadores para identificar qual medida sua aplicação está usando.

Por que duas cadeias de aparência igual diferem?

Elas podem usar uma letra pré-composta ou uma sequência combinante, espaços diferentes ou letras parecidas de outros alfabetos. Verifique os pontos e bytes para localizar a diferença. A ferramenta não normaliza o texto, pois isso poderia apagar a evidência.

Algum resultado precisa de uma explicação melhor?

Investigar uma diferença real

Use o inspetor de caracteres com o menor trecho que reproduz o problema. Guarde a representação que sua aplicação utiliza e compare valores, além da aparência na tela.