Unicode и интернационализация

инспектор символов Unicodeразберите текст на сохранённые значения

Сопоставьте символы, единицы кодирования и байты.

инспектор символов Unicode

Текст или закодированные данные

Предпросмотр вывода

Предпросмотр показывает до 4 000 символов вывода; копирование и скачивание включают весь результат. Текст отображается с экранированными диагностическими метками.

Ввод остаётся в этом браузере и не отправляется на сервер.

Текст: до 10 000 единиц UTF-16. Закодированный ввод: до 200 000 символов, после декодирования — до 10 000 единиц. Точки: U+HEX, 0xHEX или HEX; байты: две цифры HEX, префикс 0x необязателен. Разделяйте пробелами или запятыми. Экранирование и HTML-сущности не разбираются.

Имена: Unicode 17.0.0. Графемы: Intl.Segmenter браузера; API не сообщает версию Unicode, и она может отличаться. Официальные имена и псевдонимы управляющих символов остаются английскими.

Порядок байтов задаётся явно. Начальный U+FEFF сохраняется; BOM не определяется, не удаляется и не добавляется. Нормализации нет. CR/CRLF, полученные без изменений от браузера, сохраняются; поле отображает окончания строк как LF.

Позиции в деталях считаются в единицах UTF-16 от 0, конец не включается. Строка, столбец и байт ошибки считаются от 1; недостающий байт указывает сразу за вводом. Счётчик скаляров не включает одиночные суррогаты.

Введите текст или загрузите пример.
Когда две строки выглядят одинаково, инспектор символов Unicode помогает сравнить их значения. Латинская и кириллическая буквы могут быть похожи, а обычный и неразрывный пробел — практически неразличимы. Точное сравнение строк всё равно обнаружит разницу.

Кодовая точка — лишь одна из мер длины. Комбинируемый знак добавляет точку к букве, не обязательно создавая новую графему. Невидимые символы тоже занимают место. Проверяйте исходную последовательность до нормализации или удаления данных.

Зачем нужен инспектор символов Unicode

Отделить графему от единиц хранения

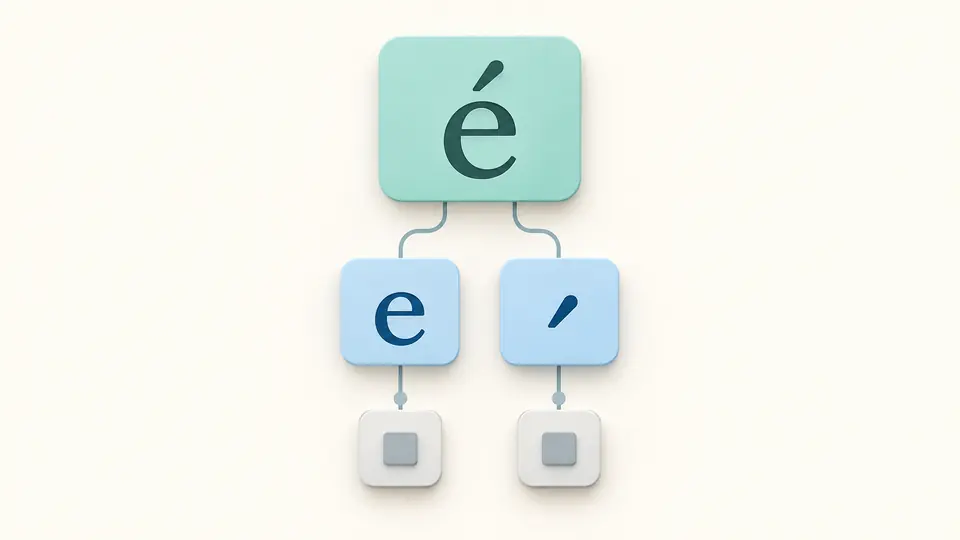
В таких случаях инспектор символов Unicode показывает состав графемы и позиции каждого элемента. Буква с отдельным акцентом может занимать две точки и две единицы UTF-16. Символ за пределами основной плоскости занимает две единицы при одной точке.

Буква с комбинируемым акцентом образует одну графему и разделяется на две точки и единицы.

Проверить обратное преобразование байтов

Вставьте байты UTF-8 из журнала или выберите UTF-16LE/BE либо UTF-32LE/BE. Порядок задаётся явно и не меняется по заголовку. Неверная последовательность вызывает ошибку с позицией вместо молчаливой вставки заменяющего символа.

Символы и группы байтов связаны стрелками в обе стороны без текстовых подписей.

Как прочитать ввод и сохранить результат

01

Указать смысл шестнадцатеричных чисел

Для точек подходят U+0041, 0x41 и 41. Для байтов нужны отдельные двухзначные числа с пробелами или запятыми; 0x допускается. Сплошная длинная строка HEX не принимается как набор байтов. HTML-сущности и escape-последовательности не разбираются.

02

Учитывать обновление и замену

Автопроверка запускается после паузы 250 мс. Без неё используйте кнопку или Ctrl/Cmd+Enter. Если ввод заполнен, Пример и Очистить открывают предпросмотр; Применить подтверждает, отмена замены возвращает прежнее состояние. В пустое поле пример загружается сразу.

03

Выбрать нужный вид выгрузки

По умолчанию выбран JSON. Детали открываются по 50 записей, предпросмотр вывода ограничен 4 000 символами. Копирование и скачивание включают весь результат. Для корректного текста копируются настоящие символы, а не безопасные метки предпросмотра.

Данные для поиска причины расхождений

Имена с известной версией данных

Используется таблица имён Unicode 17.0.0. Псевдонимы управляющих символов отмечены отдельно. Частное использование, несимволы, суррогаты и неназначенные значения различаются по типу; отсутствующее официальное имя не выдумывается.

Позиции для проверки индексов

Диапазоны UTF-16 начинаются с нуля и не включают конечную позицию. Строка, столбец и байт ошибки начинаются с единицы. Скалярные точки и одиночные суррогатные единицы считаются раздельно, поэтому повреждение не скрывается в общем числе.

Представления одной последовательности

Доступны диагностика U+, единицы UTF-16, текст и байты UTF-8/16/32. JSON сохраняет полный анализ. Переключение подробностей между точками и графемами не меняет выбранный формат вывода.

Что сохраняется и что отклоняется

Строгое декодирование скаляров
Значения выше U+10FFFF и суррогаты запрещены в закодированном вводе. UTF-8 отклоняет избыточные и неполные последовательности. UTF-16 требует чётного числа байтов и пар суррогатов; UTF-32 — корректных групп по четыре байта.
Одиночные суррогаты остаются уликой
В текстовом режиме такие единицы можно исследовать, но графемы и экспорт текста или байтов недоступны. JSON, диагностика U+ и единицы UTF-16 остаются копируемыми. Диагностический U+D800 нельзя подать обратно как допустимый скаляр.
Без скрытого изменения текста
Начальный U+FEFF сохраняется. BOM не добавляется и не удаляется; порядок байтов не угадывается. Нормализации, очистки, загрузки файлов, поиска по имени и оценки злонамеренности похожих символов нет.
Пределы ввода и сегментации
Текст ограничен 10 000 единицами UTF-16. Закодированный ввод — 200 000 символами с тем же пределом после декодирования. Превышение отклоняется, а не обрезается. Графемы определяет Intl.Segmenter; его версия Unicode неизвестна. Без API число графем недоступно.

Вопросы: инспектор символов Unicode

Что такое кодовая точка Unicode?

Это числовая позиция в Unicode, обычно записываемая как U+ и шестнадцатеричное число. Она не равна байту или обязательному отдельному изображению. Несколько точек могут составлять одну графему, а одна точка — занимать несколько единиц кодирования.

Чем кодировка UTF-8 отличается от UTF-16?

UTF-8 кодирует скаляр одним–четырьмя байтами. UTF-16 использует одну или две 16-битные единицы, то есть два или четыре байта. Для байтов UTF-16 здесь нужно явно выбрать LE или BE. Это разные представления одних и тех же допустимых значений Unicode.

Можно ли проверить скрытые или невидимые символы?

Да, можно увидеть значения и диагностические метки пробелов, управляющих знаков и других компонентов, которые не дают обычного видимого изображения. Это не универсальная проверка видимости во всех шрифтах и не заключение о безопасности текста.

Показывает ли он имена Unicode?

Да, по данным Unicode 17.0.0. Но официальное имя есть не у каждого значения: для управляющих символов отдельно выводится псевдоним, для частного использования и других специальных случаев — тип. Английское написание официальных имён сохраняется.

Может ли он обрабатывать эмодзи?

Да. Эмодзи могут содержать несколько точек, соединители ZWJ, модификаторы тона и селекторы варианта. Представление графем показывает группировку браузера, а список точек — состав. Отображение картинки зависит от шрифта и не гарантируется анализом.

Нужно подробнее объяснить результат?

Проверить проблемный фрагмент

Для проверки конкретного расхождения откройте инспектор символов Unicode и вставьте минимальный фрагмент. Сохраните полный отчёт или ту последовательность байтов, с которой работает ваша программа.