01
Сохранённый файл полезнее копии текста
Режим файла или Hex показывает реальные байты и смещения неверных UTF-8 последовательностей от нуля. Вставленный Unicode-текст не хранит старые смещения файла.
Unicode и интернационализация
Сравните варианты чтения, сохранив исходный текст и байты.
Введите текст, Hex или выберите файл.
Текст и байты файла обрабатываются только в браузере и не загружаются на сервер.
Ввод или параметры изменились. Ожидается новая проверка.
Варианты остаются гипотезами. Обратимость не доказывает исторический текст.
Задача исправить кракозябры возникает, когда имя в старом файле превращается в «РџСЂ...» или вместо акцента видны чужие символы. Возьмите короткий фрагмент со знакомыми словами и сравните предложения.
Если файл сохранился, передайте его байты. Обычный декодер текста не сможет угадать значения, которые другая программа уже заменила символом �.
Исходные данные остаются отдельно от каждой гипотезы.
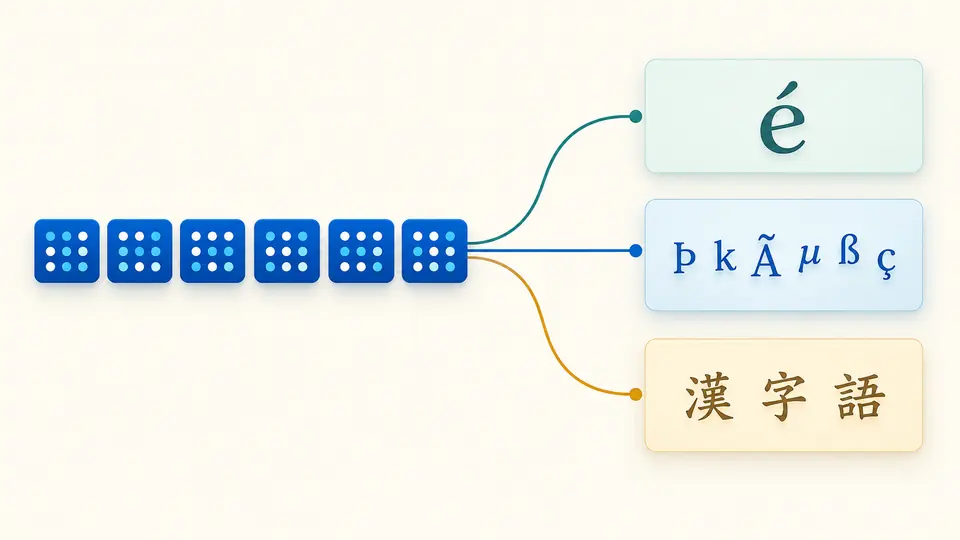
Чтобы исправить кракозябры, инструмент держит байты файла или Hex без изменений и показывает варианты для UTF-8, KOI8-R и других кодировок. Выбор варианта не меняет исходник.
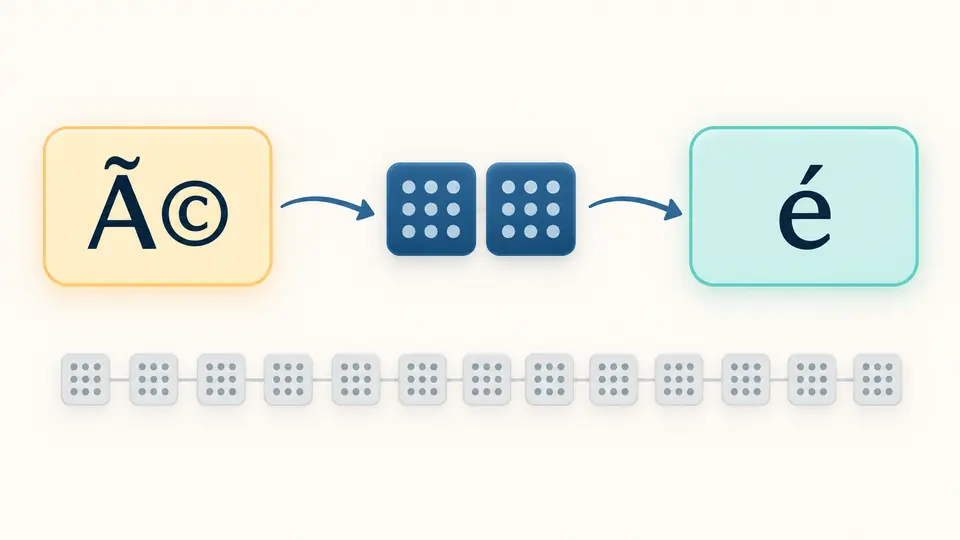
Для вставленного текста символы сначала переводятся обратно в байты согласно ошибочному чтению, а затем читаются в предполагаемой исходной кодировке. Цепочка указана рядом с результатом.
Режим файла или Hex показывает реальные байты и смещения неверных UTF-8 последовательностей от нуля. Вставленный Unicode-текст не хранит старые смещения файла.
«Изначально записано как» означает первую кодировку, а «ошибочно прочитано как» — последующую. Это не конвертер кодировок, который сразу переписывает файл.
Обратимая цепочка не доказывает правильность. После изменения входа копирование старого результата блокируется; сохраняйте только вариант, совпадающий с контекстом.
Кодировка UTF-8 проверяется по исходным байтам: отмечаются неверное начало, продолжение и обрыв последовательности. Для вставленного текста позиция ошибки в прежнем файле не выдумывается.
Можно сравнить западные, кириллические и восточноазиатские прочтения. Если задача — восстановить текст, список гипотез полезнее одного «уверенного» ответа.
Выбранный вариант скачивается новым UTF-8 файлом, а исходные байты — отдельной копией. Ошибочная гипотеза не стирает исходные данные.
На нескольких символах разные кодировки могут давать одинаково правдоподобные результаты. Автоматический порядок лишь помогает начать проверку по смыслу.
Так иногда выглядит метка BOM, если байты UTF-8 прочли в другой кодировке. Откройте исходные байты и проверьте первые позиции, а не удаляйте три видимых знака вслепую.
Нет гарантии. Символ замены не содержит прежнего значения байта. Попробуйте получить исходный файл или более раннюю копию без потери.
Не всегда. Квадрат может означать, что шрифт не содержит нужного глифа. Этот инструмент проверяет кодирование текста, но не подбирает шрифты.
Локальный файл можно прочесть и сохранить выбранное прочтение новым UTF-8 текстом в пределах лимита. Исходник не перезаписывается и смешанные кодировки внутри него не исправляются автоматически.
Не нашли свой случай?
Чтобы исправить кракозябры в этом фрагменте, сравните варианты со знакомыми словами и сохраните исходные байты перед выбором.