01
Préférer le fichier quand il existe
Le mode fichier ou Hex conserve les octets et situe les erreurs UTF-8 par un décalage à partir de zéro. Un texte déjà collé ne donne plus les positions des octets dans le fichier ancien.
Unicode et internationalisation
Examinez plusieurs interprétations tout en conservant le texte et les octets d'origine.
Saisissez du texte, du Hex ou choisissez un fichier.
Le texte et les octets du fichier sont traités dans ce navigateur sans téléversement.
L'entrée ou les réglages ont changé. Nouvelle analyse en attente.
Une proposition reste une hypothèse. La réversibilité ne prouve pas le texte historique.
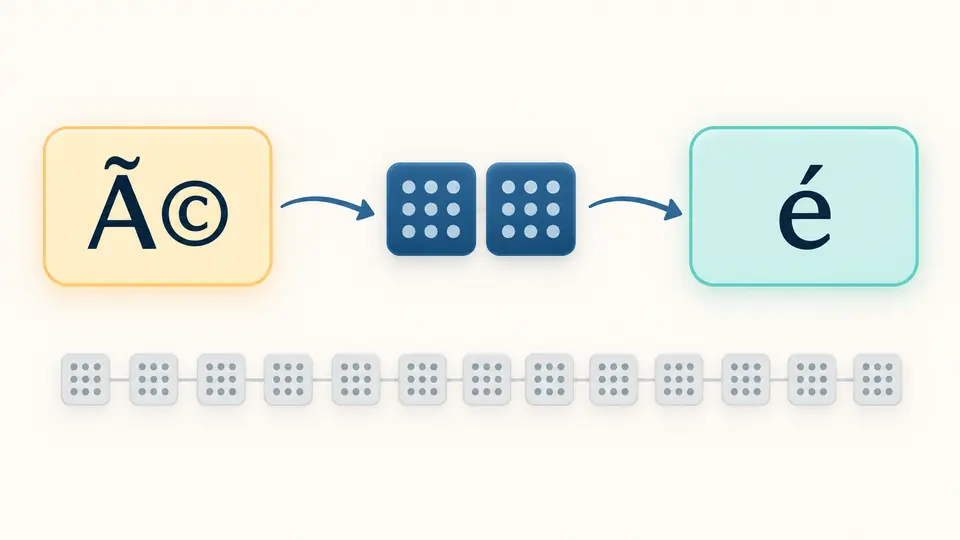
On cherche à réparer le mojibake quand un prénom accentué devient «café» ou qu'une exportation ancienne produit un texte illisible. Commencez par un petit passage dont vous connaissez le sens pour comparer les propositions.
Si le fichier initial existe encore, ses octets sont plus utiles que le texte copié. Un correcteur de mojibake ne peut pas retrouver par déduction des valeurs déjà remplacées par le caractère �.
Les hypothèses restent séparées des données d'origine.
Pour réparer le mojibake, le fichier local ou le code Hex reste intact tandis que plusieurs décodages sont proposés. Le choix d'une proposition ne réécrit jamais les octets sources.
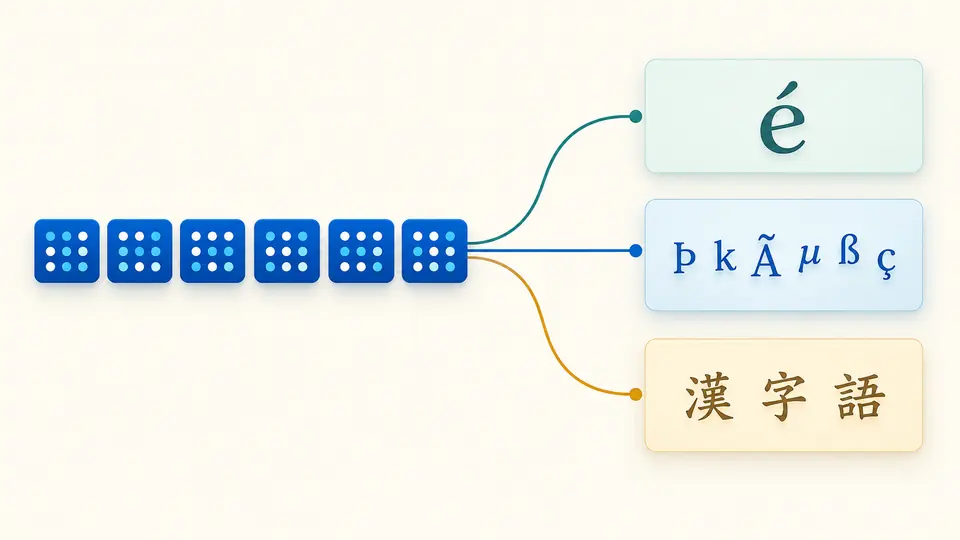
Pour un texte collé, l'outil reconstitue les octets selon le codage utilisé par erreur, puis les relit avec le codage supposé d'origine. Chaque direction apparaît dans la liste.
Le mode fichier ou Hex conserve les octets et situe les erreurs UTF-8 par un décalage à partir de zéro. Un texte déjà collé ne donne plus les positions des octets dans le fichier ancien.
«Écrit initialement en» désigne le codage d'origine; «lu par erreur en» celui qui a produit le texte affiché. Modifier un réglage rend l'ancien résultat impropre à la copie.
Une chaîne réversible peut rester fausse. Comparez noms propres, accents et ponctuation; seuls les résultats fraîchement calculés peuvent être copiés ou enregistrés.
Les séquences tronquées et les octets de début ou de continuation invalides sont situés dans le fichier ou l'entrée Hex. Le texte collé n'a pas de faux décalage d'octet.
Le mode automatique compare notamment les caractères corrompus d'Europe occidentale, du cyrillique et d'Asie de l'Est. Le mode manuel fixe explicitement la chaîne supposée.
L'aperçu choisi devient un nouveau texte UTF-8. Les octets initiaux peuvent être sauvegardés séparément; il ne s'agit pas d'un convertisseur d'encodage qui écrase le fichier.
Non. La liste présente des interprétations possibles, ordonnées provisoirement. Un aller-retour exact ne prouve pas quel codage a réellement servi; vérifiez le contexte.
Le trajet choisi peut être impossible, ou des octets ont peut-être déjà été remplacés par �. Essayez le fichier initial ou une autre direction manuelle.
Il peut lire un fichier local et exporter un nouveau texte UTF-8. Il ne réécrit pas le fichier de départ et ne touche pas aux champs d'une base.
Non. L'analyse et la lecture du fichier restent dans le navigateur. Copier ou télécharger utilise seulement les données sur votre appareil.
Si vous avez les octets, comparez UTF-8 avec les lectures chinoises proposées. Sinon, testez manuellement la chaîne supposée et comparez les mots reconnus dans le contexte.
Un cas manque dans ces réponses ?
Pour réparer le mojibake de ce fragment, confrontez les candidats à des noms connus et conservez les octets de départ avant de choisir.