01
ファイルが残っていれば先に開く
ファイルとHexでは実際のバイトを保持し、UTF-8の不正位置をゼロ起点で示します。文字列の貼り付けから元ファイルのバイト位置は計算できません。
Unicodeと国際化
元データを残したまま、読み方ごとの候補を比較します。
文章、Hex、ファイルを入力してください。
文章とファイルのバイトはこのブラウザー内だけで処理し、送信しません。
入力か設定が変わりました。再診断を待っています。
候補は推測です。往復できても元の文章だとは限りません。
文字化け修復が必要になるのは、昔の文書を開いたら人名や地名が「café」のように崩れたときです。まず正しい表記を知っている短い箇所を探し、候補と照らしてください。
元ファイルがあれば、そのバイトを直接読み込むほうが確実です。貼り付けた文字列だけの文字化け復元では、すでに置換されたバイトを取り戻せません。
推測した結果と、変更していない元の証拠を分けて表示します。
文字化け修復はファイルまたはHexのバイト列を保持し、UTF-8やShift_JISなどで読んだ候補を別々に示します。候補を切り替えても入力は変わりません。
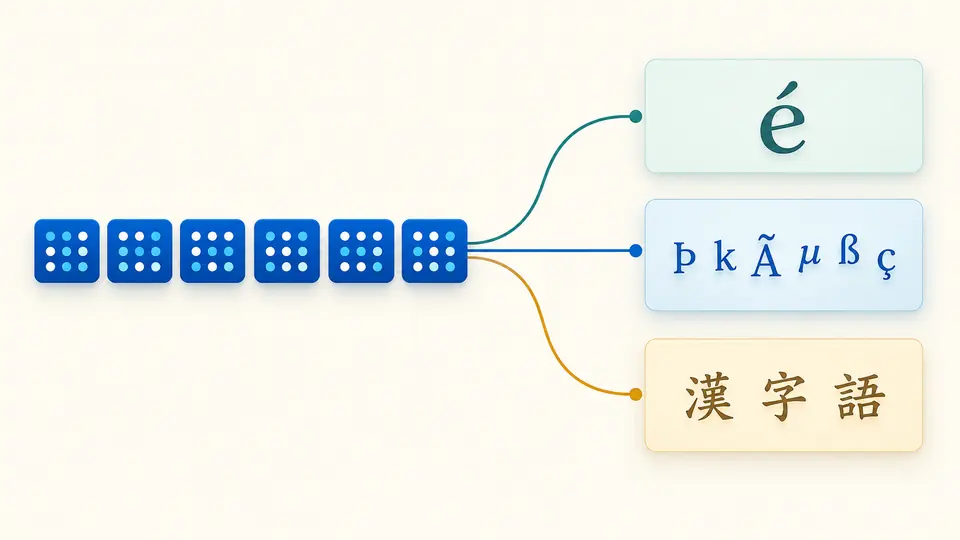
貼り付けた文字は、誤って読まれた文字コードでいったんバイトに戻し、本来のコードで読み直します。どちらを仮定したか表示するので、偶然読めた結果と区別できます。
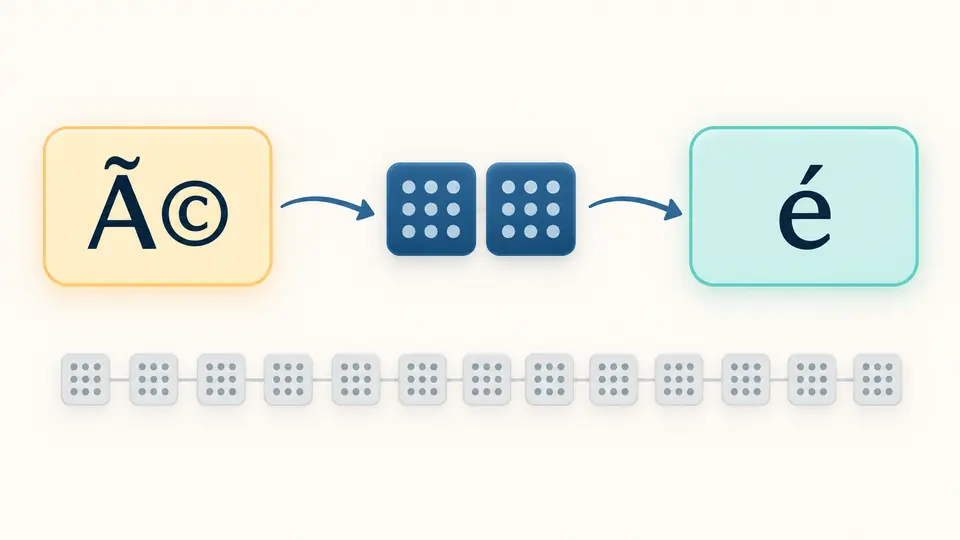
ファイルとHexでは実際のバイトを保持し、UTF-8の不正位置をゼロ起点で示します。文字列の貼り付けから元ファイルのバイト位置は計算できません。
「元の書き込み」は最初の文字コード、「誤って読んだ」は後から使われたコードです。文字コード変換の出力先を指定する欄ではありません。
自動診断は短い待機後に更新され、変更中の古い結果はコピーできません。名前、句読点、固有名詞を確認してから保存してください。
元バイトがある場合、先頭バイト、継続バイト、途中で切れた列を厳密に調べます。UTF-8文字化けの原因を、文字の見た目だけで推測しません。
Shift_JIS文字化けを含む日本語の誤読、欧文のWindows-1252、韓国語や中国語の候補を比較します。どれも正解と断定せず、経路を表示します。
選んだ候補はUTF-8の新しいテキストとして保存します。ファイルの元バイトも別に保存でき、誤った候補を選んでも原本は書き換わりません。
いいえ。候補の並びは読みやすさと指定したコードを手掛かりにしています。短い文字ほど曖昧なので、固有名詞などで確認してください。
直せません。別のソフトが元バイトを�や?に置き換えた場合、その値は貼り付け文字に残っていません。元ファイルを探してください。
同じバイト列を複数の文字コードで読めるためです。可逆な候補がいくつあっても、正しい文脈を持つ候補を選ぶ必要があります。
知っている人名、商品名、句読点を含む箇所で比較してください。判断できなければ結果を上書きせず、元バイトを保管しておいてください。
元はUTF-8のバイトだったのにShift_JISとして読まれた、という過去の誤読経路です。手動欄では「元の書き込み」と「誤って読んだ」を分けます。
判断しにくい例がありますか?