01
タグかヘッダーかを選ぶ
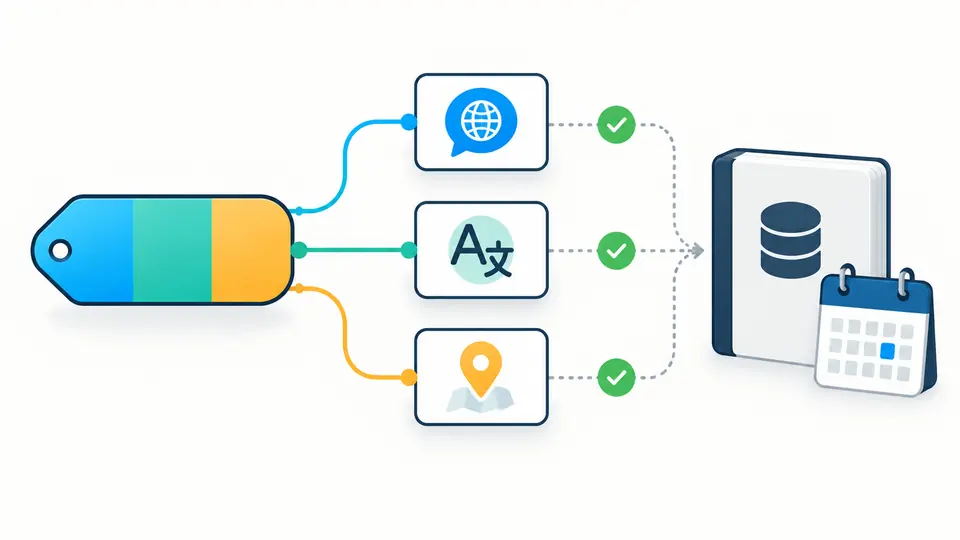
単一タグなら初期モードのまま入力します。Accept-Languageの値やヘッダー名を含む行は専用モードへ。セミコロン付きのq値は単一タグの構文ではありません。
Unicode & i18n
単一タグとAccept-Languageを切り替え、q値をタグの一部として誤判定しません。
解析はこのブラウザー内で行い、入力は送信・保存しません。
解析中…
IANA登録簿の版:…
解析中…
日本語ページのlangを見直すとき、jaとja-JPの違いを説明できるでしょうか。BCP 47言語タグ解析は元の表記を残したまま各サブタグを示し、必要以上の地域指定に気づく手掛かりになります。
言語タグ検証と 言語サブタグ検索を同じ結果で確認できます。ロケールコード正規化の提案は入力を変更せず、Accept-Language q値は別モードで読み取ります。
BCP 47言語タグ解析はzh-Hant-TWを言語・文字体系・地域に分け、IANA登録簿の版の日付と照合します。ブラウザーが受理しただけの未登録コードも区別できます。
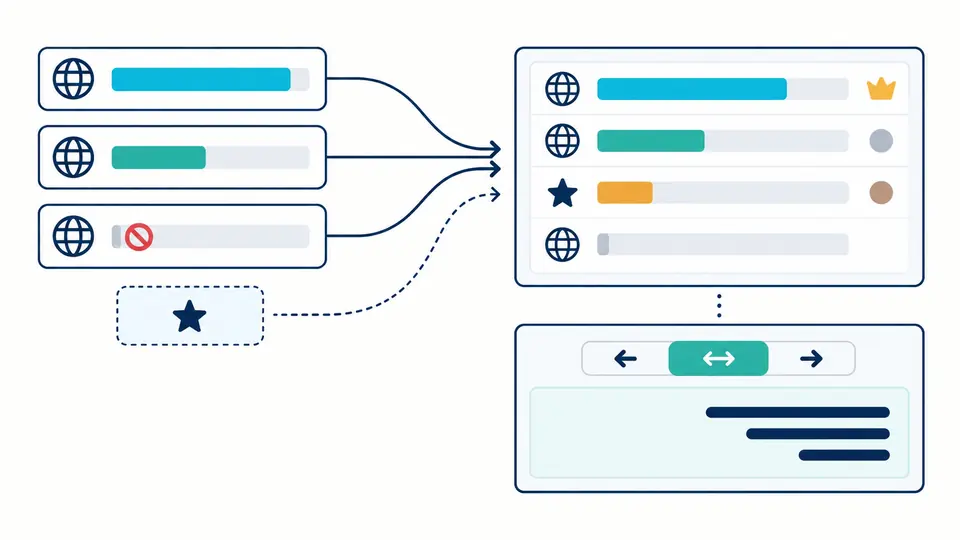
q値のない範囲は1として順位を表示し、同点では入力順を維持します。RTLプレビューの方向はタグから決めず、利用者がauto・左から右・右から左を選びます。
単一タグなら初期モードのまま入力します。Accept-Languageの値やヘッダー名を含む行は専用モードへ。セミコロン付きのq値は単一タグの構文ではありません。
大文字小文字や旧コードの提案は結果にだけ表示され、入力は書き換えません。私用x-タグは構文上有効でも、公開登録簿にその意味はありません。
変更後350ミリ秒で自動解析します。停止した場合は解析ボタンかCtrl/Cmd+Enter。RTLプレビューは実際のテキストの方向を別に選んでください。
言語、拡張言語、文字体系、地域、変種、拡張を分けます。同じ変種や拡張識別子が重複すれば、その位置を示してエラーにします。
IANAのFile-Dateを結果と一緒に示します。廃止されたコードの優先値とブラウザー側の正規形は別々に扱い、版の違いを隠しません。
Accept-Language q値は小数3桁までです。未指定なら1、0なら受け入れ不可として残し、星印は言語タグではなく範囲のワイルドカードとして扱います。
ISO 639-1は主に2文字、ISO 639-2は3文字の言語コードです。BCP 47では登録済みの言語サブタグを使いますが、このページは両規格の任意のコードを変換しません。
Webのlang属性やローカライズ設定で言語を識別する規則です。言語に加え、必要な場合だけ文字体系や地域を加えます。この解析器は各部と登録状態を点検します。
zh-Hansとzh-Hantは文字体系を示し、地域とは別です。地域指定も必要な場合はzh-Hant-TWのように組み合わせ、解析結果で順序を確かめてください。
このページはBCP 47タグの診断に絞っています。ISO、POSIX、ICUの間を一括変換する機能はなく、提案される正規形も入力のタグに限ります。
登録済みの変種サブタグなら表示できます。ただし方言名を自由に入力してコードを生成する機能ではなく、アプリでその方言を提供しているかも判断しません。
誤った解析を見つけましたか?