01
目的に合うモードを選ぶ
一文字列では文字種と対応候補を確認します。比べるべき表記が手元にあるときだけ二文字列へ切り替えます。URLを入れてもサイトにはアクセスしません。
Unicode・国際化
文字種の混在と対応候補を確認し、必要なら基準の表記と比べます。
入力はこのブラウザー内で処理され、送信されません。
Unicode18.0の混同文字と文字種のデータをローカルに収録しています。
スケルトン比較は双方向文字の並べ替えを含みません。正規化は実行環境に依存し、一致は安全性の判定ではありません。
入力が変わりました。再検査すると書き出せます。
ユーザー名や識別子が同じに見えるのに一致しないとき、ホモグリフ検出で実際のコードポイントを調べられます。ラテン文字の列にキリル文字のаが紛れていても、字体だけでは気づきにくいものです。
この同形文字チェックは元の文字列を保存したまま候補を説明します。紛らわしい文字の検出と文字種の混在は別の情報であり、日本語の漢字とかなを危険と決めつけません。
ホモグリフ検出はラテン文字の語に混じったキリル文字を、その位置とコードポイントで示します。文字種の混在は確認のきっかけであり、偽装の証明ではありません。
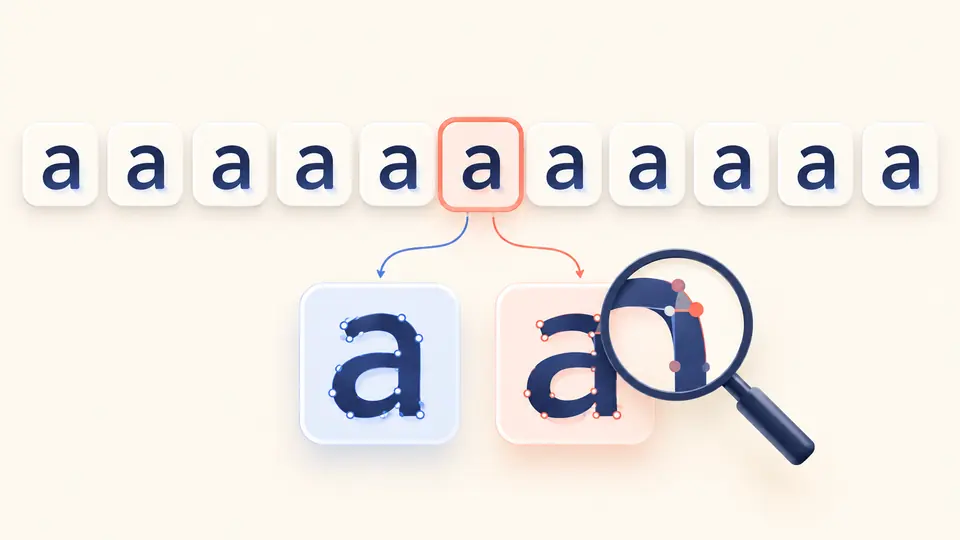
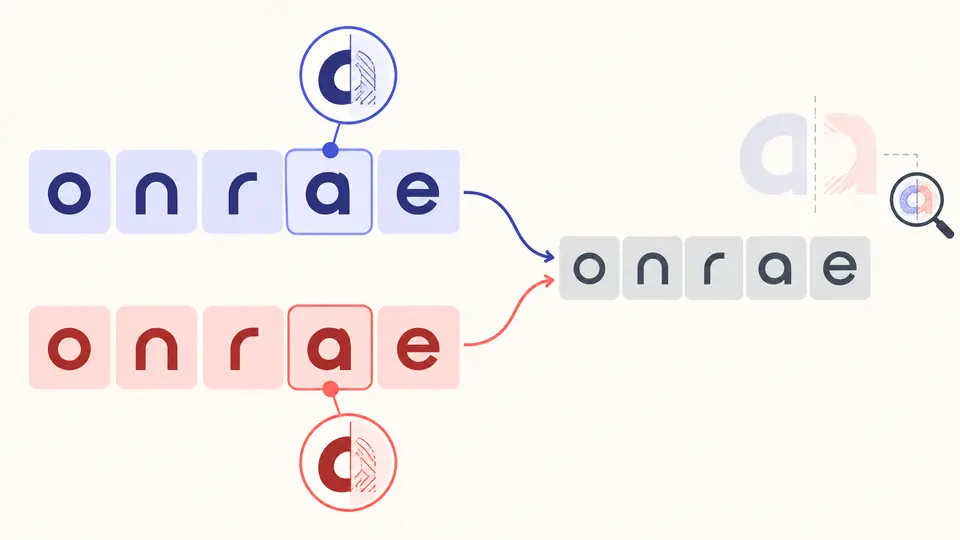
二つの文字列が異なるコードポイントを持ちながら、内部スケルトンでは一致する場合があります。既知の表記と比べた後で各対応を読み、スケルトンを修正済みテキストとして使わないでください。
一文字列では文字種と対応候補を確認します。比べるべき表記が手元にあるときだけ二文字列へ切り替えます。URLを入れてもサイトにはアクセスしません。
自動検査は編集後およそ350ミリ秒待ちます。オフにするとCtrl/Cmd+Enterで実行でき、どちらかの文字列を変えると古い結果の書き出しは無効になります。
対応先が複数のコードポイントになることもあります。元の文字と文字種を先に確かめ、内部スケルトンは比較の手がかりとして扱います。
見た目が似ている文字の候補は、少数のラテン文字とキリル文字だけでなく、版を固定した公式の混同文字表から取得します。 Unicode文字コード調査では、この対応先と元のコードポイントを分けて読みます。
文字種の混在と対応候補は別に報告します。キリル文字だけの語にも候補はあり、日本語の漢字とかなの組合せだけで危険とは表示しません。
文字の詳細は100件ずつ表示します。コピーとJSON保存には、表示範囲を超えるコードポイントと位置も含まれます。
字体によって同じに見える別のコードポイントを指します。ここでは元の文字、文字種、公式表の対応候補を示し、悪意までは判定しません。
同じ形でもラテン文字とキリル文字などは別のコードポイントです。文字ごとの一覧で両者を確認してください。
文字種属性とU+番号を見てください。ラテンのaはU+0061、キリルのаはU+0430で、混在した位置も表示します。
はい。逐字の詳細にUnicodeコードポイントとUTF-16位置を示します。見た目の似方だけでなく保存された値を確かめられます。
いいえ。漢字とかなは普通の日本語で併用されます。複数の文字種があることだけを危険の証拠にはしません。
調べたい文字が見つかりませんか?