01
Choisir la portée
Une seule chaîne suffit pour examiner les scripts et candidats. La seconde sert uniquement si vous disposez d'une graphie de référence; coller une URL ne déclenche aucun accès au site.
Unicode et internationalisation
Examinez les écritures, les correspondances et, si besoin, une graphie de référence.
Le texte reste dans ce navigateur et n'est pas envoyé.
Les tables Unicode 18 des caractères confondables et des écritures sont intégrées localement.
Le squelette ne réordonne pas les textes bidirectionnels; la normalisation dépend du navigateur. Une correspondance ne prouve aucun danger.
Le texte a changé. Relancez l'analyse avant d'exporter.
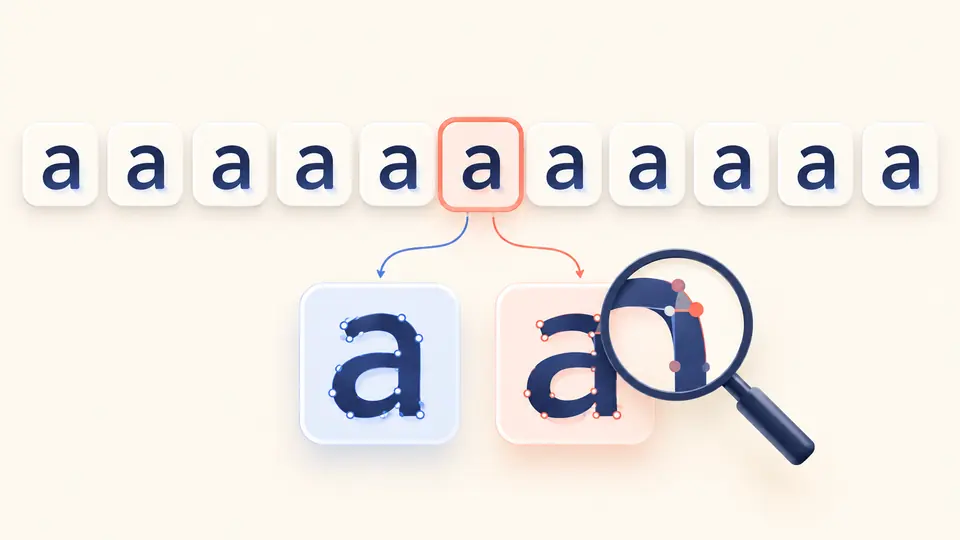
Quand un identifiant semble correct mais échoue à une comparaison exacte, le détecteur d'homoglyphes révèle les points de code réels. Un а cyrillique glissé parmi des lettres latines peut passer inaperçu selon la police.
Cet outil repère des caractères confondables sans réécrire l'original. Les caractères Unicode similaires et les écritures mixtes sont deux indices distincts; une langue écrite avec plusieurs systèmes n'est pas automatiquement suspecte.
Le détecteur d'homoglyphes situe une lettre cyrillique au milieu d'un nom latin et donne son point de code. Le mélange invite à vérifier, sans prouver une usurpation.
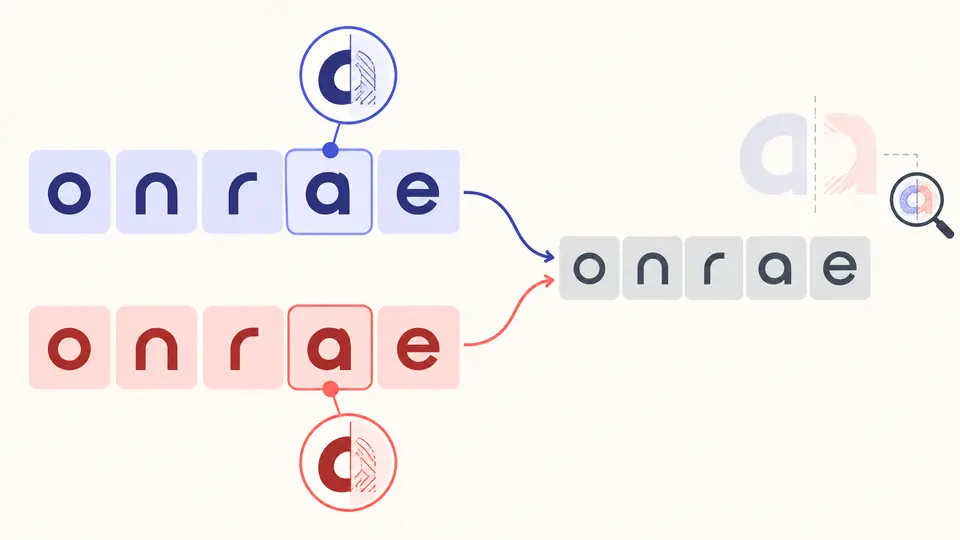
Deux chaînes différentes peuvent partager un squelette interne. Renseignez une graphie de référence, puis inspectez chaque association; ce squelette n'est pas une version corrigée à publier.
Une seule chaîne suffit pour examiner les scripts et candidats. La seconde sert uniquement si vous disposez d'une graphie de référence; coller une URL ne déclenche aucun accès au site.
L'analyse automatique attend environ 350 ms après une modification. Si vous la coupez, Ctrl/Cmd+Entrée lance l'analyse. Toute édition bloque l'export de l'ancien rapport.
Une association peut comporter plusieurs caractères et une lettre étrangère peut être normale. Lisez l'original, l'écriture et le contexte avant le résultat du squelette.
Les homoglyphes Unicode proviennent de la table officielle complète, y compris les associations vers plusieurs points de code, plutôt que d'une petite liste latin-cyrillique.
Une ligne entièrement cyrillique peut contenir des caractères confondables sans mélanger les écritures. Une phrase bilingue peut au contraire mélanger les écritures sans intention trompeuse.
La liste s'allonge par lots de 100. La copie et le JSON conservent chaque caractère, sa position UTF-16, son écriture et son prototype.
Un caractère candidat possède une association vers un prototype visuellement proche dans les données Unicode. L'apparence dépend de la police; le rapport ne juge pas l'intention.
Rien n'est corrigé ici. La table fournit une valeur de comparaison et le texte d'origine demeure intact, y compris dans le rapport exporté.
Une ligne seulement cyrillique ou grecque n'est pas mélangée. Elle peut néanmoins contenir des candidats; le rapport distingue les deux cas.
La table Unicode 18 complète est utilisée, mais elle ne garantit pas toutes les ressemblances possibles dans toutes les polices et tous les contextes.
Non. L'analyse se fait dans votre navigateur. La copie ou le téléchargement du rapport dépend uniquement de votre action.
Une association mérite une explication ?
Utilisez le détecteur d'homoglyphes sur un nom court, ajoutez une référence connue si nécessaire et jugez à partir des points de code et du contexte.