01
按任务选择模式
单串模式检查文字系统与候选;只有手头有可信拼写时才切到双串比较。输入网址也只是逐字分析,不会打开网页。
Unicode / 国际化
检查混合文字、映射候选,或与指定的参照文字比较。
文字仅在此浏览器中处理,不会上传。
本地内置 Unicode 18.0 相似字符和文字系统数据。
骨架比较不含双向文字重排;归一化由浏览器运行环境完成。匹配不是安全结论。
输入已更改,请等待自动检查或手动运行。
用户名、代码标识符或网址看起来一模一样,却无法精确匹配时,可以用 Unicode 混淆字符检测查看实际码点。一个西里尔字母 а 混进拉丁拼写,肉眼常常很难发现。
这里做相似字符检查,不假设外文是错误。结果把混合字符检测与映射候选分开展示;只有你提供参照串,才会比较内部骨架。
Unicode 混淆字符检测会标出拉丁拼写里出现的西里尔字母,并给出原字符和偏移量。混合文字只提示复核,不能据此断定有人冒充。
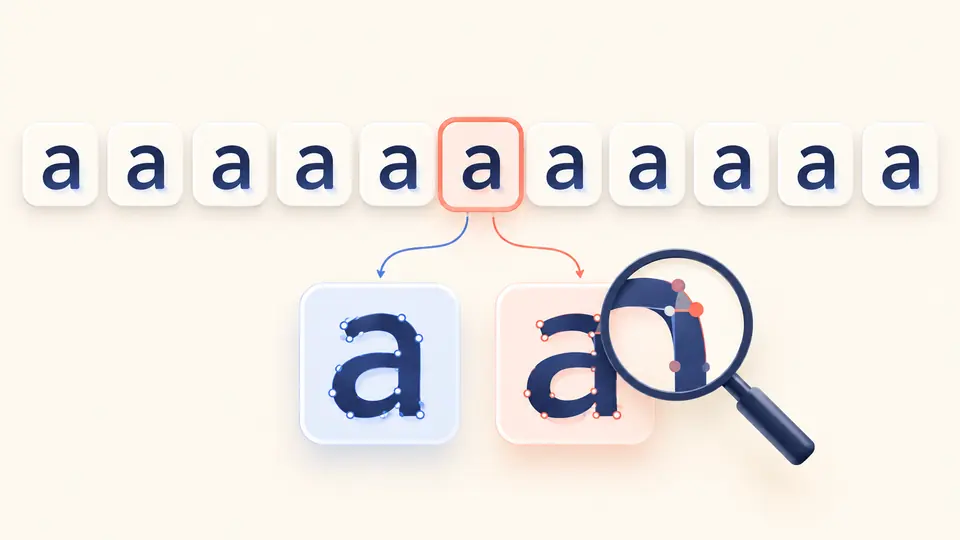
两串文字的码点不同,内部骨架却可能相同。输入已知名称后查看骨架关系,再逐字检查映射;不要把骨架当成可直接替换的正确文本。
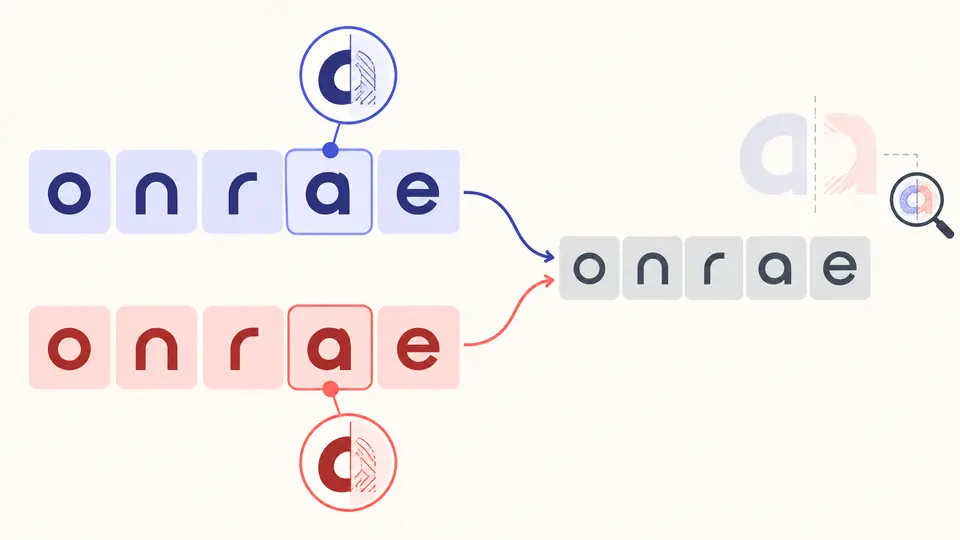
单串模式检查文字系统与候选;只有手头有可信拼写时才切到双串比较。输入网址也只是逐字分析,不会打开网页。
自动模式在输入停顿约 350 毫秒后运行。关掉后可用 Ctrl/Cmd+Enter 手动检查;修改任一串会立即停用旧报告的复制和下载。
映射目标可能包含多个字符,且相似字也可能是正常外文。先读原字符、文字系统和码点,再参考骨架是否相同。
相似字符检查依据完整的 Unicode 18.0 混淆映射,而不是只列几对拉丁和西里尔字母;部分目标会展开成多个码点。 Unicode 码点检查时,可同时核对原字符与映射目标。
同形异码字可以出现在单一文字系统中;正常的中英文文字也会包含多种文字系统。报告分别列出映射候选和混合提示。
逐字详情一次显示 100 条,避免长文本撑满页面。复制与下载仍包含完整字符、UTF-16 偏移量、脚本和映射。
外观一致不代表码点相同。检查逐字列表中的 Unicode 码点、文字系统和映射目标,就能找到不匹配的位置。
逐字查看 Script 属性即可。拉丁 a 为 U+0061,西里尔 а 为 U+0430;如果混在一起,报告还会给出混合文字提示。
它们的码点不同。部分全角字符会有 Unicode 混淆映射,但本工具只报告候选,不把原文自动变为半角。
不一定。中文、英文混用可能完全正常。混合字符检测只指出文字系统差异,是否合适要结合实际内容判断。
不会。检查和骨架比较都是只读的;示例或清空覆盖现有输入之前会先给预览,并可撤销一次。
有需要补充说明的字符吗?