01
有原文件就不要先复制成文字
文件与 Hex 模式会保留字节,并报告从零开始的 UTF-8 错误偏移。已粘贴的 Unicode 字符串不能提供原文件的字节位置。
Unicode 与国际化
比较不同解码结果,保留可回看的原始内容。
输入文字、粘贴 Hex 或选择文件。
文字和文件字节只在此浏览器中处理,不会上传。
输入或参数已改变,等待重新诊断。
候选只是推测;链路可逆不等于找到历史原文。
乱码修复常发生在打开旧文件之后:姓名变成奇怪的拉丁字符,或一段中文看似完全无关。先截取有上下文的一小段,再比较候选中的人名、标点和专有词。
如果原文件还在,优先使用文件或十六进制输入。仅凭复制出来的文字做乱码还原,已经看不到先前被替换的字节;原始字节能让你重新选择读取编码。
把原始证据与猜测结果分开放,避免一次错误选择毁掉线索。
乱码修复会保留本地文件或 Hex 的原始字节,再分别预览 UTF-8、GBK 等解码结果。候选只供核对,不会改写文件;还可单独下载原字节。
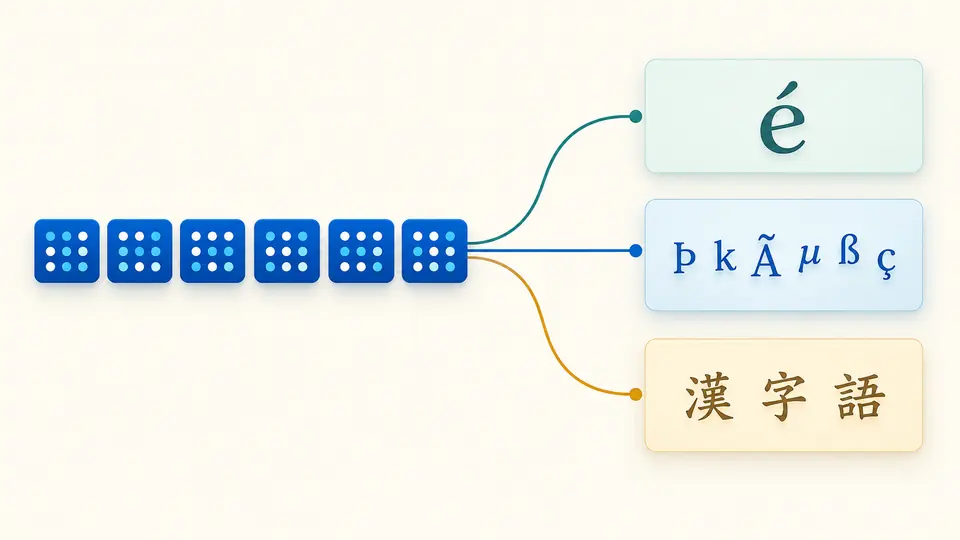
对已显示成乱码的文本,工具先按误读时的编码还原字节,再按原本写入的编码读取。像 café 这样的片段会列出假设的链路,而不是只给一个神秘答案。
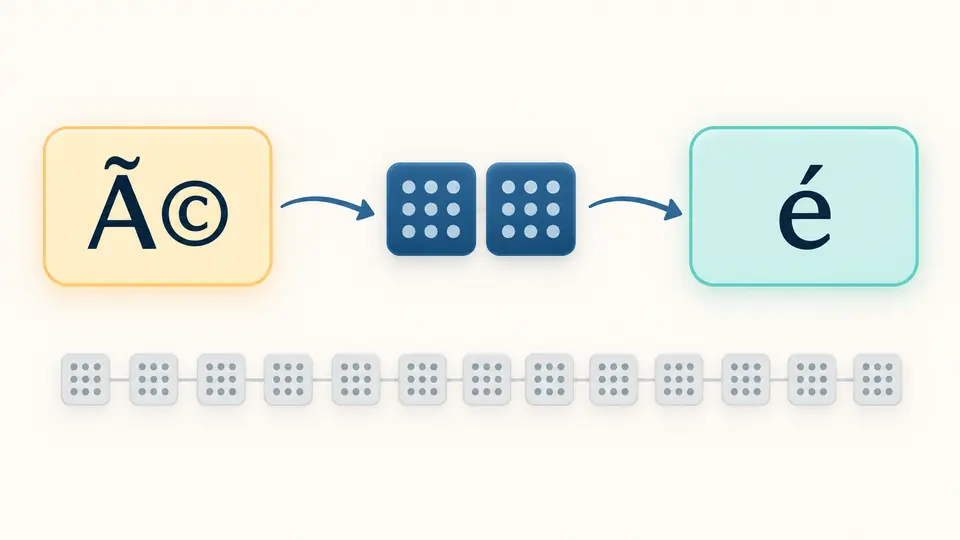
文件与 Hex 模式会保留字节,并报告从零开始的 UTF-8 错误偏移。已粘贴的 Unicode 字符串不能提供原文件的字节位置。
“原本写成”指文件当初的编码,“错误读成”指后来误用的编码;自动模式只是按可读性排序。改动选项后,旧结果会立即失效。
检查姓名、地名和标点,再复制或另存结果。候选可逆只说明这条链能往返,并不保证它就是历史上实际发生的转换。
文件或 Hex 输入会严格检查 UTF-8 结构,标出无效起始字节、续字节及截断序列的位置。粘贴文字不会伪造原文件的字节偏移。
分别尝试西欧、西里尔及常见东亚编码;手动模式可指定原本编码与误读编码。遇到 UTF-8 乱码,也能回到具体链路而非盲目替换字符。
切换候选只改变右侧预览。可将选中结果另存为 UTF-8 文本,也能另存原始字节,方便与来源文件对照。
若原文件仍在,先用文件模式保留字节,比较候选中的常见词和标点;若只有粘贴文本,可尝试误读链,但无法保证覆盖全部损坏。
它通常只表明候选按同一链路再编码后能复现当前输入,不证明文字含义正确。本页将可逆性作为提示,仍需你检查语境。
当错误解码已经把不同字节都变成 � 或问号,原信息就不在粘贴文本里了。需要重新取得原文件或更早的备份。
不能。混合编码、多次转换、字体缺字和二进制文件损坏不是同一种问题;本工具只给可验证的文本解码候选。
原始字节可按 UTF-8、西欧、西里尔及常见东亚编码预览。导出只生成 UTF-8 文本;本页不提供旧编码写回,也不替你修改数据库。
还有不能判断的片段?