01
Prioriza el archivo original
Archivo y Hex conservan bytes reales y marcan errores UTF-8 con desplazamientos desde cero. Un texto pegado no conserva la posición de los bytes inválidos del archivo.
Unicode e internacionalización
Compara lecturas sin modificar el texto ni los bytes originales.
Introduce texto, pega Hex o elige un archivo.
El texto y los bytes del archivo se procesan en este navegador; no se suben.
Cambió la entrada o la configuración. Esperando un análisis nuevo.
Cada opción es una hipótesis. La reversibilidad no prueba cuál era el texto original.
Necesitas reparar caracteres corruptos cuando un nombre con tilde se convierte en «café» o un archivo antiguo muestra texto ilegible. Empieza por una frase corta con palabras conocidas.
Si conservas el archivo, abre sus bytes en vez de copiar solo el resultado dañado. Al arreglar caracteres raros desde texto pegado, los valores sustituidos por otra aplicación pueden haberse perdido.
Las pruebas originales permanecen separadas de cada interpretación.
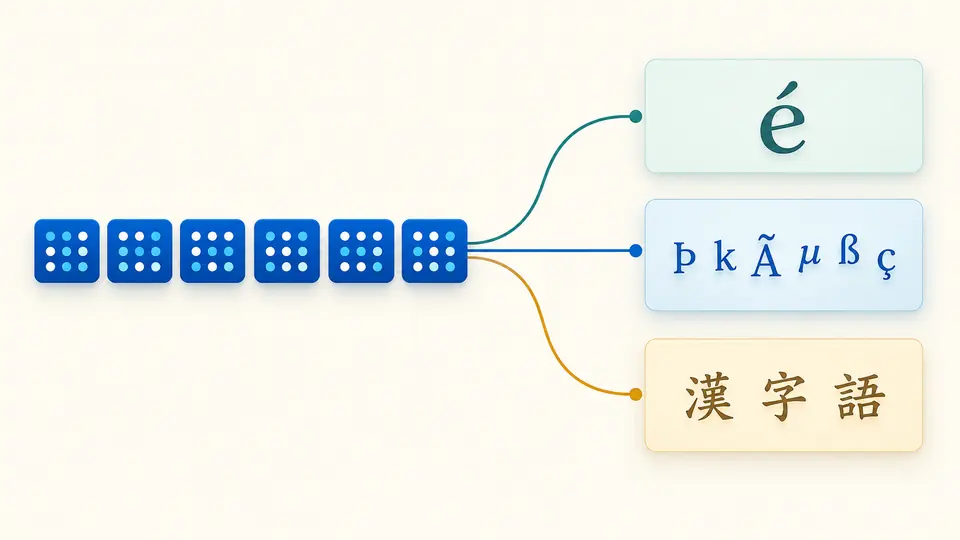
Al reparar caracteres corruptos, el archivo o la secuencia Hex no cambia. El panel muestra vistas independientes con UTF-8, GBK y otros decodificadores; elegir una no altera la fuente.
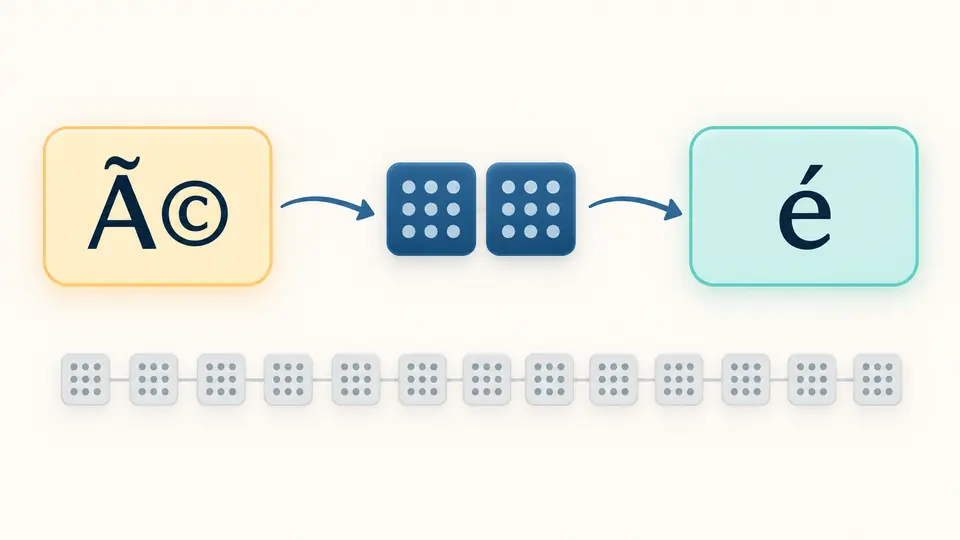
Para texto pegado se invierte la lectura incorrecta para reconstruir bytes y después decodificarlos con la codificación supuesta original. La ruta aparece junto al resultado.
Archivo y Hex conservan bytes reales y marcan errores UTF-8 con desplazamientos desde cero. Un texto pegado no conserva la posición de los bytes inválidos del archivo.
«Escrito originalmente como» es la codificación inicial y «leído por error como» es la interpretación posterior. Cambiar cualquiera invalida la exportación anterior.
Una ruta reversible no garantiza que sea correcta. Contrasta acentos, nombres y puntuación; copia o descarga únicamente el cálculo actualizado.
Sobre bytes de archivo o Hex se localizan inicios, continuaciones y secuencias truncadas. Sirve para investigar la codificación UTF-8 sin inventar posiciones en texto pegado.
Se comparan lecturas occidentales, cirílicas y de Asia oriental. Un corrector mojibake puede proponer varias rutas sin presentar la primera como certeza.
El texto elegido se guarda en un archivo UTF-8 nuevo. Los bytes iniciales pueden descargarse aparte para repetir el diagnóstico sin perder evidencia.
Aparece cuando bytes escritos con una codificación se leen usando otra. La misma secuencia puede representar letras distintas según el decodificador.
No. Si los bytes se perdieron al convertirse en � o ?, una propuesta puede no recuperar el original. Comprueba el archivo fuente.
Un archivo UTF-8 japonés abierto como Shift_JIS puede producir caracteres sin sentido. La ruta manual permite probar esa lectura, pero verifica el contexto.
Conserva el archivo si existe y compara UTF-8, GBK y Big5. Si solo queda texto pegado, prueba la dirección manual y palabras conocidas.
Una parte puede haber sufrido otra conversión o contener signos de reemplazo. Trabaja por fragmentos y busca una copia anterior con bytes.
¿Falta un caso que te preocupa?
Para reparar caracteres corruptos en este fragmento, compara las opciones con el contexto y conserva los bytes antes de guardar una interpretación.